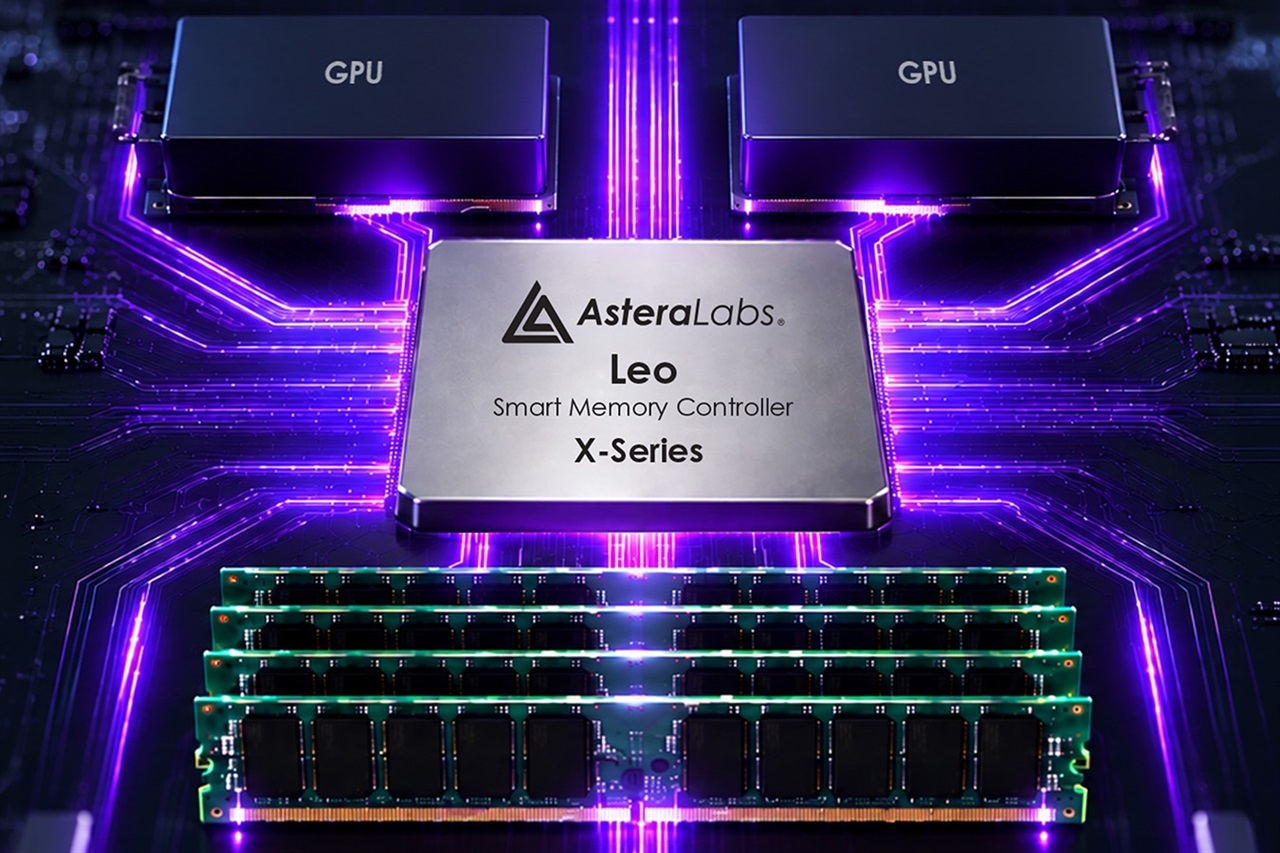
Astera Labs ha messo nel mirino un problema che molti deployment di LLM scoprono quando passano dalla sperimentazione all'uso operativo: la cache KV. Nei modelli transformer, questa struttura conserva per ogni token le rappresentazioni intermedie necessarie all'attenzione. Con contesti più lunghi e carichi di lavoro agentici, il numero di token cresce rapidamente e la cache finisce per consumare una quota significativa della VRAM disponibile sulle GPU. Non è un dettaglio implementativo: è un vincolo fisico che incide su quanti job possono girare in parallelo, sulla latenza e sul TCO dell'infrastruttura.
La scelta di Astera Labs di concentrarsi su questo collo di bottiglia dice molto su come il settore sta rivedendo le priorità. Per anni l'hardware per l'AI è stato raccontato soprattutto in termini di potenza di calcolo e throughput dei core. Ma i carichi agentici, che concatenano più chiamate e mantengono uno stato condiviso, spostano la pressione verso la memoria e le interconnessioni. Quando la VRAM si esaurisce, le opzioni sono poche: ridurre la precisione con la quantization, limitare la lunghezza del contesto o spostare parti della cache fuori dalla GPU. Ognuna di queste strade introduce compromessi su qualità, latenza o complessità.
L'interesse di Astera Labs per questo specifico collo di bottiglia segnala che il problema non si risolve solo aggiungendo più GPU. Serve una gerarchia di memoria più ampia e coerente, in cui la cache KV possa vivere oltre i limiti della VRAM locale senza rendere l'inference inutilizzabile. Questo ha implicazioni dirette per chi fa deployment on-premise o self-hosted. Un'infrastruttura che tiene i dati in locale deve essere dimensionata non solo sul picco di calcolo, ma anche sul comportamento della memoria in scenari multi-turno e multi-agente. I costi, poi, non sono solo CapEx: la scelta di quanta memoria tenere vicino alla GPU e quanta gestirne via rete determina consumi, dissipazione e complessità operativa.
In termini strategici, la mossa di Astera Labs rafforza un messaggio: la prossima generazione di infrastrutture per LLM non sarà vinta da chi ha il chip più veloce, ma da chi controlla meglio il movimento dei dati. Chi fornisce soluzioni di memoria e connettività può ritagliarsi un ruolo centrale, mentre i fornitori focalizzati solo sul calcolo rischiano di perdere rilevanza man mano che il vincolo si sposta. Per le organizzazioni che valutano stack locali, questo significa che i criteri di scelta devono includere il comportamento della cache KV e la flessibilità della memoria, non solo i benchmark di picco. AI-RADAR dedica spazi di analisi su /llm-onpremise per chi vuole esplorare questi trade-off senza scorciatoie.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!