AI-Radar - Osservatorio su LLM locali, hardware AI e trend

AI-Radar per LLM on-prem & AI in casa

Il radar quotidiano su modelli, framework e hardware per far girare l'AI in locale. LLM, LangChain, Chroma, mini-PC e tutto ciò che serve per un cervello distribuito "in-house".

⚙️ Stack: LLM locali · LangChain · Transformers · ChromaDB · MiniPC · AI boxes
🛰️ Ask Observatory (Q&A + RAG) già collegato all'archivio articoli.
👥 160+ membri · Iscriviti gratis →

⚡ In Tendenza

View All →

🛠️ Guide & Osservatorio On-Premise

🚀 Esegui i modelli in locale → Tutte le guide →

Riferimenti evergreen e pratici per far girare l'AI in locale — hardware, costi, privacy e stack completo.

🖥️ Osservatorio LLM On-Premise Hardware, stack, governance e architetture di riferimento per l'AI in locale. →

Ultime analisi & news dal radar

Articoli generati dall'AI sulla base dei feed, con spazio per layer editoriale umano sopra il contenuto grezzo.

Nvidia e CPU Vera: il 39% di prestazioni nascoste si sblocca via software
📁 Hardware AI generated ℹ️ Tom's Hardware

Nvidia e CPU Vera: il 39% di prestazioni nascoste si sblocca via software

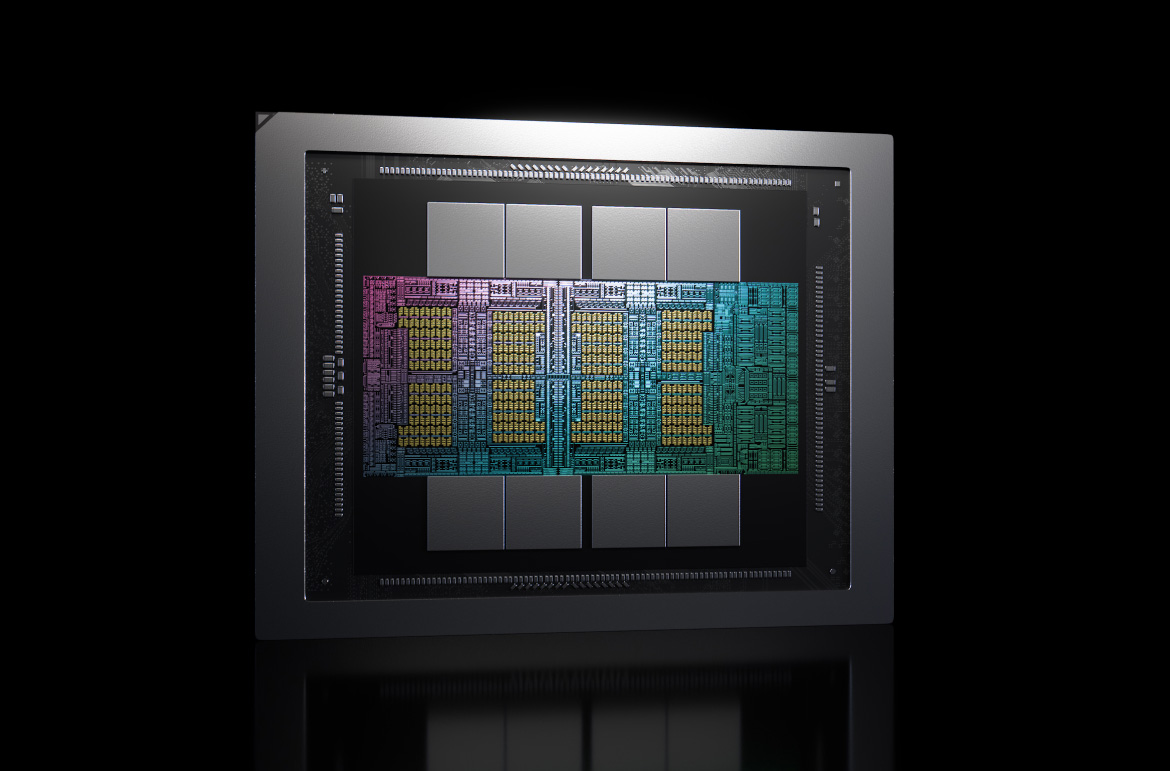
A SC26 Nvidia sostiene che la CPU Vera può guadagnare fino al 39% solo con ottimizzazioni software. I core Olympus personalizzati, però, richiedono una messa a punto architetturale per liberare l'intero potenziale. Per chi gestisce infrastrutture locali, il dato cambia il modo di leggere TCO e cicli di aggiornamento dell'hardware.
2026-11-17 📰 Fonte
NVIDIA porta Rubin nel calcolo scientifico: GPU HPC in arrivo nel 2028
📁 Hardware AI generated ✅ ServeTheHome

NVIDIA porta Rubin nel calcolo scientifico: GPU HPC in arrivo nel 2028

Al SC26 NVIDIA ha annunciato Rubin HPC, una GPU server pensata per scienza e ingegneria con oltre 50.000 CUDA core. Il debutto è previsto per il 2028 e segna il ritorno dell'azienda nel mercato HPC. L'articolo analizza le implicazioni per i carichi di calcolo on-premise e per l'ecosistema.

2026-11-17 📰 Fonte
Intel D270: 5,9x su FP64 e latenza più bassa nell'inference AI
📁 Hardware AI generated ℹ️ LocalLLaMA

Intel D270: 5,9x su FP64 e latenza più bassa nell'inference AI

Intel ha pubblicato i primi benchmark della GPU Crescent Island D270. Sul fronte FP64 rivendica un throughput 5,9 volte superiore alla RTX PRO 6000. Nei benchmark AI mostra latenza inferiore del 29% e throughput di 1,12x rispetto alla controparte NVIDIA. Numeri preliminari ma rilevanti per chi valuta GPU per inference locale e carichi on-premise.

2026-11-17 📰 Fonte
OVH annuncia Olala Mini 7A1B: un LLM open source da 8 GB di VRAM
📁 LLM AI generated ℹ️ LocalLLaMA

OVH annuncia Olala Mini 7A1B: un LLM open source da 8 GB di VRAM

OVH ha presentato Olala Mini, un LLM open source da 7 miliardi di parametri con 1 miliardo di attivi, capace di girare su GPU da 8 GB e anche su CPU. L'architettura MoE usa solo una frazione del modello per richiesta, raggiunge 160 token/s su RTX A4500 e 50 su processore standard, con contesto da 32.000 token. Licenza Apache 2.0 e disponibilità su Hugging Face.

2026-11-17 📰 Fonte
Intel D270 e open source: un segnale per chi fa self-hosting
📁 Hardware AI generated ✅ Phoronix

Intel D270 e open source: un segnale per chi fa self-hosting

L'annuncio della GPU D270 a Supercomputing 2026 non offre specifiche ma sposta l'attenzione sul software open source. AI-Radar analizza le implicazioni per deployment self-hosted, TCO e sovranità dei dati: prestazioni da verificare, driver e runtime da osservare, apertura come leva competitiva contro stack proprietari. Il messaggio è direzionale più che tecnico.

2026-11-17 📰 Fonte
Maxwell-V1-Flash: 35B totali, 3B attivi e contesto a 256K token
📁 LLM AI generated ℹ️ LocalLLaMA

Maxwell-V1-Flash: 35B totali, 3B attivi e contesto a 256K token

Il team Maxwell ha pubblicato Maxwell-V1-Flash, un LLM MoE con 35 miliardi di parametri totali e 3 miliardi attivi per token. Punta su attenzione block-sparse, contesto fino a 256K token e capacità agentiche, riducendo il costo pratico dell'inference. L'architettura combina Mixture-of-Experts fine-grained, iper-connessioni vincolate e un indexer appreso per i blocchi remoti.

2026-11-17 📰 Fonte
Loom 0.2 di AMD: più C++ e targeting migliore per gli agenti AI
📁 Frameworks AI generated ✅ Phoronix

Loom 0.2 di AMD: più C++ e targeting migliore per gli agenti AI

AMD ha rilasciato oggi Loom 0.2 all'interno di ROCm HRX, aggiornando compilatore, runtime e infrastruttura di serving per i workflow degli agenti AI. La nuova versione estende il supporto C++ e migliora il targeting. L'aggiornamento interessa soprattutto chi sviluppa stack AI su hardware AMD e cerca integrazione con codebase C++ esistenti e un controllo più fine della generazione di codice per carichi agentici.

2026-11-17 📰 Fonte
TokenEconomizer: un plugin open source per tagliare i token degli agenti di coding
📁 Frameworks AI generated 🏆 Microsoft Research

TokenEconomizer: un plugin open source per tagliare i token degli agenti di coding

Un plugin open source di UC Berkeley e Microsoft Research riduce il consumo di token degli agenti di coding dal 18,4 al 30,9% su 277 task reali, senza toccare modelli o agenti. Impara dalle sessioni passate del repository, pota gli strumenti inutilizzati e interviene sui loop di errore. La conoscenza resta sulla macchina dello sviluppatore e il plugin non richiede una propria API key.

2026-11-16 📰 Fonte
Intel punta sulla GPU D270 tra prestazioni e software open source
📁 Hardware AI generated ✅ Phoronix

Intel punta sulla GPU D270 tra prestazioni e software open source

Durante la settimana di Supercomputing 2026, Intel ha acceso i riflettori sulla GPU D Series 'Crescent Island' basata su Xe3P, sottolineando prestazioni e supporto software open source. Un segnale per chi valuta hardware self-hosted, anche se i dettagli tecnici restano da chiarire.

2026-11-16 📰 Fonte
Audio open weight: la sfida non è il suono, è la produzione
📁 LLM AI generated ℹ️ LocalLLaMA

Audio open weight: la sfida non è il suono, è la produzione

Una megathread chiede modelli ASR, TTS, STT e text-to-music open weight. Il punto strutturale è il divario tra demo brevi e casi produttivi con requisiti di stabilità e lunghezza. Servono confronti empirici reali, non benchmark selezionati.

2026-11-16 📰 Fonte
Omaxian: il look di Omarchy su X11, Devuan e i3
📁 Altro AI generated ✅ The Register AI

Omaxian: il look di Omarchy su X11, Devuan e i3

Omaxian OS 0.1 è una distribuzione Linux desktop che mescola estetica Omarchy, base Devuan 6, window manager i3 e server X11 XLibre. Offre anche una shell per Debian. Niente Wayland né systemd: un ambiente tiling per power user, con supporto opzionale agli LLM. La grafica in VirtualBox è instabile, ma Xfce resta installato come alternativa. La combinazione di progetti controversi allontanerà alcuni, ma segnala una domanda di ambienti locali radicalmente alternativi.

2026-11-16 📰 Fonte
Rifiuto come LoRA: l'abliteration diventa un layer runtime per LLM self-hosted
📁 OnPremise AI generated ℹ️ LocalLLaMA

Rifiuto come LoRA: l'abliteration diventa un layer runtime per LLM self-hosted

Un post su Reddit mostra come per Qwen3.8-Flash-Next la direzione del rifiuto, in gran parte rank-1, si comprima in un piccolo LoRA applicabile a runtime sulla quantization già presente su disco. Il server llama.cpp lo attiva solo per singola richiesta, separando il comportamento di rifiuto dai pesi del modello. Il risultato riduce storage e TCO nei deployment self-hosted e apre questioni di governance e audit.

2026-11-16 📰 Fonte
Fine-tuning specializzato: un modello da 4B può bastare per molti compiti pratici
📁 LLM AI generated ℹ️ LocalLLaMA

Fine-tuning specializzato: un modello da 4B può bastare per molti compiti pratici

Esperimenti indipendenti con modelli da 4B e 350M mostrano che dataset di qualità ed epoche prolungate possono contare più della scala. Il fine-tuning completo su GPU consumer da 8GB apre a team piccoli la strada verso modelli specializzati per 3D, coding e altri domini, riducendo costi complessivi e dipendenza dal cloud.

2026-11-16 📰 Fonte
Poesia infinita con gli LLM: il limite è la relazione, non la quantità
📁 LLM AI generated 🏆 ArXiv cs.CL

Poesia infinita con gli LLM: il limite è la relazione, non la quantità

Due esperimenti provano a far scrivere a un LLM una poesia infinita basata su distici e anafore. Il prompting manuale produce un’opera interattiva; un metodo automatico con similarità semantica raggiunge il benchmark di 1000. I risultati mostrano accoppiamenti interessanti ma creatività e comprensione poetica restano sotto il livello umano. La lezione per chi lavora con modelli locali: il vincolo non è generare testo, ma controllare le relazioni.

2026-11-16 📰 Fonte
Oltre il punteggio: mappare i processi interni degli LLM
📁 LLM AI generated 🏆 ArXiv cs.CL

Oltre il punteggio: mappare i processi interni degli LLM

Un nuovo framework analizza i segnali interni di 16 LLM su 24 benchmark, distinguendo compiti centrati sul recupero da compiti centrati sul ragionamento. L’obiettivo è rendere visibili i modi di guasto che i punteggi aggregati nascondono e orientare meglio la scelta dei modelli. Il codice è open source e può essere eseguito localmente, con implicazioni per valutazioni self-hosted e sovranità dei dati.

2026-11-16 📰 Fonte
Reflect-Reasoning: insegnare agli LLM a ragionare sui principi, non solo a seguirli
📁 LLM AI generated 🏆 ArXiv cs.LG

Reflect-Reasoning: insegnare agli LLM a ragionare sui principi, non solo a seguirli

Un nuovo metodo di allineamento, Reflect-Reasoning, insegna agli LLM a ragionare sui principi invece di limitarsi a seguirne di fissi. Supera system prompting e prompting esplicito su cinque modelli, generalizza a principi medici e finanziari fuori distribuzione, riduce violazioni gravi e resiste a costituzioni contraddittorie. Per chi gestisce deployment on-premise, sposta i costi dal fine-tuning all'inference e rende i modelli più governabili senza riaddestramento.

2026-11-16 📰 Fonte
Quando i rilevatori di allucinazioni non reggono sui piccoli LLM a 4 bit
📁 LLM AI generated 🏆 ArXiv cs.AI

Quando i rilevatori di allucinazioni non reggono sui piccoli LLM a 4 bit

Un audit su due LLM open da 3B a 4 bit mostra che i rilevatori di allucinazioni non mantengono la classifica: il ranking si inverte tra i modelli e una baseline lessicale a basso costo è indistinguibile dai metodi di coerenza campionaria. L’etichettatura standard per TruthfulQA produce AUROC vicini al caso, segnalando un problema di valutazione, non dei rivelatori. In ballo c’è la scelta dello strumento per l’inference locale su hardware limitato.

2026-11-16 📰 Fonte
La memoria degli agenti LLM: quando cancellare fatti obsoleti riduce l'accuratezza
📁 LLM AI generated 🏆 ArXiv cs.AI

La memoria degli agenti LLM: quando cancellare fatti obsoleti riduce l'accuratezza

Un'analisi su tre modelli mostra che l'eliminazione automatica dei fatti ritenuti obsoleti può trasformarsi in un costo nascosto. Se il resolver sbaglia e cancella un fatto critico per la query, l'accuratezza scende da guadagni fino a +0,230 a perdite fino a -0,181. Il false-drop pesa più del false-keep. La cancellazione va trattata come decisione cost-sensitive, con validazione su dati reali o conservazione senza etichette.

2026-11-16 📰 Fonte
Abliterated Flash Next: il LoRA elimina i rifiuti senza scaricare centinaia di GB
📁 LLM AI generated ℹ️ LocalLLaMA

Abliterated Flash Next: il LoRA elimina i rifiuti senza scaricare centinaia di GB

Un esperimento su llama.cpp dimostra che le tecniche di abliteration più diffuse sono rank-1 e possono essere distribuite come piccoli LoRA applicati a runtime su una quantization già presente. L'autore ha estratto da Qwen3.8-Flash-Next un LoRA F32 basato su huihui v2, con degradazione trascurabile e rifiuti ridotti da 93/100 a 3/100 sul Jailbreak Bench. Il risultato separa il comportamento dal checkpoint, con vantaggi per storage e TCO nei deployment self-hosted.

2026-11-16 📰 Fonte
OpenAI e Microsoft prendono le idee da r/LocalLLaMA: zero credito, un brevetto
📁 Market AI generated ℹ️ LocalLLaMA

OpenAI e Microsoft prendono le idee da r/LocalLLaMA: zero credito, un brevetto

La community r/LocalLLaMA denuncia due casi: OpenAI avrebbe ripreso un progetto di weight-editing e Microsoft avrebbe brevettato un'idea analoga a CrowdGPT per l'addestramento distribuito su GPU idle. Nessun credito agli autori originali. Il nodo non è solo etico: se i brevetti bloccano alternative decentralizzate, il controllo dell'addestramento resta nelle mani di pochi fornitori cloud, con effetti diretti su autonomia e costi per chi valuta stack locali.

2026-11-16 📰 Fonte
Inside-llm: osservare dentro un LLM e confrontare due quantization token per token
📁 Frameworks AI generated ℹ️ LocalLLaMA

Inside-llm: osservare dentro un LLM e confrontare due quantization token per token

Un nuovo strumento open source osserva in tempo reale cosa accade dentro un LLM e confronta due quantization dello stesso modello token per token. Inside-llm usa llama.cpp e GGUF, gira in locale e mostra probabilità, divergenza, catena dei sampler e logit lens. Per chi valuta deployment self-hosted, rende più trasparente il comportamento delle quantization prima di scegliere quale caricare in VRAM.

2026-11-15 📰 Fonte
Llama.cpp recupera terreno: benchmark locali su RTX 5080 mostrano la svolta
📁 Frameworks AI generated ℹ️ LocalLLaMA

Llama.cpp recupera terreno: benchmark locali su RTX 5080 mostrano la svolta

Un hobbista ha confrontato nel tempo llama.cpp con il proprio motore di inference su una RTX 5080 da 16 GB. In pochi mesi llama.cpp è passato da essere più lento a superare l'alternativa custom, mantenendo un uso efficiente della VRAM. La notizia segnala una maturazione dei runtime locali che riduce l'incentivo a sviluppare motori propri.

2026-11-15 📰 Fonte
Tre nomi sfocati e una leaderboard: la pista per il prossimo GLM di Z.ai
📁 LLM AI generated ℹ️ LocalLLaMA

Tre nomi sfocati e una leaderboard: la pista per il prossimo GLM di Z.ai

Un'indagine su Reddit cerca di decifrare tre nomi sfocati su una leaderboard, probabilmente GLM-Nano Pro, Med e Small. Un test con blur gaussiano e RMSE contenuto dà credito alla lettura. Si sommano il track record di AICodeKing sui rilasci GLM e l'attività recente su Hugging Face. Nessuna conferma ufficiale, ma il caso segnala attenzione crescente verso modelli compatti per deployment self-hosted.

2026-11-15 📰 Fonte
La Malaysia sposta il controllo delle GPU IA dal chip al contatore
📁 OnPremise AI generated ℹ️ Tom's Hardware

La Malaysia sposta il controllo delle GPU IA dal chip al contatore

La Malaysia valuta di usare i consumi elettrici per individuare data center che nascondono GPU IA importate illegalmente. Il segnale di potenza sposta la responsabilità sul gestore e introduce nuovi oneri di documentazione per chi opera cluster self-hosted. AI-RADAR analizza implicazioni per infrastruttura locale, profili di sospetto e TCO.

2026-11-15 📰 Fonte
Il porting dei LLM come variabile di TCO: il segnale da AMD
📁 OnPremise AI generated ✅ Phoronix

Il porting dei LLM come variabile di TCO: il segnale da AMD

L'esperimento AMD con HRX Loom e Ryzen AI Max mostra che portare 50 LLM su GPU client in tre giorni non è solo una prova di forza hardware. Il vero segnale è lo spostamento del valore verso il middleware e le pipeline di porting, con effetti su self-hosted, sovranità dei dati e costi di sperimentazione. Senza benchmark, però, resta da verificare la qualità dell'inference locale.
2026-11-14 📰 Fonte
L’addio di Huang e il vero rischio per chi fa inference on-premise
📁 OnPremise AI generated ✅ TechCrunch AI

L’addio di Huang e il vero rischio per chi fa inference on-premise

Le dimissioni di Jensen Huang costringono i team che gestiscono LLM self-hosted a separare il rilascio di pesi aperti dalla pressione tecnica per farli funzionare bene su hardware Nvidia. Il nodo non è la governance ma il controllo di CUDA e delle ottimizzazioni di inference e fine-tuning. Un’eventuale deriva proprietaria può manifestarsi senza annunci: basterebbe rallentare i framework aperti o favorire i carichi cloud. Per chi sceglie on-premise per sovranità e TCO, il segnale è il supporto reale alle pipeline locali.

2026-11-13 📰 Fonte
Voltage glitch su CMP 170HX: la VRAM come variabile strategica
📁 Hardware AI generated ℹ️ LocalLLaMA

Voltage glitch su CMP 170HX: la VRAM come variabile strategica

Il voltage fault injection su una CMP 170HX sblocca 80 GB di HBM e più SM di una A100 retail, ma il segnale vero è la segmentazione via fusibili. Per l'inference LLM on-premise la VRAM resta la risorsa più contesa. Il mod non scala: TCO incerto, resa variabile, nessun supporto. Chi progetta infrastrutture self-hosted ha bisogno di specifiche prevedibili.

2026-11-12 📰 Fonte
MiniMax-H3-Image: il link funziona, il deployment resta al buio
📁 OnPremise AI generated ℹ️ LocalLLaMA

MiniMax-H3-Image: il link funziona, il deployment resta al buio

La comparsa su Hugging Face di MiniMax-H3-Image senza documentazione tecnica mostra come la distribuzione dei modelli stia premiando la visibilità rispetto alla deployability. Per chi valuta LLM on-premise, l'assenza di dettagli su quantization, VRAM e licenze blocca le stime di TCO e spinge verso API cloud, riducendo sovranità e controllo. AI-Radar analizza il segnale: non è un rilascio ingegneristico, ma un test sulla governance dell'infrastruttura.

2026-11-11 📰 Fonte
Google TPU 8tx: AMD host, sicurezza in uso e il nodo della sovranità
📁 OnPremise AI generated ✅ ServeTheHome

Google TPU 8tx: AMD host, sicurezza in uso e il nodo della sovranità

L'arrivo delle TPU 8tx con host AMD EPYC Turin e confidential computing, insieme al raddoppio della banda della 8i Max, non è un semplice refresh. Google rafforza il cloud per l'inference LLM e sposta la sfida sulla sicurezza dei dati in uso. Per i deployment self-hosted, però, il vincolo resta strutturale: le TPU non si comprano, si consumano nel perimetro Google. Il tema del controllo fisico e della sovranità rimane aperto.

2026-11-10 📰 Fonte
La Modularità degli LLM: Un Segnale di Svolta per l'Framework On-Premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

La Modularità degli LLM: Un Segnale di Svolta per l'Framework On-Premise

La proposta di distribuire adattatori LoRA anziché intere copie di LLM modificati segnala un cambiamento epocale verso la modularità nell'ecosistema dell'intelligenza artificiale. Per le organizzazioni che gestiscono infrastrutture self-hosted, questa evoluzione promette una significativa riduzione del TCO, ottimizzando storage, banda e manutenzione. Al contempo, offre un controllo senza precedenti sulla governance dei modelli e sulla sovranità dei dati, pur introducendo nuove sfide legate alla sicurezza e alla provenienza degli adattatori. AI-RADAR analizza le implicazioni di questa transizione per i decision-maker tecnici.

2026-11-09 📰 Fonte
Obsessive-1.7B: prevedibilità operativa contro copertura nei subagenti locali
📁 OnPremise AI generated ℹ️ LocalLLaMA

Obsessive-1.7B: prevedibilità operativa contro copertura nei subagenti locali

Un LLM da 1,1 GB derivato da LFM3-1.7B esegue una sola ricerca e restituisce risposta, citazione e URL. Nei test il modello base non risponde nel 62% dei casi live, mentre Obsessive risponde sempre e riduce le invenzioni. AI-Radar analizza il trade-off tra copertura e affidabilità per pipeline on-premise.

2026-11-08 📰 Fonte
Il Silicio al Bivio: L'Impatto della Strategia 'Data Center First' di AMD sull'AI On-Premise
📁 Altro AI generated ℹ️ LocalLLaMA

Il Silicio al Bivio: L'Impatto della Strategia 'Data Center First' di AMD sull'AI On-Premise

La dichiarazione del CEO di AMD, che prioritizza le GPU per data center, segna un punto di svolta nel panorama hardware per l'AI. Questa analisi approfondisce le implicazioni per le organizzazioni che perseguono deployment di LLM on-premise, ridefinendo il Total Cost of Ownership, sfidando le iniziative di sovranità dei dati e alterando l'accesso a hardware cruciale con elevata VRAM. La mossa costringe a una rivalutazione delle strategie infrastrutturali locali, in un contesto di crescente competizione per le risorse.

2026-11-07 📰 Fonte
PACT-Check e il mittente silenzioso: la collaborazione tra LLM è vera o è fine-tuning?
📁 Frameworks AI generated 🏆 ArXiv cs.CL

PACT-Check e il mittente silenzioso: la collaborazione tra LLM è vera o è fine-tuning?

PLatour mostra che parte dei guadagni nei sistemi PACT emerge anche con sender non informativi o addestrando solo il ricevitore. PACT-Check misura il contributo reale della comunicazione tra modelli. Per i deployment on-premise, la differenza tra trasferimento di conoscenza e fine-tuning leggero mascherato decide se il modello grande è risorsa utile o overhead in VRAM, energia e complessità. L'asticella dei benchmark si alza: servono controlli, non solo accuratezza finale.

2026-11-06 📰 Fonte
CCORE GLB-3D-Coder 4B: il cantiere self-hosted degli asset 3D
📁 OnPremise AI generated ℹ️ LocalLLaMA

CCORE GLB-3D-Coder 4B: il cantiere self-hosted degli asset 3D

Il rilascio finale di CCORE GLB-3D-Coder 4B segnala una via concreta per generare asset 3D in locale: un LLM da 4B perfezionato per produrre codice Three.js, esportabile in GLB. I pesi in GGUF e il dataset atteso aprono scenari self-hosted, con vantaggi di sovranità dei dati e TCO, ma con tassi di iterazione più alti.

2026-11-05 📰 Fonte
RTX 5090 da 64 e 96 GB: la voce che riapre la partita VRAM
📁 Hardware AI generated ℹ️ LocalLLaMA

RTX 5090 da 64 e 96 GB: la voce che riapre la partita VRAM

La voce su GeForce RTX 5090 con 64 e 96 GB di VRAM tocca il nodo critico per chi usa LLM in locale: la memoria video come collo di bottiglia. Un'analisi sulle implicazioni per self-hosted, quantization, TCO e sovranità dei dati, oltre il semplice annuncio hardware.
2026-11-04 📰 Fonte
Qwen 27B usa Blender da solo: il tool calling locale riscrive l'on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

Qwen 27B usa Blender da solo: il tool calling locale riscrive l'on-premise

Un modello locale da 27 miliardi di parametri ha rilevato, via MCP, la presenza di Blender e ha scritto codice Python per accelerare un calcolo, senza richiesta esplicita. L’episodio sposta l'attenzione da VRAM e throughput alla governance degli strumenti accessibili: sandboxing, permessi e policy diventano centrali nel TCO e nella sicurezza dei deployment self-hosted.

2026-11-03 📰 Fonte
QwenPU, la NPU nei pesi di Qwen che esegue stories260k
📁 OnPremise AI generated ℹ️ LocalLLaMA

QwenPU, la NPU nei pesi di Qwen che esegue stories260k

Un ricercatore ha compilato una NPU nei pesi di Qwen 3.5-4B e ha eseguito stories260k senza runtime esterni. QwenPU ridefinisce il confine tra modello e piattaforma: i pesi diventano substrato computazionale, con implicazioni per deployment self-hosted, audit, distribuzione del software e TCO. AI-Radar analizza i trade-off e i segnali da monitorare.

2026-11-01 📰 Fonte
Qwen4 120B: il segnale on-premise dietro una pull request
📁 OnPremise AI generated ℹ️ LocalLLaMA

Qwen4 120B: il segnale on-premise dietro una pull request

Un dettaglio in una pull request riaccende il dibattito su una classe di LLM da 120 miliardi di parametri. Per chi gestisce deployment self-hosted, la taglia ridefinisce i calcoli su VRAM, quantization e TCO, senza annunci ufficiali. Il segnale indica una stratificazione dei modelli aperti e nuove pressioni su hardware e conformità.

2026-10-31 📰 Fonte
Nvidia e Hugging Face: il vero collo di bottiglia diventa la distribuzione
📁 OnPremise AI generated ℹ️ Tom's Hardware

Nvidia e Hugging Face: il vero collo di bottiglia diventa la distribuzione

L'istruttoria del Dipartimento di Giustizia sull'eventuale acquisizione di Hugging Face da parte di Nvidia segnala uno spostamento del controllo dall'hardware alla distribuzione dei modelli. Per chi gestisce LLM self-hosted, la posta in gioco è la neutralità di repository, framework e pratiche di fine-tuning, con effetti su interoperabilità, TCO e sovranità dei dati.

2026-10-30 📰 Fonte
Qwen4 e il contesto da un milione di token: il conto si paga in VRAM
📁 OnPremise AI generated ℹ️ LocalLLaMA

Qwen4 e il contesto da un milione di token: il conto si paga in VRAM

La pull request in qwen-code segnala che Qwen4 punta a una finestra da un milione di token. Per chi fa inference self-hosted il costo non è teorico: la cache chiave-valore cresce con i token e satura la VRAM insieme ai pesi. Qwen4-27B rende probabili setup multi-GPU o quantization aggressiva. Il vantaggio per l'analisi di repository è reale, ma cambia TCO, benchmark e divario tra data center ed edge.

2026-10-29 📰 Fonte
LFM3: meno token, più decisioni, l'inference locale cambia unità di misura
📁 OnPremise AI generated ℹ️ LocalLLaMA

LFM3: meno token, più decisioni, l'inference locale cambia unità di misura

Liquid AI ha presentato LFM3, famiglia di modelli compatti da 1,7–2,2 miliardi di parametri con architettura tri-hybrid e supporto llama.cpp. I decision model saltano la generazione di token e restituiscono risposte in un singolo forward pass. Per chi fa deployment on-premise e self-hosted, l'attenzione si sposta da costi per token a latenza, footprint e controllo dei dati.

2026-10-28 📰 Fonte
Nanbeige4.3-33B: il docente che prepara i modelli compatti
📁 OnPremise AI generated ℹ️ LocalLLaMA

Nanbeige4.3-33B: il docente che prepara i modelli compatti

Nanbeige4.3-33B non è solo un benchmark: è un insegnante per una pipeline di distillation. Per chi gestisce inference self-hosted, il segnale è chiaro: il costo si sposta dal deployment alla fase di distillazione. Il 3B potrà girare su hardware modesto, ma il docente richiede risorse. La sovranità dei dati passa dalla capacità di distillare on-premise.

2026-10-26 📰 Fonte
DeepSeek-V4.1 GSQ-RCO: quantization pronta, runtime in ritardo
📁 OnPremise AI generated ℹ️ LocalLLaMA

DeepSeek-V4.1 GSQ-RCO: quantization pronta, runtime in ritardo

Il rilascio dei quanti GGUF di DeepSeek-V4.1-Flash-1017 a cura di ISTA-DASLab non è solo una novità di quantization. Mette in luce il vero freno del deployment locale: l'integrazione con i runtime. Con llama.cpp ancora senza supporto ufficiale e il rimando a fork come Xolotl o Maya, chi sceglie l'on-premise deve valutare compatibilità, TCO e manutenzione. La disponibilità dei file non basta: serve un runtime capace di eseguirli.

2026-10-25 📰 Fonte
WebGL2 e LLM nel browser: il debito nascosto della tokenizzazione
📁 OnPremise AI generated ℹ️ LocalLLaMA

WebGL2 e LLM nel browser: il debito nascosto della tokenizzazione

Un esperimento con un LLM GGUF Q4 in WebGL2 si infrange sulla tokenizzazione, non sull'algebra lineare. Il consiglio di clonare llama.cpp segnala che nei deployment locali e self-hosted il differenziale non sta nel motore, ma nell'integrazione con dati e processi. Il browser è una frontiera reale per la sovranità, ma richiede runtime maturi e una prospettiva di TCO.

2026-10-24 📰 Fonte
RAG modulare: un LoRA che decide quando fermarsi e chiedere
📁 OnPremise AI generated 🏆 ArXiv cs.AI

RAG modulare: un LoRA che decide quando fermarsi e chiedere

IBM Research pubblica ClariEdge, un dataset di circa 3.900 esempi per riconoscere le query ambigue nella RAG. Un LoRA leggero ottenuto con fine-tuning raggiunge il 96,6% di accuratezza e supera baseline più grandi. Il segnale: componenti specializzati e locali possono filtrare prima e dopo il retrieval, riducendo esposizione dei dati e consumo di token. Restano i costi di curatela degli hard negative e il monitoraggio fuori distribuzione.

2026-10-23 📰 Fonte
Ternario e solo CPU: il TTS locale ridisegna il TCO
📁 OnPremise AI generated ℹ️ LocalLLaMA

Ternario e solo CPU: il TTS locale ridisegna il TCO

Kitten-TTS 2 introduce la quantization ternaria a 1,58 bit in un modello da 1,7 miliardi di parametri che gira in tempo reale su CPU. Il self-hosting diventa realistico senza GPU, spostando il TCO dalla VRAM alla qualità del software di esecuzione. Per le aziende con vincoli di sovranità dei dati, la pipeline vocale può restare interamente locale. Il segnale: la compressione spinta diventa scelta architetturale pratica.

2026-10-22 📰 Fonte
Cina, 35 miliardi in GPU Nvidia: il canale self-hosted rischia l'effetto domino
📁 OnPremise AI generated ℹ️ LocalLLaMA

Cina, 35 miliardi in GPU Nvidia: il canale self-hosted rischia l'effetto domino

Le indiscrezioni su ordini cinesi di GPU Nvidia per oltre 35 miliardi di dollari segnalano una riallocazione del canale hardware. Per chi esegue LLM in locale, l'effetto non è solo prezzo: è disponibilità, potere negoziale e sovranità dei dati. L'analisi AI-Radar sui trade-off per deployment self-hosted.
2026-10-21 📰 Fonte
Cohere porta North su llama.cpp: il self-hosting entra nella strategia
📁 OnPremise AI generated ℹ️ LocalLLaMA

Cohere porta North su llama.cpp: il self-hosting entra nella strategia

Con North Micro Vision su llama.cpp e Transcribe in Unsloth, Cohere normalizza l'inference locale e il fine-tuning su dati propri. Il segnale sposta il TCO: il costo marginale dell'hardware dedicato può divergere dal costo per token delle API. Restano da chiarire VRAM e livelli di quantization, ma per i modelli Cohere il self-hosting non è più un ripiego.

2026-10-20 📰 Fonte
Una Radeon da 16 GB esegue un LLM da 27B con 262k token: il segnale
📁 OnPremise AI generated ℹ️ LocalLLaMA

Una Radeon da 16 GB esegue un LLM da 27B con 262k token: il segnale

Un homelab, non un vendor, ha documentato un LLM da 27 miliardi di parametri con 262.000 token di contesto su una singola Radeon RX 9060 XT da 16 GB di VRAM, usando quantization, streaming della cache KV e fix software. Il segnale: il costo d'ingresso per self-hosted ad alto contesto si sposta dalle GPU alla gestione del compromesso memoria-precisione-throughput. Resta il costo nascosto di integrazione e supporto.
2026-10-18 📰 Fonte
Il 4B BF16 di NVIDIA e il conto della VRAM nell'inference locale
📁 OnPremise AI generated ℹ️ LocalLLaMA

Il 4B BF16 di NVIDIA e il conto della VRAM nell'inference locale

La pubblicazione di Dory1.0-4B-BF16 mostra come la precisione BF16 ridefinisca il deployment locale. Non è solo un modello piccolo: circa 8 GB di pesi spostano l'attenzione su VRAM, TCO e quantization. Per team con workstation e piccoli server, il segnale è chiaro: cresce la fascia intermedia tra cloud ed edge, con implicazioni per vendor GPU e fornitori cloud. Un'analisi del trade-off tra controllo e infrastruttura.
2026-10-17 📰 Fonte
Muse Spark Open: il segnale vero è nei kernel portatili, non nei 816B
📁 OnPremise AI generated ✅ PyTorch Blog

Muse Spark Open: il segnale vero è nei kernel portatili, non nei 816B

Meta ha aperto i pesi di Muse Spark Open, ma il punto non è solo la scala: Helion, DSL nativo PyTorch per kernel portatili, e il supporto TorchTitan per fine-tuning spostano il confronto su controllo hardware, TCO e self-hosting. Analisi di secondo e terzo ordine.

2026-10-16 📰 Fonte
AMD W7900 e LFM2.5: il segnale di un on-premise sempre più concreto
📁 Hardware AI generated ℹ️ LocalLLaMA

AMD W7900 e LFM2.5: il segnale di un on-premise sempre più concreto

La prova di un LLM da 24 miliardi di parametri su AMD W7900, con contesto da 128.000 token e circa 95 token al secondo, segnala che l'inference on-premise si consolida anche fuori dall'ecosistema NVIDIA. L'analisi di AI-Radar esplora trade-off, sovranità dei dati e TCO.

2026-10-15 📰 Fonte
Mesa porta YOLOX su NPU: il driver aperto ridefinisce l'inference locale
📁 OnPremise AI generated ✅ Phoronix

Mesa porta YOLOX su NPU: il driver aperto ridefinisce l'inference locale

Mesa estende il supporto alle NPU e dimostra YOLOX via PyTorch, spostando l'accesso all'accelerazione fuori dai toolchain proprietari. Per edge e on-premise, il driver aperto riduce lock-in e costi di porting, cambiando il calcolo del TCO. AI-Radar legge il segnale strutturale: l'accelerazione AI segue la traiettoria delle GPU, dove il valore si sposta dal semplice accesso hardware all'orchestrazione con framework condivisi e pipeline riproducibili.

2026-10-14 📰 Fonte
Reverse engineering CUDA con AI: il sintomo di un lock-in che pesa sull'on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

Reverse engineering CUDA con AI: il sintomo di un lock-in che pesa sull'on-premise

Un post Reddit rilancia l'idea di usare LLM per ricreare CUDA open source e liberare le GPU AMD. Il segnale non è la fattibilità tecnica immediata, ma la tensione strutturale tra controllo dello stack, compatibilità software e TCO nelle infrastrutture self-hosted. Per chi valuta deployment on-premise, il dibattito mostra come la scelta hardware sia inseparabile da ecosistemi, framework e vincoli di migrazione.

2026-10-13 📰 Fonte
Scontrini on-device: il segnale per chi controlla l'inference locale
📁 OnPremise AI generated ℹ️ LocalLLaMA

Scontrini on-device: il segnale per chi controlla l'inference locale

Un modello da 0,8B che legge scontrini sul telefono mostra l'inference on-device come opzione concreta per documenti personali. Il progetto intreccia fine-tuning su dati donati, output JSON e una valvola self-hosted via server OpenAI-compatibile. Il segnale per chi valuta deployment locali è il trade-off tra memoria, qualità dei dati e TCO, con la sovranità come vincolo e non preferenza.

2026-10-12 📰 Fonte
RTX 4090 contraffatte: la falla hardware dell'inference self-hosted
📁 Hardware AI generated ℹ️ LocalLLaMA

RTX 4090 contraffatte: la falla hardware dell'inference self-hosted

La circolazione di RTX 4090 contraffatte, quasi indistinguibili all'ispezione visiva e ai primi test software, trasforma l'acquisto di GPU consumer per LLM on-premise in un rischio strutturale. Il danno non si limita alla sostituzione: include instabilità sotto carico, benchmark inaffidabili e TCO più alto. Per chi punta su self-hosted e sovranità dei dati, la provenienza hardware diventa competenza infrastrutturale, non solo logistica.

2026-10-11 📰 Fonte
GLM 5.3 Flash e Mistral Large 4: il sorpasso che sposta il TCO
📁 Market AI generated ℹ️ LocalLLaMA

GLM 5.3 Flash e Mistral Large 4: il sorpasso che sposta il TCO

Due modelli aperti guidano l'Artificial Analysis Cyber Index e superano ogni singolo modello Anthropic. Il sorpasso non è solo classifica: sposta il calcolo del TCO dai canoni API all'infrastruttura on-premise, riapre il confronto su sovranità dei dati, quantization e gestione delle GPU. AI-RADAR analizza le implicazioni per chi valuta deployment locali, fine-tuning e stack self-hosted, oltre i riflessi su vendor cloud e system integrator.

2026-10-10 📰 Fonte
SAP simula l'azienda: dati sintetici senza schema e il nuovo perimetro sovrano
📁 OnPremise AI generated 🏆 ArXiv cs.AI

SAP simula l'azienda: dati sintetici senza schema e il nuovo perimetro sovrano

Il framework Synthesis Through Simulation di SAP genera dati sintetici aziendali facendo operare un agente LLM contro API che applicano policy simulate, senza accedere agli schemi database. La validità strutturale nasce per costruzione, non per estrazione. Per le infrastrutture self-hosted cambia il calcolo di sovranità e TCO: la pipeline locale dalla simulazione al fine-tuning riduce dipendenza da cloud e approvazioni legali, ma sposta il rischio sulla fedeltà dell'ambiente simulato.

2026-10-09 📰 Fonte
← Precedente Page 1 / 2 Successiva →
Vedi Archivio Completo 🗄️

AI-Radar is an independent observatory covering AI models, local LLMs, on-premise deployments, hardware, and emerging trends. We provide daily analysis and editorial coverage for developers, engineers, and organizations exploring local AI solutions.

AI-RADAR badge LaunchTry LAUNCHING SOON ON LaunchTry Fazier badge