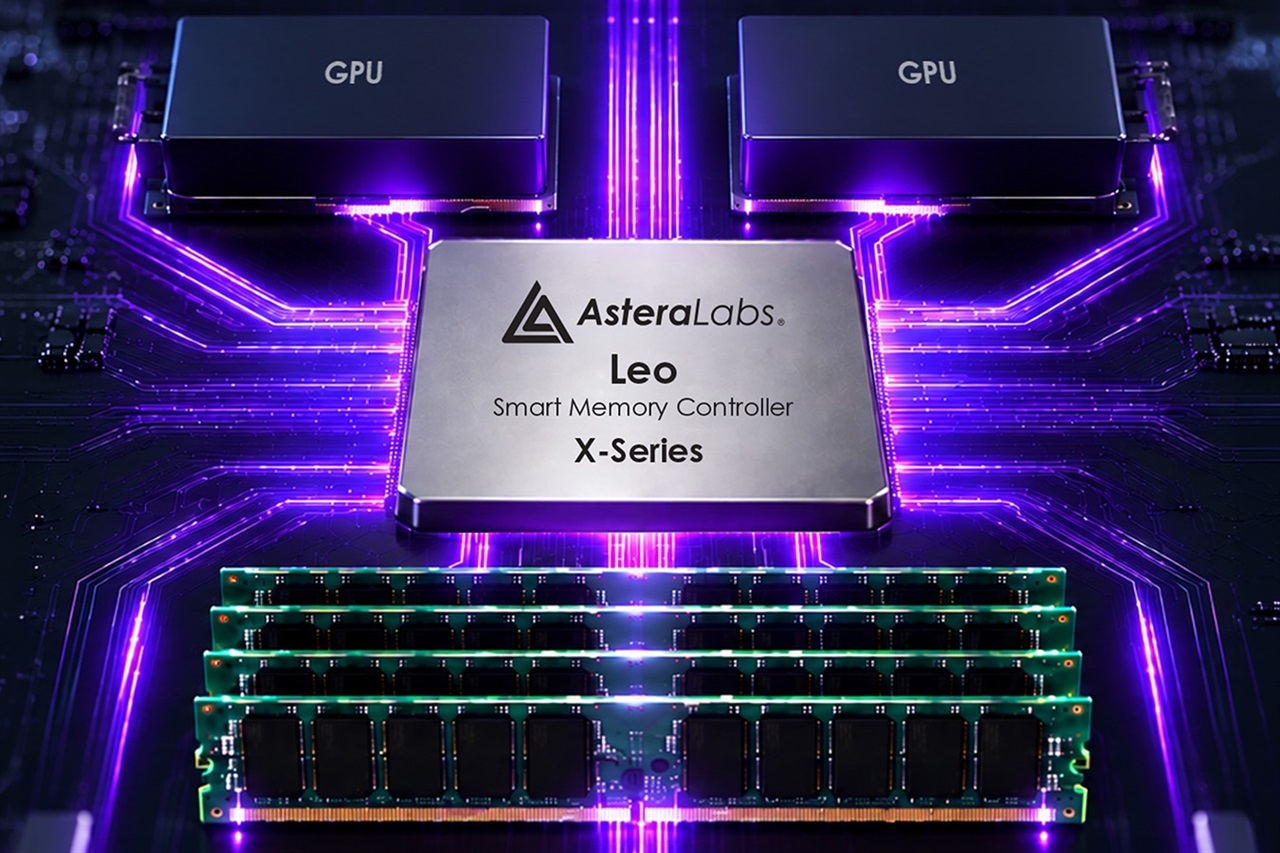
Il segnale: la cache KV esce dall'ombra
Astera Labs ha messo nel mirino un problema che molti team scoprono nel passaggio dalla sperimentazione all'uso operativo dei LLM: la cache KV. Non si tratta di un dettaglio implementativo, ma di un vincolo fisico che determina quanti job possono girare in parallelo, quanto pesa la latenza e quanto incide sul TCO dell'infrastruttura. La scelta dell'azienda di concentrarsi su questo collo di bottiglia è un segnale preciso: il settore sta rivedendo le proprie priorità hardware.
Per anni l'hardware per l'AI è stato raccontato soprattutto in termini di potenza di calcolo e throughput dei core. Le GPU sono state valutate in base ai picchi di FLOPS o alla capacità di addestrare modelli sempre più grandi. Ma i carichi agentici, che concatenano più chiamate e mantengono uno stato condiviso tra i turni, spostano la pressione verso la memoria e le interconnessioni. La cache KV, che nei modelli transformer conserva per ogni token le rappresentazioni intermedie necessarie all'attenzione, cresce rapidamente con contesti lunghi e conversazioni multi-agente.
Quando la VRAM si esaurisce, le opzioni sono poche e ognuna introduce compromessi. Si può ridurre la precisione con la quantization, limitare la lunghezza del contesto o spostare parti della cache fuori dalla GPU. Ogni strada ha un costo in qualità, latenza o complessità operativa. L'interesse di Astera Labs per questo specifico collo di bottiglia non è casuale: indica che il problema non si risolve semplicemente aggiungendo più GPU. Serve una gerarchia di memoria più ampia e coerente, in cui la cache KV possa vivere oltre i limiti della VRAM locale senza rendere l'inference inutilizzabile.
Per chi fa deployment on-premise o self-hosted, questo segnale ha implicazioni immediate. Un'infrastruttura che tiene i dati in locale deve essere dimensionata non solo sul picco di calcolo, ma anche sul comportamento della memoria in scenari multi-turno e multi-agente. La scelta di quanta memoria tenere vicino alla GPU e quanta gestirne via rete determina consumi, dissipazione e complessità operativa. Non è più sufficiente guardare i benchmark di throughput: bisogna capire come la cache KV si comporta sotto carico reale.
Perché la cache KV è un vincolo strutturale per i carichi agentici
Nei modelli transformer, la cache KV memorizza per ogni token le chiavi e i valori necessari al meccanismo di attenzione. Durante la generazione di una sequenza, il modello riutilizza queste rappresentazioni per evitare di ricalcolare l'intero contesto a ogni passo. Con contesti brevi, la cache occupa poca VRAM e il problema è trascurabile. Ma con contesti lunghi e carichi di lavoro agentici, il numero di token cresce rapidamente: più agenti interagiscono, più chiamate si concatenano, più stato condiviso viene mantenuto in memoria.
Questo consumo di VRAM ha effetti diretti sulla capacità di eseguire job in parallelo. Ogni istanza di inference che mantiene una cache KV ampia sottrae memoria che potrebbe essere usata per altri processi. La latenza aumenta perché il sistema deve gestire accessi a memoria più frequenti o spostare dati tra livelli di storage. Il TCO cresce perché serve più hardware per sostenere lo stesso carico utile, oppure si accettano compromessi sulla qualità per risparmiare VRAM.
Le contromisure disponibili sono note ma presentano trade-off evidenti. La quantization riduce la precisione delle rappresentazioni nella cache, risparmiando memoria ma rischiando di degradare la qualità delle risposte. Limitare la lunghezza del contesto taglia la cache ma impedisce di sfruttare finestre lunghe, fondamentali per agenti che devono mantenere memoria di interazioni passate. Spostare parti della cache fuori dalla GPU, magari su memoria di sistema o storage veloce, alleggerisce la VRAM ma introduce latenza aggiuntiva nel percorso critico dell'attenzione.
Per un'organizzazione che gestisce LLM in locale, questi trade-off non sono teorici. La decisione su quanta VRAM dedicare alla cache, su come gestire lo spill-over e su quali livelli di memoria intermedia adottare impatta direttamente sulla qualità del servizio, sui costi operativi e sulla possibilità di scalare senza interventi strutturali. La cache KV diventa quindi un parametro di progetto tanto importante quanto la scelta del modello o della GPU.
La gerarchia di memoria diventa il nuovo campo di battaglia
L'interesse di Astera Labs per la cache KV segnala che il settore sta spostando l'attenzione dalla potenza di calcolo alla gerarchia di memoria. Aggiungere più GPU può aumentare la capacità di calcolo grezzo, ma se la VRAM locale rimane il collo di bottiglia, ogni GPU aggiuntiva rischia di essere sottoutilizzata. Serve una visione più ampia: memoria vicino ai core, memoria di sistema, storage NVMe e interconnessioni veloci devono lavorare insieme in modo coerente.
Questa visione ha implicazioni dirette per i deployment on-premise e self-hosted. Un'infrastruttura locale deve essere dimensionata non solo sul picco di calcolo, ma anche sul comportamento della memoria in scenari multi-turno e multi-agente. La scelta di quanta memoria tenere vicino alla GPU e quanta gestirne via rete determina consumi, dissipazione e complessità operativa. I costi non sono solo CapEx: l'energia necessaria per spostare dati tra livelli di memoria, il raffreddamento aggiuntivo e la gestione di componenti eterogenei incidono sul TCO.
Per chi opera in regime di sovranità dei dati, la questione è ancora più stringente. Tenere i dati in locale significa non poter delegare a servizi cloud la gestione della memoria. La cache KV, che contiene rappresentazioni intermedie dei dati di input, deve essere gestita all'interno del perimetro controllato. Questo richiede una progettazione attenta dei flussi di dati e della memoria, perché ogni spostamento fuori dalla GPU deve rispettare vincoli di sicurezza e latenza.
La flessibilità della memoria diventa quindi un criterio di scelta fondamentale. Non basta guardare la capacità massima di VRAM di una scheda: bisogna valutare come il sistema gestisce il fallback, come le interconnessioni supportano accessi a memoria remota e come il software sfrutta eventuali livelli di cache intermedi. Chi progetta infrastrutture locali per LLM deve adottare un approccio olistico che includa questi aspetti, altrimenti rischia di trovarsi con un sistema che funziona bene nei test ma collassa sotto carichi agentici reali.
Chi controlla il movimento dei dati, non solo il calcolo
La mossa di Astera Labs rafforza un messaggio strategico: la prossima generazione di infrastrutture per LLM non sarà vinta da chi ha il chip più veloce, ma da chi controlla meglio il movimento dei dati. I fornitori di soluzioni di memoria e connettività possono ritagliarsi un ruolo centrale, mentre chi si concentra solo sul calcolo rischia di perdere rilevanza man mano che il vincolo si sposta. Questo non significa che il calcolo diventi irrilevante, ma che il differenziale competitivo si sposta verso la capacità di orchestrare i flussi di dati tra livelli di memoria eterogenei.
Per le organizzazioni che valutano stack locali, questo cambiamento impone di rivedere i criteri di selezione. I benchmark di picco, che misurano il throughput in condizioni ideali, non catturano il comportamento della cache KV sotto carichi multi-agente. Bisogna includere metriche legate alla latenza di accesso alla memoria, alla capacità di gestire contesti lunghi senza degrado e alla flessibilità nel configurare la gerarchia di memoria. I fornitori che offrono soluzioni integrate, con memoria e connettività ottimizzate per i pattern di accesso dei transformer, potrebbero risultare più adatti a deployment on-premise che richiedono controllo e prevedibilità.
La sovranità dei dati aggiunge un ulteriore livello di complessità. Un'infrastruttura locale deve garantire che i dati, comprese le rappresentazioni intermedie nella cache KV, non escano dal perimetro controllato. Questo favorisce soluzioni che permettono di gestire la memoria in modo granulare, con politiche di spill-over configurabili e senza dipendenze da servizi cloud esterni. Chi controlla il movimento dei dati all'interno del proprio data center ha un vantaggio tangibile in termini di conformità e sicurezza.
AI-RADAR dedica spazi di analisi su /llm-onpremise per chi vuole esplorare questi trade-off senza scorciatoie. La complessità non va nascosta: ogni scelta sulla memoria e sulla connettività ha ripercussioni sul TCO, sulla qualità del servizio e sulla capacità di scalare. Il nostro obiettivo è fornire strumenti analitici per decisioni informate, non classifiche di prodotto.
Cosa guardare: segnali per monitorare l'evoluzione
Chi segue l'evoluzione dell'infrastruttura per LLM deve monitorare alcuni segnali specifici. Innanzitutto, l'adozione di tecnicie di memoria emergenti che permettono di estendere la capacità oltre la VRAM locale senza introdurre latenze proibitive. Non si tratta di seguire un singolo standard, ma di osservare come i fornitori integrano memoria di sistema, storage veloce e interconnessioni ad alta banda in architetture coerenti.
In secondo luogo, lo sviluppo di framework software che gestiscono la cache KV in modo intelligente. La possibilità di spostare selettivamente parti della cache su memoria più lenta, di applicare quantization adattiva o di prevedere quali token saranno necessari per i prossimi passi può fare la differenza tra un sistema che scala e uno che collassa. I framework che espongono controlli granulari su questi aspetti diventeranno sempre più rilevanti per i deployment on-premise.
Un terzo segnale riguarda la co-progettazione hardware-software. I pattern di accesso alla memoria dei transformer sono specifici e prevedibili: le soluzioni che nascono da una collaborazione stretta tra chi progetta il silicio e chi scrive i framework di inference hanno maggiori probabilità di superare i compromessi attuali. Osservare come i vendor di GPU, memoria e interconnessioni collaborano con i team di ricerca sui LLM può indicare dove si formeranno i prossimi vantaggi competitivi.
Infine, per chi gestisce infrastrutture locali, è importante monitorare l'evoluzione dei carichi di lavoro agentici. L'aumento della lunghezza media dei contesti, il numero di agenti che cooperano in una singola sessione e la complessità dello stato condiviso sono indicatori che determinano quanto presto la cache KV diventerà un collo di bottiglia critico. Chi anticipa questi trend e dimensiona la propria infrastruttura di conseguenza eviterà interventi costosi e improvvisi.
Prospettiva AI-RADAR: trade-off senza scorciatoie
La vicenda Astera Labs è un promemoria: nell'infrastruttura per LLM, i colli di bottiglia si spostano e le priorità cambiano. Per anni il calcolo è stato il re, ma i carichi agentici stanno spostando l'attenzione verso la memoria e il movimento dei dati. La cache KV, un tempo considerata un dettaglio implementativo, emerge come un fattore determinante per il parallelismo, la latenza e il TCO.
Per chi fa deployment on-premise o self-hosted, questo significa che i criteri di scelta non possono limitarsi alla potenza di calcolo. La capacità di gestire la cache KV in modo efficiente, la flessibilità della gerarchia di memoria e la coerenza delle interconnessioni sono altrettanto importanti. Il TCO non si riduce al prezzo di acquisto delle GPU: include consumi energetici, raffreddamento, complessità operativa e la necessità di interventi futuri.
La sovranità dei dati aggiunge un vincolo non negoziabile. Tenere tutto in locale richiede un controllo fine dei flussi di memoria, perché la cache KV contiene informazioni derivate dai dati di input. Ogni soluzione che promette di risolvere il collo di bottiglia deve dimostrare di farlo senza compromettere la sicurezza o introdurre dipendenze esterne.
In definitiva, il segnale di Astera Labs indica che l'infrastruttura per LLM sta entrando in una fase in cui il controllo del movimento dei dati conta quanto la potenza di calcolo. Chi progetta stack locali deve adottare una visione olistica che includa memoria, interconnessioni e software di gestione. AI-RADAR continuerà a esplorare questi trade-off senza scorciatoie, perché le decisioni prese oggi determineranno la sostenibilità dei deployment di domani.


💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!