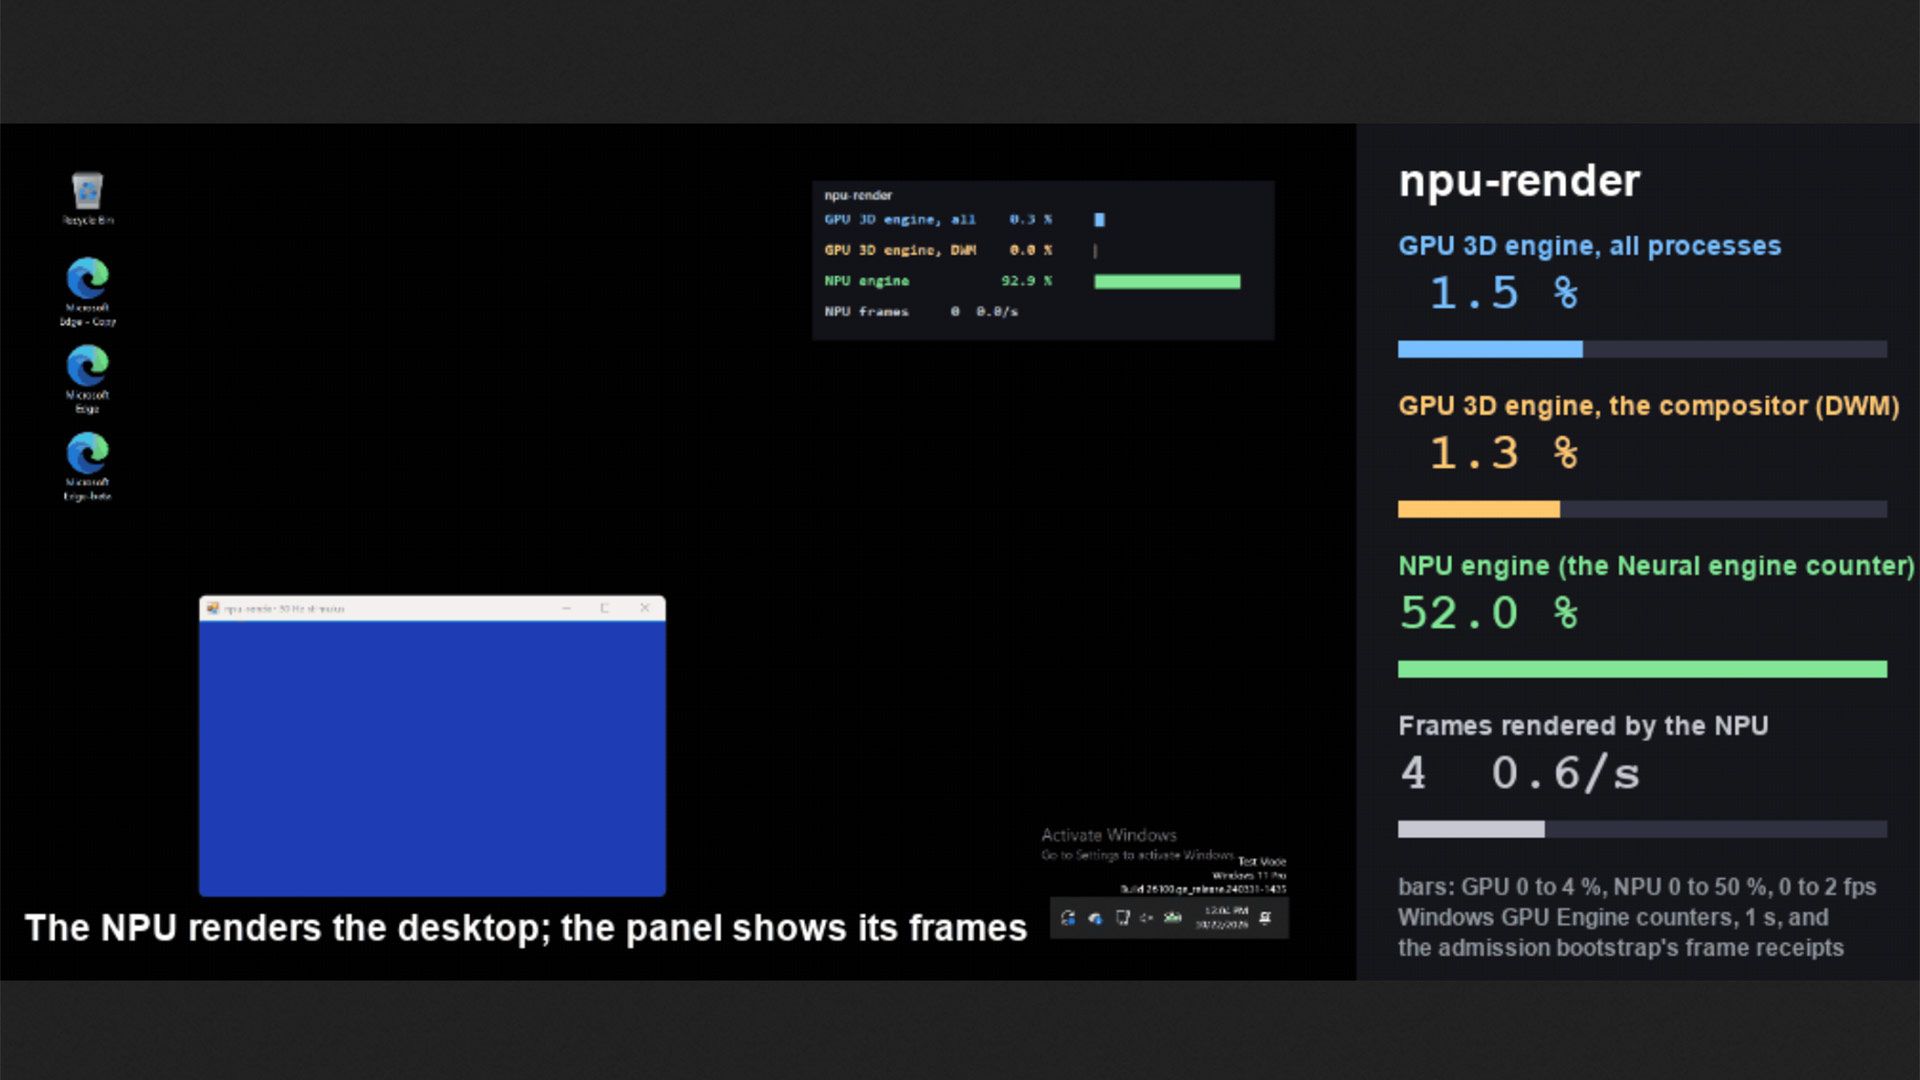
Il progetto open source npu-driver ha deciso di percorrere una strada che fino a ieri sembrava poco più di una provocazione: usare la NPU per comporre il desktop di Windows 11 al posto della GPU. Il risultato attuale è un frame rate di 2-3 Hz, lontano dai 30 Hz che il progetto indica come obiettivo. Eppure il semplice fatto che un desktop arrivi a schermo attraverso un acceleratore nato per l'inference di reti neurali è già un segnale strutturale, non un esperimento da laboratorio privo di conseguenze.
Normalmente la composizione del desktop è un lavoro da GPU: coinvolge texture, finestre, effetti di trasparenza e scalature. Una NPU è progettata per moltiplicazioni matriciali e carichi di inference a basso consumo, non per produrre frame con la complessità grafica a cui siamo abituati. Il fatto che npu-driver riesca comunque a generare output, seppur a passo d'uomo, dimostra che l'hardware ha accesso a memoria e capacità di calcolo sufficienti per un rendering essenziale. Non è una vittoria prestazionale: è la prova che il confine tra acceleratori specializzati e GPU è meno rigido di quanto i vendor lascino intendere.
A trarne vantaggio, per ora, sono soprattutto gli sviluppatori di driver open source e gli utenti con portatili dotati di NPU integrata. Se il progetto arrivasse a 30 Hz, la GPU potrebbe restare inattiva durante la normale navigazione del desktop, con un risparmio energetico tangibile sui dispositivi a batteria. Non è fantasia: i SoC moderni già integrano blocchi NPU accanto a CPU e GPU, ma spesso li lasciano dormire quando non ci sono modelli di intelligenza artificiale da eseguire. Dare alla NPU un compito continuo e a bassa intensità cambierebbe il modo in cui i produttori progettano il power management.
A perdere terreno, in uno scenario del genere, sarebbero i driver grafici proprietari che oggi controllano quasi ogni pixel del desktop. Un driver open source capace di attivare la NPU per il rendering riduce la dipendenza da stack binari e apre la porta a ottimizzazioni indipendenti. Non è un attacco alle GPU: per il gaming o il rendering 3D servono ancora prestazioni che la NPU non ha. Ma per la produttività quotidiana il ruolo della GPU potrebbe ridimensionarsi, e questo sposta quote di rilevanza tecnica verso chi produce NPU e verso chi scrive codice aperto.
La questione ha un riflesso diretto sul calcolo locale. Chi segue il deployment on-premise e edge sa che la disponibilità di acceleratori programmabili in modo trasparente è un nodo centrale: oggi le NPU sono spesso esposte solo attraverso framework specifici, con scarsa documentazione e API proprietarie. Se un progetto open source riesce a usarle per un compito non previsto, diventa più plausibile che lo stesso accesso venga sfruttato per LLM in esecuzione locale, per preprocessing di dati o per pipeline di inference senza passare dal cloud. Non è una previsione, ma una direzione già coerente con la domanda di sovranità e controllo del dato. AI-RADAR dedica approfondimenti su /llm-onpremise a questi trade-off, senza ricette prefabbricate.
Oggi npu-driver è fermo a 2-3 Hz. Il target di 30 Hz resta lontano, ma il progetto ha già ottenuto qualcosa di più raro di un benchmark: ha dimostrato che la NPU può essere portata fuori dal recinto dei modelli AI e messa a lavorare sul sistema operativo. La distanza da colmare, adesso, è soprattutto una questione di ottimizzazione e di API esposte.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!