Un solo GEMM, tre varianti: il collo di bottiglia si sposta
Il backend lineare Helion per vLLM introduce un cambio di prospettiva: invece di mantenere più implementazioni specializzate per i GEMM a 8 bit, propone un unico kernel che copre Standard GEMM, Split-K e Swap-AB. Le scelte che prima erano codificate in euristiche di dispatch diventano parametri tunable. L'autotuner ahead-of-time esplora il layout di memoria, lo scheduling e le varianti algoritmiche per ciascuna forma di input. Non è una semplificazione cosmetica: sposta il punto in cui si gioca la partita delle prestazioni. In un framework come vLLM, le euristiche servono a gestire la variabilità delle forme dei tensori durante l'inference. Split-K divide la dimensione K quando M o N sono troppo piccole; Swap-AB riscrive l'operazione per migliorare i casi con M ridotta. Funzionano in media, ma non sono ottimali per ogni modello o carico. Helion trasforma la selezione della variante da una decisione di progetto a un problema di ricerca numerica. Il risultato è una pipeline di ottimizzazione che può adattarsi al singolo workload, non a una media di workload. Per chi gestisce LLM in produzione, questo è un segnale: l'ottimizzazione dei kernel può diventare un processo ripetibile, non un'opera artigianale da rifare a ogni architettura o modello.
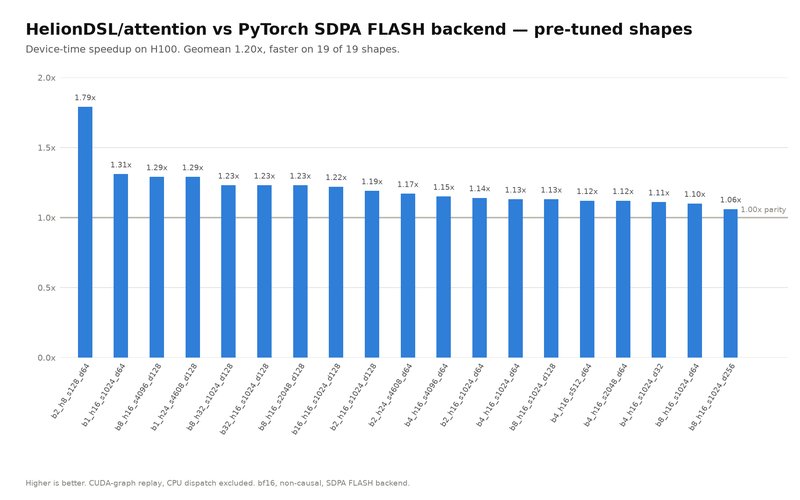
La seconda implicazione è meno visibile ma più strutturale. La complessità non sparisce: viene assorbita dal tuning ahead-of-time. Il team che sviluppa Helion descrive split_k e swap_ab come parametri tunable, con split_k limitato a valori potenza di due fino a 256. L'autotuner confronta sistematicamente le combinazioni e sceglie la configurazione migliore per ogni workload. In pratica, il costo cognitivo di capire quale variante usare si sposta dallo sviluppatore di kernel all'infrastruttura di tuning. Su una GPU NVIDIA H100 80GB HBM3, i kernel Helion raggiungono speedup geometrici medi di 1.110× su CUTLASS per FP8_Dynamic, 1.178× su CUTLASS per W8A8_INT8, 1.149× su FlashInfer e 1.177× su DeepGEMM per Block_FP8. La distribuzione degli speedup varia da forma a forma, e proprio questa variazione conferma il valore del tuning per forma rispetto a una configurazione unica. Non è il singolo guadagno medio a contare, ma la possibilità di ridurre i colli di bottiglia specifici di un modello.
Questa impostazione cambia anche il rapporto con i framework. Oggi molti backend lineari delegano a CUTLASS o DeepGEMM le proprie primitive. Se un kernel unificato come Helion riesce a coprire le stesse varianti con un'automazione spinta, la barriera all'ingresso per introdurre nuovi formati di quantization o nuove architetture potrebbe abbassarsi. Il costo di mantenere decine di kernel specializzati è sostituito dal costo di mantenere un autotuner e i relativi file di configurazione. Non è detto che sia sempre più economico, ma è un modello diverso di ingegneria.
Dalla programmazione GPU artigianale alla ricerca automatica
Per anni l'ottimizzazione dei kernel GEMM è stata considerata territorio per pochi specialisti di programmazione GPU di basso livello. Serviva conoscere i dettagli delle architetture NVIDIA, le strategie di tiling, i layout di memoria. Helion, come DSL per kernel nativo PyTorch e agnostico rispetto all'hardware, prova a ridurre questa dipendenza. Permette di scrivere un kernel una sola volta in codice Python conciso e di generare codice specializzato per piattaforme diverse. Non è una soluzione magica: il tuning ahead-of-time può richiedere ore e richiede comunque di sapere cosa si sta ottimizzando. Ma sposta il baricentro delle competenze. Un team che serve un modello specifico su infrastruttura self-hosted può ottenere configurazioni ritagliate sul proprio carico senza dover mantenere internamente competenze CUDA profonde. Deve però investire in automazione, gestione dei config e capacità di leggere i risultati dell'autotuner.
Questo ha implicazioni organizzative. Il lavoro sui kernel non è più solo un problema di scrittura di codice, ma di progettazione di uno spazio di ricerca. Le scelte algoritmiche diventano parametri, e il loro valore emerge solo se lo spazio di ricerca è abbastanza ricco e il processo di tuning è affidabile. Per un'azienda che gestisce LLM in casa, la domanda non è più esclusivamente qualcuno sa scrivere un kernel CUDA, ma abbiamo una pipeline per generare e validare configurazioni ottimizzate per i nostri modelli. Sono due profili diversi. Il primo è spesso difficile da reperire e da trattenere; il secondo può essere costruito con competenze di MLOps e automazione.
Il cambio di incentivi è rilevante. Il team di Red Hat e Meta dietro Helion descrive il lavoro come pronto per l'uso in produzione, ma in un fork di vLLM. L'adozione upstream non è scontata. In questo contesto, la capacità di generare config specifici prima del deployment diventa un asset operativo. Le organizzazioni con molti modelli o hardware eterogeneo possono vedere nel tuning ahead-of-time un modo per estrarre più valore dalle GPU già acquistate. Chi invece cerca un'integrazione plug-and-play potrebbe trovare più attrito, perché il costo di processo non si limita al tuning iniziale ma comprende anche la manutenzione dei config quando cambiano i modelli o le versioni del framework.
Il prezzo del tuning per forma: ore di calcolo e configurazioni da governare
La strategia di dispatch ibrida descritta per l'integrazione Helion offre un compromesso interessante. Per forme piccole fino a un valore max_helion_size, nel lavoro pari a 32, il backend lineare usa Helion sotto CUDA Graph replay; oltre quella soglia ricade sui kernel predefiniti CUTLASS o DeepGEMM. Questo riduce l'overhead CPU legato a dispatch e launch dei kernel Helion fuori dai CUDA Graph e limita il numero di forme da ottimizzare. In termini pratici, il tuning non deve coprire l'intero spazio possibile, ma solo le forme che passano realmente attraverso i CUDA Graph. È una scelta che rende più gestibile la manutenzione dei config precalcolati, ma introduce una soglia da scegliere con attenzione. Un valore troppo basso lascia fuori parte del carico e riduce il beneficio; un valore troppo alto aumenta il numero di configurazioni da generare e validare.
Il compromesso tra prestazioni, usabilità e manutenibilità è esplicito. Un tuning più fine migliora le prestazioni ma aumenta lo sforzo di autotuning lato cliente o l'onere di distribuire config precalcolati. La fonte indica che il team sta valutando un modello in cui i kernel Helion e il framework di integrazione vengano mantenuti upstream con un config di default per test funzionali e CI, mentre l'autotuning specifico per workflow venga delegato agli utenti finali. È una posizione che privilegia prestazioni e manutenibilità rispetto all'usabilità immediata. Per chi fa serving di modelli in produzione, può essere un tradeoff accettabile: l'ottimizzazione offline è un investimento ripagato se il carico è stabile e il volume di richieste giustifica il costo.
C'è anche una questione di governance. I file di configurazione ottimizzati per modelli e hardware diventano artefatti critici quasi quanto i pesi dei modelli. Vanno versionati, testati, distribuiti. Se un aggiornamento di vLLM cambia il comportamento dei CUDA Graph o introduce nuove forme, i config esistenti potrebbero non essere più ottimali. Chi adotta Helion in un fork deve considerare il costo di mantenere allineati il fork, i config e il parco hardware. Non è diverso da ciò che accade con altri sistemi di ottimizzazione automatica, ma qui il perimetro è più ampio perché coinvolge il backend lineare di un framework di serving.
Cosa significa per i deployment on-premise e self-hosted
AI-Radar osserva da tempo uno spostamento verso LLM gestiti su infrastruttura propria. In questo scenario, il TCO non dipende solo dal costo per GPU, ma dalla quantità di token serviti per unità di hardware. Un backend lineare che moltiplica le prestazioni dei GEMM a 8 bit su H100 può tradursi in una maggiore capacità di serving con lo stesso parco macchine. I benchmark end-to-end con vLLM serve e dataset ShareGPT mostrano guadagni di throughput consistenti su modelli Qwen3 di diverse dimensioni, con miglioramenti superiori al 10% in alcuni workload. Non è un dettaglio marginale: per carichi stabili, il 10% può significare ritardare l'acquisto di nuove GPU o aumentare il margine di assorbimento dei picchi.
Il segnale per chi gestisce LLM in casa è però più cautelativo. I kernel predefiniti dei framework non sono un vincolo invalicabile, ma l'ottimizzazione specifica ha un costo di processo che va messo in conto nei deployment e negli aggiornamenti. Questo è il messaggio centrale. Non basta applicare un backend e sperare in un guadagno medio: serve un ciclo continuo di misurazione, tuning e validazione. Le forme dei tensori cambiano con il modello, con la lunghezza delle sequenze e con le strategie di batching. Un autotuner ahead-of-time consente di generare configurazioni ottimizzate prima del deployment, ma qualcuno deve decidere quali workload meritano l'investimento.
A livello di sovranità dei dati, il tema non è diretto ma si collega. Un backend più efficiente rende più praticabile l'operatività di modelli self-hosted su GPU di proprietà. Non sposta dati verso servizi esterni, anzi rafforza l'idea che l'ottimizzazione possa avvenire internamente. Per organizzazioni che non possono o non vogliono usare API esterne, la possibilità di migliorare l'inference locale senza dipendere da un vendor di kernel specifico è un elemento di controllo in più. Il fork di vLLM, però, introduce una dipendenza da un ramo non upstream. Chi lo adotta deve valutare se questa dipendenza è compatibile con i propri requisiti di manutenibilità e aggiornamento.
Oltre Hopper: Blackwell, AMD, TPU e il perimetro del fork
Il lavoro presentato si concentra su GPU NVIDIA Hopper, ma il team Helion sta estendendo il supporto a NVIDIA Blackwell tramite il backend CuteDSL, con lavoro in corso anche su GPU AMD e TPU. Questa direzione è coerente con la natura del DSL: scrivere un kernel una sola volta e generare codice specializzato per piattaforme diverse. Se l'approccio regge, il costo di portabilità potrebbe ridursi rispetto ai kernel scritti a mano in CUDA. Ma la promessa va verificata su architetture diverse, dove i vincoli di memoria, i layout e le primitive disponibili cambiano. Blackwell, ad esempio, introduce differenze rilevanti nella gestione dei tensor core e della memoria; AMD e TPU pongono problemi di stack software non banali.
L'integrazione è disponibile oggi in un fork di vLLM. Questo è un punto da monitorare. Un fork pronto per la produzione nelle mani di un team con risorse può essere accettabile, ma l'allineamento con upstream è un costo continuo. Le modifiche a vLLM sono frequenti e toccano anche il backend lineare, i CUDA Graph e la gestione dei formati di quantization. Se Helion non entra upstream, chi lo usa dovrà ribasare il fork a ogni release significativa, con potenziali conflitti. Il modello proposto dagli autori — kernel Helion e framework di integrazione upstream con config di default, tuning specifico delegato agli utenti finali — potrebbe ridurre l'attrito, ma non elimina la necessità di una strategia di aggiornamento.
L'estensione ai modelli MoE è un altro obiettivo dichiarato. Nei modelli mixture-of-experts, il backend MoE diventa il target principale di ottimizzazione. Le forme di GEMM in un MoE sono diverse da quelle di un dense model: spesso ci sono molti esperti con dimensioni ridotte, e le scelte di Split-K o Swap-AB possono avere effetti più marcati. Se l'approccio di tuning per forma si estende ai GEMM degli esperti, il potenziale di miglioramento potrebbe essere significativo, ma cresce anche la complessità dello spazio di ricerca. Chi oggi sta valutando MoE self-hosted dovrebbe osservare con attenzione.
Cosa guardare nei prossimi mesi: MoE, kernel ausiliari e manutenzione upstream
Per i responsabili di infrastrutture di inference, i prossimi segnali da monitorare non sono solo i benchmark. Il primo è l'eventuale ingresso di Helion in vLLM upstream. Se avviene con un config di default per CI e test funzionali, la barriera all'adozione scende, ma il valore reale resta nel tuning per workload. Il secondo segnale è l'evoluzione del supporto Blackwell. Le GPU Blackwell stanno entrando nei datacenter e nei laboratori; capire se il backend CuteDSL mantiene i vantaggi misurati su Hopper è cruciale per pianificare gli acquisti.
Il terzo segnale riguarda i kernel ausiliari. La fonte indica che per quantization, attivazioni e normalizzazione i primi esperimenti mostrano miglioramenti significativi con un numero ridotto di config. Se questo risultato si consolida, il costo di manutenzione potrebbe abbassarsi e aprire una via più leggera all'adozione upstream. In un serving pipeline, i GEMM non sono l'unico collo di bottiglia. Kernel ausiliari inefficienti possono erodere parte dei guadagni ottenuti sui GEMM. Un backend lineare che copre anche questi kernel con un approccio unificato avrebbe un impatto più ampio.
Infine, va osservato il comportamento dell'autotuner su carichi reali. I benchmark con ShareGPT e Qwen3 danno indicazioni positive, ma i carichi di produzione sono più eterogenei: prompt lunghi, batch variabili, decoding con numeri di token diversi, quantization mista. L'autotuner ahead-of-time sceglie la configurazione per ciascuna forma di input, ma non può prevedere tutte le combinazioni che emergono a runtime. La strategia del CUDA Graph replay con soglia di 32 può mitigare l'overhead CPU, ma la scelta della soglia e la copertura delle forme restano variabili da validare caso per caso. Non si tratta di scetticismo: è la natura di un sistema che sposta l'ottimizzazione verso un processo di ricerca. Il processo va governato.


💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!