Il parametro che non sta più nella GPU
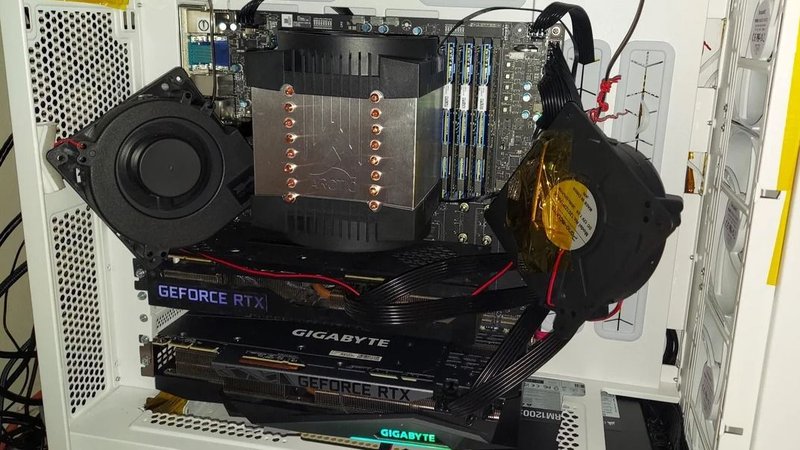
A prima vista la notizia sembra una curiosità da appassionati: una configurazione homelab con due GeForce RTX 3090 e memoria Intel Optane di seconda generazione riesce a caricare e interrogare un Large Language Model da 2,8 trilioni di parametri, restituendo 3,11 token al secondo. Il dato non sposta gli equilibri dei datacenter, ma obbliga a leggere il problema dell'inference self-hosted con un'altra lente. Finora la domanda era quasi sempre la stessa: quanta VRAM serve per tenere i pesi del modello? La risposta determinava il numero e il tipo di GPU, il budget e il confine tra ciò che si poteva sperimentare e ciò che restava fuori portata.
Il valore dell'esperimento sta nel modo in cui aggira quel vincolo. I pesi del checkpoint non vengono compressi per entrare nella memoria delle schede, né il lavoro viene suddiviso su un cluster. La configurazione sfrutta una gerarchia di memoria: le GPU trattano solo la parte dei parametri necessaria a produrre il token corrente, mentre il resto risiede su storage persistente a bassa latenza. È un cambio di prospettiva: la VRAM smette di essere il contenitore esclusivo del modello e diventa una finestra di calcolo su un checkpoint molto più grande.
Il prezzo è il throughput. Tre token e poco più al secondo rendono il sistema inadatto a un assistente conversazionale fluido o a carichi interattivi. Ma non tutti i carichi richiedono bassa latenza. Valutazioni, batch, test qualitativi su dataset locali, prove di comportamento su prompt complessi possono tollerare tempi lunghi, soprattutto se il valore sta nel poter esaminare un modello di scala enorme senza cedere i dati a un'API esterna. È qui che la curiosità tecnica diventa un segnale di mercato.
La gerarchia di memoria come variabile di progetto
L'esperimento rende esplicito un cambiamento strutturale: nella progettazione dell'inference, la memoria volatile e quella persistente non sono più livelli separati, ma un continuum da orchestrare. Le GPU accelerano il calcolo, la RAM di sistema assorbe parte dello scambio e lo storage a bassa latenza mantiene i parametri inattivi. Il punto non è solo la capacità, ma la capacità di spostare i dati al momento giusto. Un checkpoint da 2,8 trilioni di parametri non può essere spostato per intero a ogni token; serve una pipeline che selezioni, trasferisca e prepari in anticipo le porzioni necessarie.
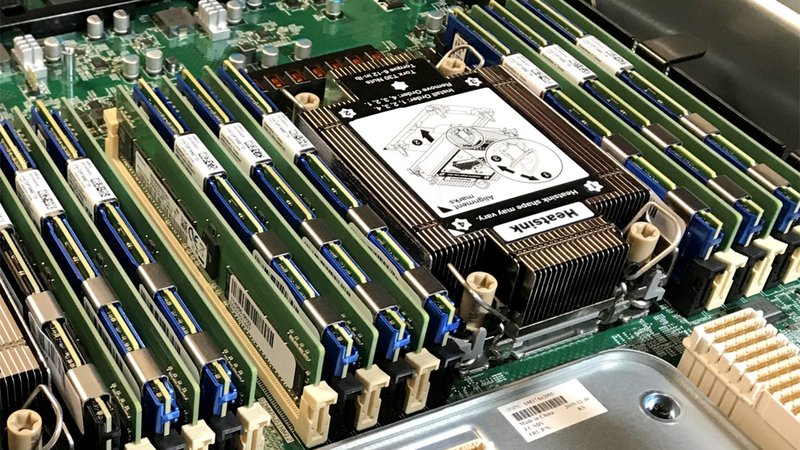
Optane ha un ruolo specifico perché riduce il divario tra memoria persistente e memoria di lavoro rispetto agli SSD NAND tradizionali, soprattutto sul fronte delle letture casuali e della latenza. Non è una panacea: il throughput resta lontano da quello della VRAM e il costo per gigabyte può essere elevato. Tuttavia, in scenari in cui il modello eccede la capacità delle GPU e i carichi sono batch o asincroni, la persistenza a bassa latenza cambia i termini del compromesso. Il problema non è più se il modello entra nella VRAM, ma quanto rapidamente si può portare in VRAM solo ciò che serve.
Questa prospettiva ha implicazioni per chi sviluppa software di inference. I framework dovranno gestire il tiering in modo più esplicito: decidere quali blocchi del modello caricare, quando liberare memoria, come prefetchare i parametri per i token successivi e come mantenere la coerenza tra livelli. Le ottimizzazioni non si limitano più alla kernel fusion o alla quantization, anche se quest'ultima resta un alleato per ridurre l'impronta complessiva. Si aggiunge una dimensione di orchestrazione dei dati che premia chi sa leggere i pattern di accesso al checkpoint e adattarli all'hardware disponibile.
Per le organizzazioni, il messaggio è ambivalente. Da un lato si abbassa la barriera hardware per sperimentare modelli enormi in self-hosted. Dall'altro cresce la complessità operativa: una configurazione eterogenea richiede competenze per gestire storage, memoria e GPU, oltre che per mettere a punto la pipeline. La semplice presenza di due RTX 3090 e Optane non basta; serve un controllo fine su come i dati attraversano i diversi livelli. Chi valuta questa strada deve chiedersi se il risparmio iniziale sull'hardware giustifica il tempo speso a rendere il sistema stabile e ripetibile.
Sovranità dei dati e TCO: il conto non si ferma all'acquisto
Per un'organizzazione con vincoli di sovranità dei dati, l'esperimento ha un valore che va oltre il numero di token al secondo. Poter eseguire un modello di scala enorme su hardware locale, accettando una latenza elevata, significa mantenere il controllo su dati sensibili senza doverli inviare a un endpoint cloud. In settori regolamentati, questa possibilità può spostare il confine tra ciò che è sperimentabile internamente e ciò che è bloccato da policy o contratti. Non si tratta di sostituire un servizio di produzione: si tratta di aprire spazi di validazione, test e analisi che prima richiedevano infrastrutture fuori portata.
Il TCO va però calcolato con attenzione e senza scorciatoie. Il CapEx può essere contenuto, soprattutto se si acquistano componenti usati o si riciclano macchine esistenti. Ma l'OpEx non è trascurabile: consumi elettrici, raffreddamento, manutenzione e aggiornamenti si sommano nel tempo. A questi si aggiunge il costo del lavoro umano: mettere in piedi una pipeline di tiering, risolvere i colli di bottiglia, monitorare i trasferimenti e documentare le scelte richiede competenze che non sono gratuite. Il vero costo di una configurazione simile è spesso nascosto nell'ingegnerizzazione, non nell'hardware.
C'è anche un rischio di lock-in operativo. Un sistema che dipende da una specifica combinazione di storage persistente, driver, framework e modelli può diventare difficile da mantenere e da evolvere. Le prestazioni dichiarate possono variare in base alla versione del software, alla dimensione del batch, alla lunghezza dei prompt e alla tipologia di accesso al checkpoint. Chi vuole replicare l'esperimento deve trattare il risultato come un punto di partenza per una valutazione interna, non come una configurazione pronta per la produzione.
Il segnale resta comunque rilevante: la soglia economica e tecnica per l'inference self-hosted di modelli molto grandi non è più determinata soltanto dalla VRAM complessiva. Conta anche la capacità di orchestrare memoria volatile e persistente, e questo sposta l'attenzione dal puro acquisto di GPU alla progettazione del sistema. È un cambiamento che può favorire chi ha già competenze di infrastruttura on-premise e penalizzare chi cerca soluzioni chiavi in mano.
Chi beneficia della soglia più bassa e chi deve ripensare i prezzi
Il primo effetto di esperimenti come questo è l'allargamento della platea che può toccare con mano modelli di scala enorme. Homelabber, ricercatori indipendenti, piccoli laboratori e team aziendali con budget limitati possono eseguire checkpoint che fino a poco tempo fa sembravano riservati ai grandi provider. Non è solo una questione di prestigio tecnico: l'accesso diretto ai pesi consente di studiare il comportamento del modello, fare benchmark su dataset interni e costruire valutazioni qualitative senza intermediari.
Sul mercato dei fornitori di servizi cloud, l'impatto non è immediato né lineare. I datacenter mantengono vantaggi enormi su scala, affidabilità, latenza e integrazione. Ma per workload saltuari o batch, la pressione sul pricing può aumentare. Se una parte della sperimentazione può migrare su hardware locale a costo marginale contenuto, i provider devono giustificare il valore aggiunto dell'infrastruttura gestita, della sicurezza operativa e degli strumenti di orchestrazione. Non significa che i cloud provider escano indeboliti: significa che la concorrenza si sposta su un terreno più articolato, dove il prezzo per ora di GPU non è l'unica variabile.
Anche i produttori di hardware e i fornitori di storage possono leggere un segnale. La domanda di storage a bassa latenza, memory pooling e interconnessioni più efficienti potrebbe crescere non solo nei datacenter, ma anche in configurazioni più piccole. Le tecnicie che riducono il gap tra memoria persistente e memoria volatile diventano più strategiche quando il checkpoint non può essere interamente ospitato in VRAM. Tuttavia, il mercato consumer e prosumer resta sensibile al prezzo: la diffusione di queste soluzioni dipenderà dalla capacità di offrire benefici concreti senza costi proibitivi.
C'è infine un effetto di secondo ordine sulla ricerca e sull'open source. Quando un homelab può eseguire un modello da 2,8 trilioni di parametri, sia pure lentamente, il controllo sui modelli diventa meno astratto. La possibilità di ispezionare, testare e confrontare checkpoint enormi su hardware proprio alimenta un ecosistema di analisi indipendente. Non è una rivoluzione commerciale nell'immediato, ma cambia le condizioni al contorno per chi costruisce strumenti, dataset e metodi di valutazione.
Cosa guardare nei prossimi mesi
Il primo segnale da monitorare è l'evoluzione dei framework di inference nel trattamento del tiering. Oggi molte pipeline sono ottimizzate per il caso in cui i pesi stanno in VRAM o vengono caricati a blocchi su una singola macchina. La direzione interessante è quella di sistemi che descrivono esplicitamente dove risiede ogni porzione del modello, con politiche di prefetching e rilascio configurabili. Se questa pratica diventa standard, il confine tra VRAM, RAM e storage persistente diventerà una scelta progettuale ordinaria, non un esperimento da appassionati.
Il secondo fronte riguarda la memoria persistente e le interconnessioni. Tecnologie come CXL e l'evoluzione degli storage a bassa latenza possono ridurre ulteriormente la distanza tra memoria di sistema e memoria persistente. Non servono annunci eclatanti: basta osservare se i tempi di accesso e la banda disponibile per i checkpoint migliorano al punto da rendere il tiering più trasparente. Anche l'integrazione tra GPU e storage diretto, con accesso a memoria persistente senza passare attraverso la CPU, potrebbe cambiare le prestazioni di questi scenari.
Il terzo segnale è sul lato dei modelli. Se l'architettura dei Large Language Models continuerà a separare parametri attivi e inattivi, o se la sparsità diventerà una leva esplicita, lo spazio per il tiering si allargherà. Un modello che usa solo una frazione dei parametri per ogni token è naturalmente più adatto a essere eseguito su hardware eterogeneo. Non bisogna confondere questo con una riduzione del costo computazionale complessivo: il checkpoint resta enorme, ma la pressione sulla VRAM diminuisce se la parte attiva è limitata.
Infine, il punto meno visibile ma più importante è l'operatività. Le organizzazioni che oggi valutano deployment on-premise non hanno solo bisogno di hardware più accessibile: hanno bisogno di modi per misurare il costo reale, la stabilità e la sicurezza di configurazioni eterogenee. I framework analitici servono proprio a questo: trasformare un esperimento in una decisione di infrastruttura. Non si tratta di dire se due RTX 3090 e Optane siano una soluzione valida in assoluto, ma di capire in quali condizioni un compromesso di memoria e latenza è accettabile.
Il confine non è più il numero di GPU
L'esperimento con Kimi non va letto come un record prestazionale. Va letto come una prova che la distanza tra un homelab e un datacenter non si misura soltanto in numero di GPU o in teraflop. Si misura nei compromessi di memoria, nella capacità di orchestrare livelli diversi e nella disponibilità ad accettare una latenza elevata in cambio di controllo e autonomia. Tre token al secondo sono lenti per un chatbot, ma possono essere sufficienti per una prova di qualità o per una validazione interna.
Il cambiamento strutturale è che il costo di ingresso per l'inference self-hosted non è più dettato esclusivamente dalla VRAM complessiva. La gerarchia di memoria diventa una variabile di progetto, con implicazioni per chi sviluppa software, per chi compra hardware e per chi vende servizi cloud. Non c'è un vincitore unico: ci sono trade-off più complessi e una maggiore responsabilità nella progettazione del sistema.
Per chi segue AI-RADAR, il punto è mantenere una lettura sobria. Le configurazioni eterogenee non trasformano un homelab in un datacenter, né rendono obsolete le infrastrutture cloud. Ma spostano l'asticella della sperimentazione e costringono a valutare con più precisione dove finisce il risparmio hardware e dove inizia il costo operativo. È esattamente il tipo di segnale che merita un'analisi strutturale, non un titolo sensazionalistico.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!