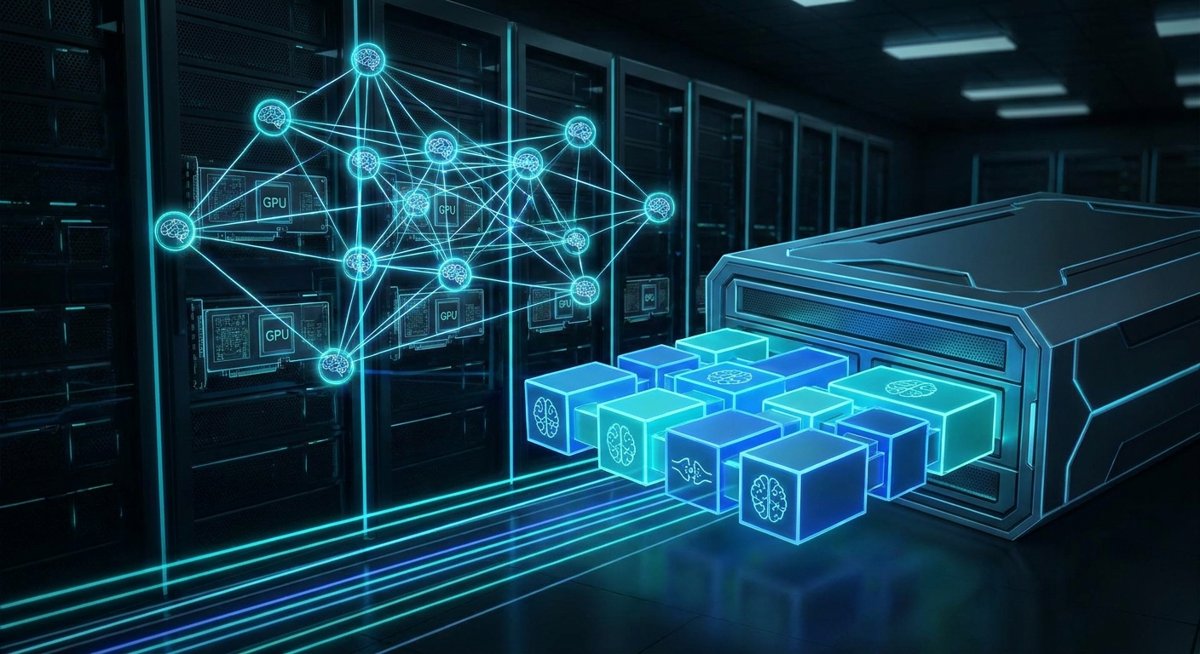
Il panorama dell'intelligenza artificiale generativa è in costante evoluzione, ma alcuni segnali indicano cambiamenti strutturali che meritano un'attenzione particolare da parte di chi progetta e gestisce infrastrutture. La recente discussione, innescata da Robert Sinclair su Reddit, riguardo la distribuzione di adattatori LoRA (Low-Rank Adaptation) anziché intere versioni «uncensored» di Large Language Models (LLM), non è un semplice dibattito tecnico. Rappresenta piuttosto un indicatore chiave di una transizione più ampia verso la modularità, con profonde implicazioni per i deployment on-premise, il Total Cost of Ownership (TCO) e la sovranità dei dati.
Per le aziende che valutano o hanno già implementato soluzioni AI self-hosted, il «rumore» di cui parla Sinclair – ovvero la proliferazione di copie quasi identiche di LLM, modificate solo nel comportamento – non è solo una questione di ordine. È un costo tangibile, che si manifesta in requisiti di storage sempre crescenti, un consumo di banda elevato per il download e la sincronizzazione, e un onere di manutenzione e validazione che scala in modo non lineare con il numero di artefatti. Questo segnale suggerisce che l'ecosistema sta maturando, passando da una fase di sperimentazione rapida con artefatti monolitici a una ricerca di efficienza e controllo granulare, essenziale per l'adozione enterprise.
Il Costo Nascosto della Ridondanza Monolitica
L'approccio attuale alla distribuzione dei Large Language Models, prevalentemente incentrato su artefatti monolitici, presenta sfide significative per le infrastrutture self-hosted. Ogni variante di un modello, anche se differisce solo per un fine-tuning comportamentale minimo, viene spesso rilasciata come un'entità completa e indipendente. Questo si traduce in una duplicazione massiccia di gigabyte, o addirittura terabyte, di dati sui repository pubblici e, di conseguenza, sui server locali delle aziende.
Consideriamo l'impatto sul TCO. Lo storage, sebbene il suo costo unitario sia diminuito nel tempo, diventa una voce di spesa rilevante quando si moltiplicano le copie di modelli da decine o centinaia di gigabyte. Per un'organizzazione che deve mantenere diverse versioni di un LLM base, magari con adattamenti specifici per dipartimenti o casi d'uso differenti, la somma dei requisiti di spazio disco può diventare proibitiva. A questo si aggiunge il costo della banda di rete: scaricare e aggiornare regolarmente intere copie di modelli è un'operazione che consuma risorse preziose, rallenta le pipeline di sviluppo e deployment, e può generare costi aggiuntivi, specialmente in ambienti ibridi o con connettività limitata.
Ma il TCO non si esaurisce nelle risorse hardware. La gestione di un catalogo di modelli monolitici e ridondanti comporta un onere operativo considerevole. Ogni nuova versione o variante richiede processi di validazione, scansione di sicurezza e integrazione nelle pipeline di MLOps. Questo non solo rallenta il ciclo di vita del deployment, ma aumenta anche la complessità della governance e della conformità. Per i team DevOps e gli architetti infrastrutturali, distinguere tra un modello base e le sue innumerevoli derivazioni diventa un compito arduo, esponendo a rischi di incoerenza e a un aumento della superficie di attacco. La proposta di Sinclair, quindi, non è solo una questione di efficienza tecnica, ma una risposta diretta a un problema di sostenibilità operativa ed economica per chi gestisce carichi di lavoro AI on-premise.
La Leva della Modularità: Controllo e Efficienza Operativa
L'adozione di un approccio modulare, dove il comportamento di un LLM viene modificato tramite adattatori LoRA applicati a un modello base verificato, offre vantaggi sostanziali in termini di controllo e efficienza operativa. Un LoRA è un insieme di aggiornamenti a basso rango che, pur essendo di dimensioni notevolmente inferiori rispetto al modello completo (spesso nell'ordine dei megabyte anziché gigabyte), può alterare in modo significativo la risposta e la «personalità» del modello.
Per un team che gestisce un'infrastruttura self-hosted, questo significa poter mantenere un'unica copia del modello base, accuratamente selezionata, validata e ottimizzata per l'hardware disponibile (ad esempio, un Qwen3.6-35B-A3B in una specifica quantization). Su questa base stabile, è possibile applicare dinamicamente diversi LoRA a seconda del caso d'uso: uno per il supporto clienti, uno per l'analisi legale, uno per la generazione creativa, e così via. Questo riduce drasticamente i requisiti di storage e banda, poiché solo gli adattatori, molto più piccoli, devono essere scaricati e gestiti.
L'efficienza si estende anche al ciclo di aggiornamento. Quando il produttore del modello base rilascia una patch di sicurezza o un miglioramento delle performance, non è necessario riscaricare e riconvalidare decine di derivate. Basta aggiornare il modello base e verificare la compatibilità con gli adattatori esistenti. Questo semplifica enormemente la gestione delle patch e riduce i tempi di inattività. Dal punto di vista hardware, la modularità può avere un impatto positivo sull'utilizzo della VRAM. Sebbene il modello base debba comunque essere caricato, la capacità di caricare e scaricare rapidamente solo gli adattatori può consentire una maggiore flessibilità nel servire diverse «personalità» del modello su un singolo set di GPU, ottimizzando il throughput e riducendo la latency associata al caricamento di interi modelli. La possibilità di gestire più LoRA in memoria o di scambiarli velocemente apre scenari interessanti per l'ottimizzazione delle risorse di inference.
Sovranità dei Dati e la Nuova Pipeline di Fornitura
La separazione tra il modello base e i suoi adattatori comportamentali ha implicazioni dirette e profonde per la sovranità dei dati e la governance aziendale. In un ambiente on-premise, dove il controllo sui dati e sui processi è prioritario, l'adozione di un modello base «pulito» e verificato, su cui vengono applicati LoRA interni o di terze parti, rafforza la capacità dell'organizzazione di aderire a normative stringenti e policy di sicurezza interne.
Un'azienda può, ad esempio, certificare un modello base per l'uso in ambienti air-gapped o per la gestione di dati sensibili, sapendo che il suo comportamento fondamentale è stato esaminato. Gli adattatori LoRA, che ne modificano le risposte, possono poi essere sviluppati internamente, garantendo che non introducano bias indesiderati o violazioni delle policy. Questo approccio consente un controllo granulare su ciò che il modello «sa» e «dice», un aspetto cruciale per settori come la finanza, la sanità o la difesa, dove la compliance è non negoziabile.
Tuttavia, questa nuova modularità introduce anche una nuova e complessa catena di fornitura. Un LoRA, pur essendo piccolo, è un artefatto che modifica il comportamento di un sistema già potente. La sua provenienza, la sua firma digitale e la sua revisione diventano elementi essenziali. Un adattatore malevolo o anche solo mal documentato potrebbe alterare i guardrail di sicurezza, le policy di moderazione o persino indurre il modello a generare informazioni errate o dannose, con conseguenze potenzialmente gravi. Le organizzazioni dovranno implementare rigorosi processi di verifica per ogni LoRA, sia esso interno o esterno, includendo scansioni di sicurezza, audit comportamentali e sistemi di versioning robusti. La fiducia nella catena di fornitura del software si estende ora alla catena di fornitura degli adattatori di modelli, richiedendo nuovi standard e strumenti per la loro gestione sicura.
Implicazioni per l'Ecosistema e i Modelli di Business
Il passaggio da modelli monolitici a componenti modulari non è solo una questione tecnica, ma un cambiamento che ridisegna gli incentivi e i modelli di business all'interno dell'ecosistema AI. Attualmente, la visibilità e il «credito» per un modello spesso vanno all'autore della versione completa, anche se è solo una leggera variazione di un modello base esistente. Questo incentiva la proliferazione di copie ridondanti.
Con la modularità, gli autori di adattatori LoRA «uncensored» o specifici per nicchie perderebbero la visibilità associata al rilascio di un modello intero, ma guadagnerebbero la possibilità di mantenere un unico adattatore compatibile con diverse architetture di base e livelli di quantization. Questo potrebbe portare a una maggiore specializzazione e a una migliore qualità degli adattatori stessi. I manutentori di repository come Hugging Face, invece di investire massicciamente in storage per duplicati, potrebbero reindirizzare le risorse verso strumenti di ranking, audit e gestione dei metadati per i LoRA. Il valore si sposterebbe dalla quantità di artefatti alla qualità, alla verificabilità e alla documentazione degli adattatori.
Le piattaforme che monetizzano l'hosting dei modelli dovranno ripensare le proprie metriche. Se il download di un LoRA da pochi megabyte sostituisce il download di un modello da decine di gigabyte, i modelli di fatturazione basati sul traffico o sullo storage dovranno evolvere. Potrebbe emergere un mercato più sofisticato per gli adattatori, con servizi di certificazione, marketplace dedicati e strumenti per la gestione del ciclo di vita dei LoRA. Questo spingerebbe l'intero settore verso una maggiore efficienza e una standardizzazione che, a lungo termine, beneficerebbe tutti gli attori, in particolare quelli che operano con vincoli di risorse e di governance.
Oltre il Rumore: Cosa Monitorare per i Deployment On-Premise
La proposta di Sinclair è un segnale chiaro: l'infrastruttura AI sta evolvendo verso una maggiore granularità e controllo. Per i CTO, i responsabili DevOps e gli architetti infrastrutturali che navigano nel complesso panorama dei deployment on-premise, è fondamentale monitorare attentamente questa transizione.
Il primo aspetto da osservare è lo sviluppo di standard e tooling per la gestione dei LoRA. Attualmente, la loro applicazione è spesso manuale o integrata in framework specifici. Saranno necessari strumenti più robusti per il versioning, la composizione, la validazione e il deployment sicuro degli adattatori. Questo include soluzioni per la firma digitale dei LoRA, per la scansione di vulnerabilità e per l'integrazione fluida nelle pipeline di Continuous Integration/Continuous Deployment (CI/CD) esistenti.
In secondo luogo, è cruciale valutare l'emergere di marketplace e repository specializzati per gli adattatori. Questi potrebbero offrire servizi di certificazione e audit, diventando punti di riferimento affidabili per l'acquisizione di LoRA di terze parti. La qualità dei metadati associati a ciascun adattatore – che descrivano il suo scopo, i dati di fine-tuning utilizzati, le performance attese e i potenziali bias – diventerà un fattore discriminante fondamentale. Infine, le organizzazioni dovranno adattare le proprie policy di governance e sicurezza per includere la gestione dei LoRA. Questo significa definire chi può creare, approvare e deployare adattatori, come vengono monitorati e come si gestiscono gli aggiornamenti o le revoche. La direzione tecnica è chiara: meno copie, più moduli verificabili. La sfida per le aziende sarà tradurre questa visione in pratiche operative robuste e sicure, massimizzando i benefici in termini di TCO e sovranità dei dati, senza compromettere la sicurezza e la compliance.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!