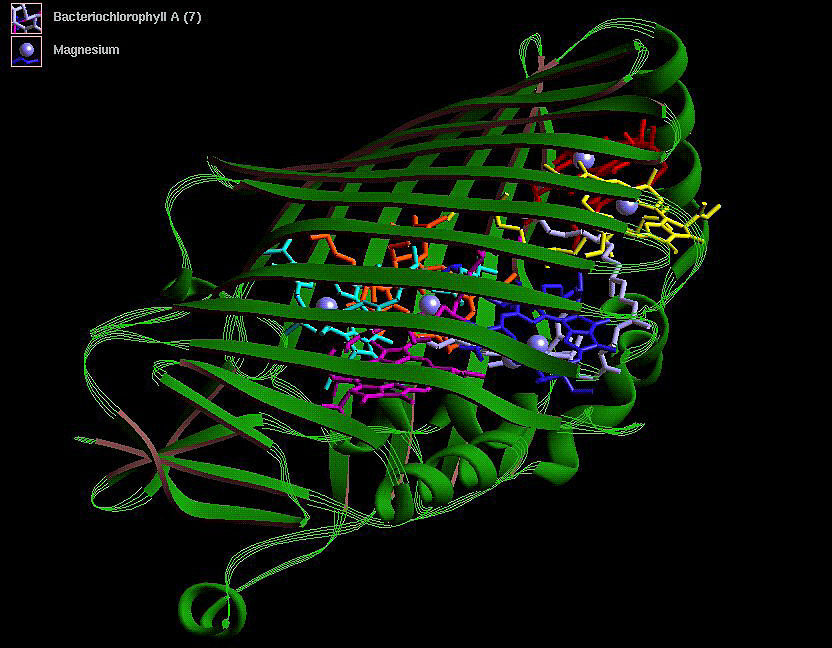
Per anni, progettare una proteina ha significato conoscere non solo la sequenza amminoacidica, ma anche i meccanismi enzimatici, la posizione di singoli amminoacidi e perfino il ruolo delle molecole d'acqua nella zona catalitica. Oggi due annunci paralleli provano a spostare quel punto d'ingresso: un ampio gruppo di ricerca con base in Cina ha presentato uno strumento che accetta prompt in linguaggio naturale e genera proteine con la funzione richiesta; Hugging Face, dal canto suo, ospita ora un tool che fa qualcosa di analogo a livello di DNA. In entrambi i casi, il tasso di successo non è detto che sia alto: la fonte parla esplicitamente della necessità di un laboratorio per separare i progetti validi dalle decine di tentativi falliti.
Il 'quasi' nel linguaggio naturale non è un dettaglio: questi sistemi non sostituiscono la comprensione biologica, la comprimono in un'interfaccia. L'utente esprime una funzione, non i vincoli strutturali che tradizionalmente servivano a definirla. L'analogia con il vibe coding è immediata e, per molti versi, calzante. Nel vibe coding software, il programmatore descrive l'obiettivo in linguaggio naturale, genera codice e itera osservando il comportamento a runtime. Nella progettazione proteica, il 'runtime' è un esperimento wet-lab: costoso, lento e non sempre deterministico. Questo cambia radicalmente l'economia del processo. Prima il collo di bottiglia stava nella conoscenza strutturale necessaria a impostare il problema; adesso si sposta a valle, nella capacità di testare rapidamente molte varianti e scartare quelle che non funzionano. Chi dispone di automazione di laboratorio, sequenziamento ad alta processività o pipeline di screening fenotipico guadagna un vantaggio competitivo enorme. Chi invece puntava soprattutto sull'esperienza manuale di modellazione strutturale vede ridursi il valore della sola competenza teorica, a favore della capacità di progettare esperimenti e interpretare risultati.
Un secondo effetto, meno visibile ma strutturale, riguarda la natura dei dati. Le sequenze proteiche e di DNA generate da questi strumenti possono essere considerate proprietà intellettuale sensibile: un candidato terapeutico, un enzima per processi industriali, un costrutto per la biologia sintetica. Usare un servizio cloud pubblico per generarle significa far transitare prompt e output su infrastrutture di terzi. Non è un problema nuovo, ma diventa più acuto quando l'interfaccia a linguaggio naturale abbassa la barriera e allarga la platea di utenti meno consapevoli dei rischi di esposizione. Per chi valuta deployment on-premise, esistono trade-off tra controllo dei dati, costo dell'infrastruttura e velocità di iterazione: la generazione può essere leggera, ma la validazione sperimentale resta comunque fuori dal perimetro digitale. AI-RADAR offre framework analitici su /llm-onpremise per ragionare su questi equilibri, senza soluzioni preconfezionate.
Il segnale più interessante è che questi strumenti non eliminano il laboratorio, lo rendono il vero differenziatore. Se la generazione di candidati diventa abbondante e a basso costo, il valore si concentra sulla capacità di filtrare. È lo stesso pattern visto con i Large Language Models generalisti: produrre testo è ormai commodity, ciò che conta è la pipeline di verifica, il contesto operativo e la qualità dei dati di feedback. In biologia, questo potrebbe accelerare il passaggio da tool di progettazione a piattaforme closed-loop dove modello, automazione e analisi convivono nello stesso stack. E, di riflesso, spinge chi fa ricerca o sviluppo a chiedersi dove debba risiedere quel loop: in cloud per elasticità o on-premise per controllo e sovranità.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!