Una voce che tocca il nervo scoperto della VRAM consumer
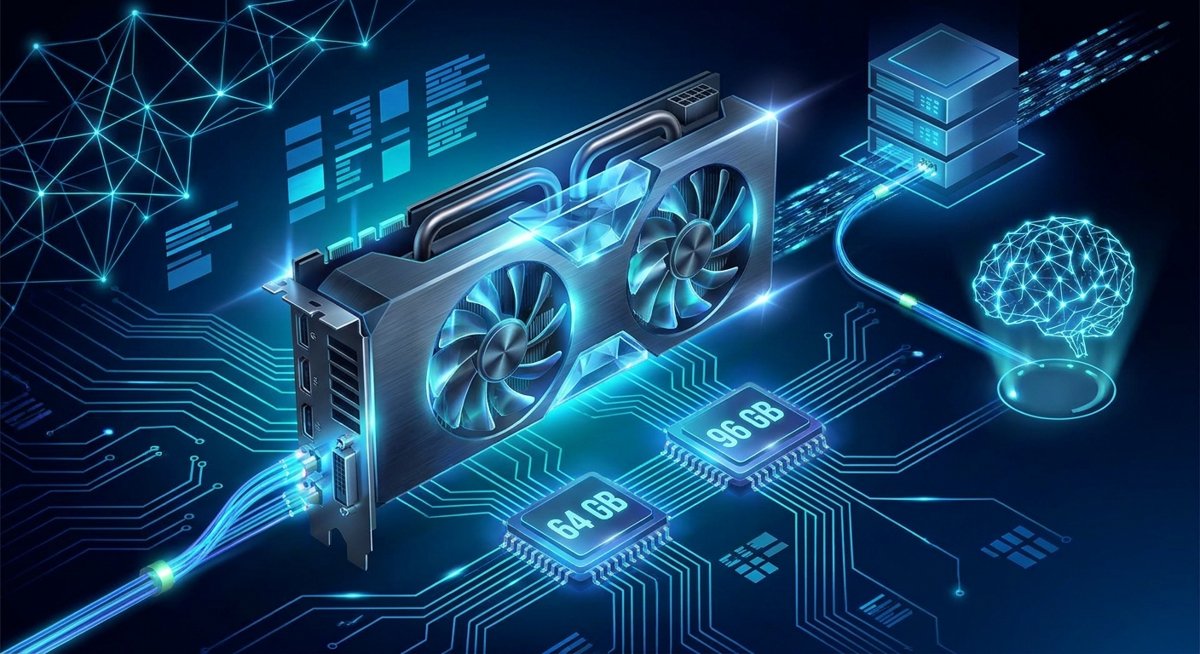
La notizia circola con il condizionale d'obbligo: un tecnico di riparazione statunitense avrebbe indicato l'esistenza di GeForce RTX 5090 con 64 e 96 GB di VRAM. La fonte si limita a un post su Reddit e a una discussione collegata, quindi nessuna conferma ufficiale. Eppure, la sola ipotesi ha riacceso il dibattito su un punto che per chi usa LLM in locale è ormai strutturale: la memoria video resta il primo collo di bottiglia per caricare modelli più grandi, mantenere contesti estesi e ridurre il ricorso alla quantization aggressiva.
Non è un dettaglio tecnico di nicchia. Quando un modello non risiede interamente nella VRAM, il sistema deve spostare pesi e attivazioni tra memoria di sistema e GPU, con cali di throughput in inference che vanificano anche l'hardware più performante. Una scheda consumer con 64 o 96 GB cambierebbe l'equazione per chi fa self-hosted: non servirebbe più per forza una piattaforma workstation o il cloud per eseguire modelli di fascia medio-alta con una qualità accettabile. Il punto non è la scheda in sé, ma il costo per gigabyte di VRAM effettivamente utilizzabile dopo driver, sistema operativo e finestra di contesto.
La richiesta di più VRAM nella fascia consumer non nasce dal gaming. Negli ultimi due anni, la diffusione di LLM open weight ha trasformato le GPU GeForce in strumenti di lavoro per sviluppatori, ricercatori e piccoli team. La domanda di memoria video per carichi AI è diventata un segmento di mercato a sé, e la voce sulla RTX 5090 da 64 e 96 GB è il sintomo di questa pressione. Anche se la notizia fosse infondata, il fatto che circoli con insistenza segnala che la carenza di VRAM consumer è percepita come un limite reale, non come un capriccio tecnico.
Il vero parametro: costo per gigabyte di VRAM utile
Quando si valuta una GPU per LLM on-premise, il dato grezzo della VRAM è solo il punto di partenza. Driver, buffer di sistema, contesto del modello e temporanei di calcolo riducono la memoria effettivamente disponibile. Per un carico di inference con finestre di contesto ampie, la differenza tra 24 e 32 GB può diventare invisibile, mentre tra 32 e 64 GB si apre spazio per modelli più grandi o per quantization meno aggressiva. Il parametro che conta davvero è il costo per gigabyte di VRAM utile, non il prezzo di listino diviso per la capacità nominale.
Una scheda consumer con 64 o 96 GB ribalterebbe questo calcolo rispetto alle GPU professionali. Oggi chi ha bisogno di più VRAM spesso paga un sovrapprezzo per funzionalità enterprise—ECC, vGPU, driver certificati—che non sempre servono in contesti di sviluppo o piccola produzione. Se la voce fosse confermata, la fascia consumer offrirebbe una via più economica per chi privilegia la capacità di memoria, ma senza le garanzie e il supporto delle workstation. Il TCO non si esaurisce nell'acquisto: consumi, raffreddamento, manutenzione e sostituzione in garanzia diventano variabili critiche quando si assemblano nodi locali con più schede consumer.
C'è però un errore da evitare: più VRAM non significa automaticamente più token al secondo. La larghezza di banda della memoria e la potenza di calcolo restano decisive per il throughput in inference. Una scheda con il doppio della memoria ma la stessa architettura non raddoppia la velocità; semplicemente evita lo swapping e mantiene il modello residente in VRAM. È un vantaggio concreto per carichi prolungati e per la latenza di primo token, ma non sostituisce la necessità di una GPU bilanciata.
Self-hosted: modelli, contesto e fine-tuning leggero
Per chi gestisce LLM in locale, l'aumento di VRAM apre tre scenari immediati. Il primo è la possibilità di caricare modelli con un numero maggiore di parametri senza dover ricorrere a quantization a 4 bit o inferiori. La quantization riduce l'occupazione di memoria ma introduce un degrado nella qualità delle risposte, soprattutto su compiti complessi. Con 64 o 96 GB, si potrebbe eseguire un modello di fascia medio-alta a 8 bit o addirittura in precisione mista, mantenendo una qualità più vicina a quella originale.
Il secondo scenario riguarda la finestra di contesto. Modelli con contesti estesi consumano VRAM in modo non lineare: ogni token aggiuntivo richiede memoria per le attivazioni e per la cache di attenzione. Una scheda con più VRAM consente di gestire documenti lunghi, sessioni di chat prolungate o pipeline di analisi su interi repository senza dover troncare il contesto. Questo è rilevante per applicazioni di knowledge management e per agenti che devono mantenere stato su più passaggi, un ambito in cui il limite di memoria è spesso più vincolante della potenza di calcolo.
Il terzo scenario è il fine-tuning leggero su singola GPU. Oggi il fine-tuning di un LLM su hardware consumer è possibile solo per modelli piccoli o con tecniche come il LoRA che riducono il numero di parametri addestrabili. Con 64 o 96 GB di VRAM, si aprirebbe spazio per esperimenti di adattamento su modelli più grandi senza dover affittare GPU cloud o passare a workstation costose. Restano però limiti strutturali: il fine-tuning richiede più memoria dell'inference perché deve mantenere gradienti e stati ottimizzatore, e la larghezza di banda della memoria consumer potrebbe non reggere il passo. È un'opportunità, non una bacchetta magica.
L'effetto a catena sul mercato delle GPU professionali e sul TCO
Se NVIDIA estendesse davvero la logica delle workstation alla fascia consumer con 64 e 96 GB, il primo effetto collaterale sarebbe sul mercato delle GPU professionali. Chi oggi acquista una scheda workstation soprattutto per la VRAM—non per le funzionalità enterprise—potrebbe vedere nella GeForce una via più economica. Il risparmio iniziale sarebbe rilevante, ma andrebbe valutato contro l'assenza di ECC, vGPU, driver certificati e contratti di supporto. In produzione, un errore di memoria non corretto può tradursi in output incoerenti o crash silenziosi, un rischio che le aziende con requisiti di affidabilità non possono ignorare.
Il TCO di un nodo locale non si misura solo in euro per gigabyte. Un server con quattro o più schede consumer richiede alimentatori adeguati, raffreddamento efficiente e spazio fisico. I driver consumer non sono progettati per funzionare 24/7 in ambienti virtualizzati; gli aggiornamenti possono introdurre regressioni non testate su carichi AI. Le aziende con requisiti di sovranità dei dati potrebbero valutare server locali con più schede consumer, trovandosi però davanti a nodi di supporto, garanzia e affidabilità che non si risolvono con un singolo acquisto. Il risparmio sulla GPU può essere eroso dai costi operativi e dal tempo di gestione.
La partita si gioca sul posizionamento di NVIDIA. Se la voce fosse confermata, l'azienda creerebbe un segmento ibrido: memoria abbondante senza le certificazioni professionali. Per alcuni carichi è una soluzione sensata; per altri è una trappola di costo. La neutralità vendor impone di presentare entrambi i lati: chi beneficia davvero sono i singoli sviluppatori e i piccoli team che possono gestire il rischio, mentre le imprese con SLA stringenti continueranno a guardare alle workstation o ai sistemi certificati.
Sovranità dei dati e architetture locali: il framework strategico
Per la sovranità dei dati, l'ipotesi di una RTX 5090 con 64 o 96 GB ha un peso specifico. Il costo dell'hardware è stato a lungo il principale ostacolo all'adozione di LLM self-hosted in aziende medie e piccole. Se il costo per gigabyte di VRAM scende abbastanza, la pipeline di inference interna diventa sostenibile anche per chi oggi deve inviare prompt e documenti a servizi cloud. Non è solo una questione di privacy: la latenza di rete, i limiti di contesto imposti dalle API e i costi ricorrenti del cloud spingono verso architetture locali quando i dati sono sensibili o quando il volume di richieste è elevato.
Ma il TCO non si esaurisce nell'hardware. Una GPU con più VRAM riduce il bisogno di quantization aggressiva e di swapping, ma non elimina la complessità di gestire un nodo locale: aggiornamenti dei driver, monitoraggio delle temperature, orchestrazione dei modelli, backup e sicurezza. Chi valuta un deployment on-premise deve considerare anche il costo di competenze interne o di servizi di manutenzione. La VRAM abbondante è una condizione necessaria ma non sufficiente per una strategia di sovranità dei dati solida.
Il segnale più importante di questa voce è che la domanda di VRAM consumer per carichi AI non è più un segmento di nicchia. La pressione dal basso—sviluppatori, ricercatori, piccole imprese—sta spingendo i produttori a rivedere i confini tra consumer e professionale. Per chi valuta deployment on-premise, questo significa che i prossimi mesi potrebbero portare opzioni hardware più accessibili, ma anche nuove complessità di scelta. AI-RADAR offre framework analitici su /llm-onpremise per soppesare questi trade-off senza cadere in semplificazioni.
Cosa guardare nei prossimi mesi: segnali e verifiche
La notizia resta una voce da verificare, ma ci sono indicatori concreti da monitorare. Il primo sono gli annunci ufficiali NVIDIA: eventuali varianti della RTX 5090 con capacità di memoria superiori compariranno nei canali di comunicazione dell'azienda, non su Reddit. Il secondo sono i leak dei partner di produzione: produttori di schede custom spesso anticipano configurazioni di memoria nei listini o nei manuali prima del lancio ufficiale. Il terzo è l'evoluzione dei driver: se NVIDIA introducesse supporto per configurazioni di memoria non standard, sarebbe un segnale indiretto.
Sul fronte del mercato, vale la pena osservare la reazione della gamma professionale. Se le schede consumer con VRAM abbondante erodessero le vendite delle workstation, NVIDIA potrebbe rispondere con differenziazione software o con limitazioni artificiali. Al contrario, se la voce si rivelasse infondata, la pressione per più VRAM consumer continuerebbe a crescere, alimentando ulteriori speculazioni e attese.
Per chi usa LLM in locale, il consiglio operativo è di non prendere decisioni di acquisto basate su rumor. Il ciclo di vita dell'hardware AI è breve; aspettare una conferma ufficiale può evitare investimenti prematuri. Nel frattempo, conviene valutare le proprie esigenze reali di VRAM, contesto e precisione, e costruire una pipeline di inference che possa scalare quando arriveranno schede più capaci. La voce sulla RTX 5090 da 64 e 96 GB è un segnale di mercato, non una roadmap.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!