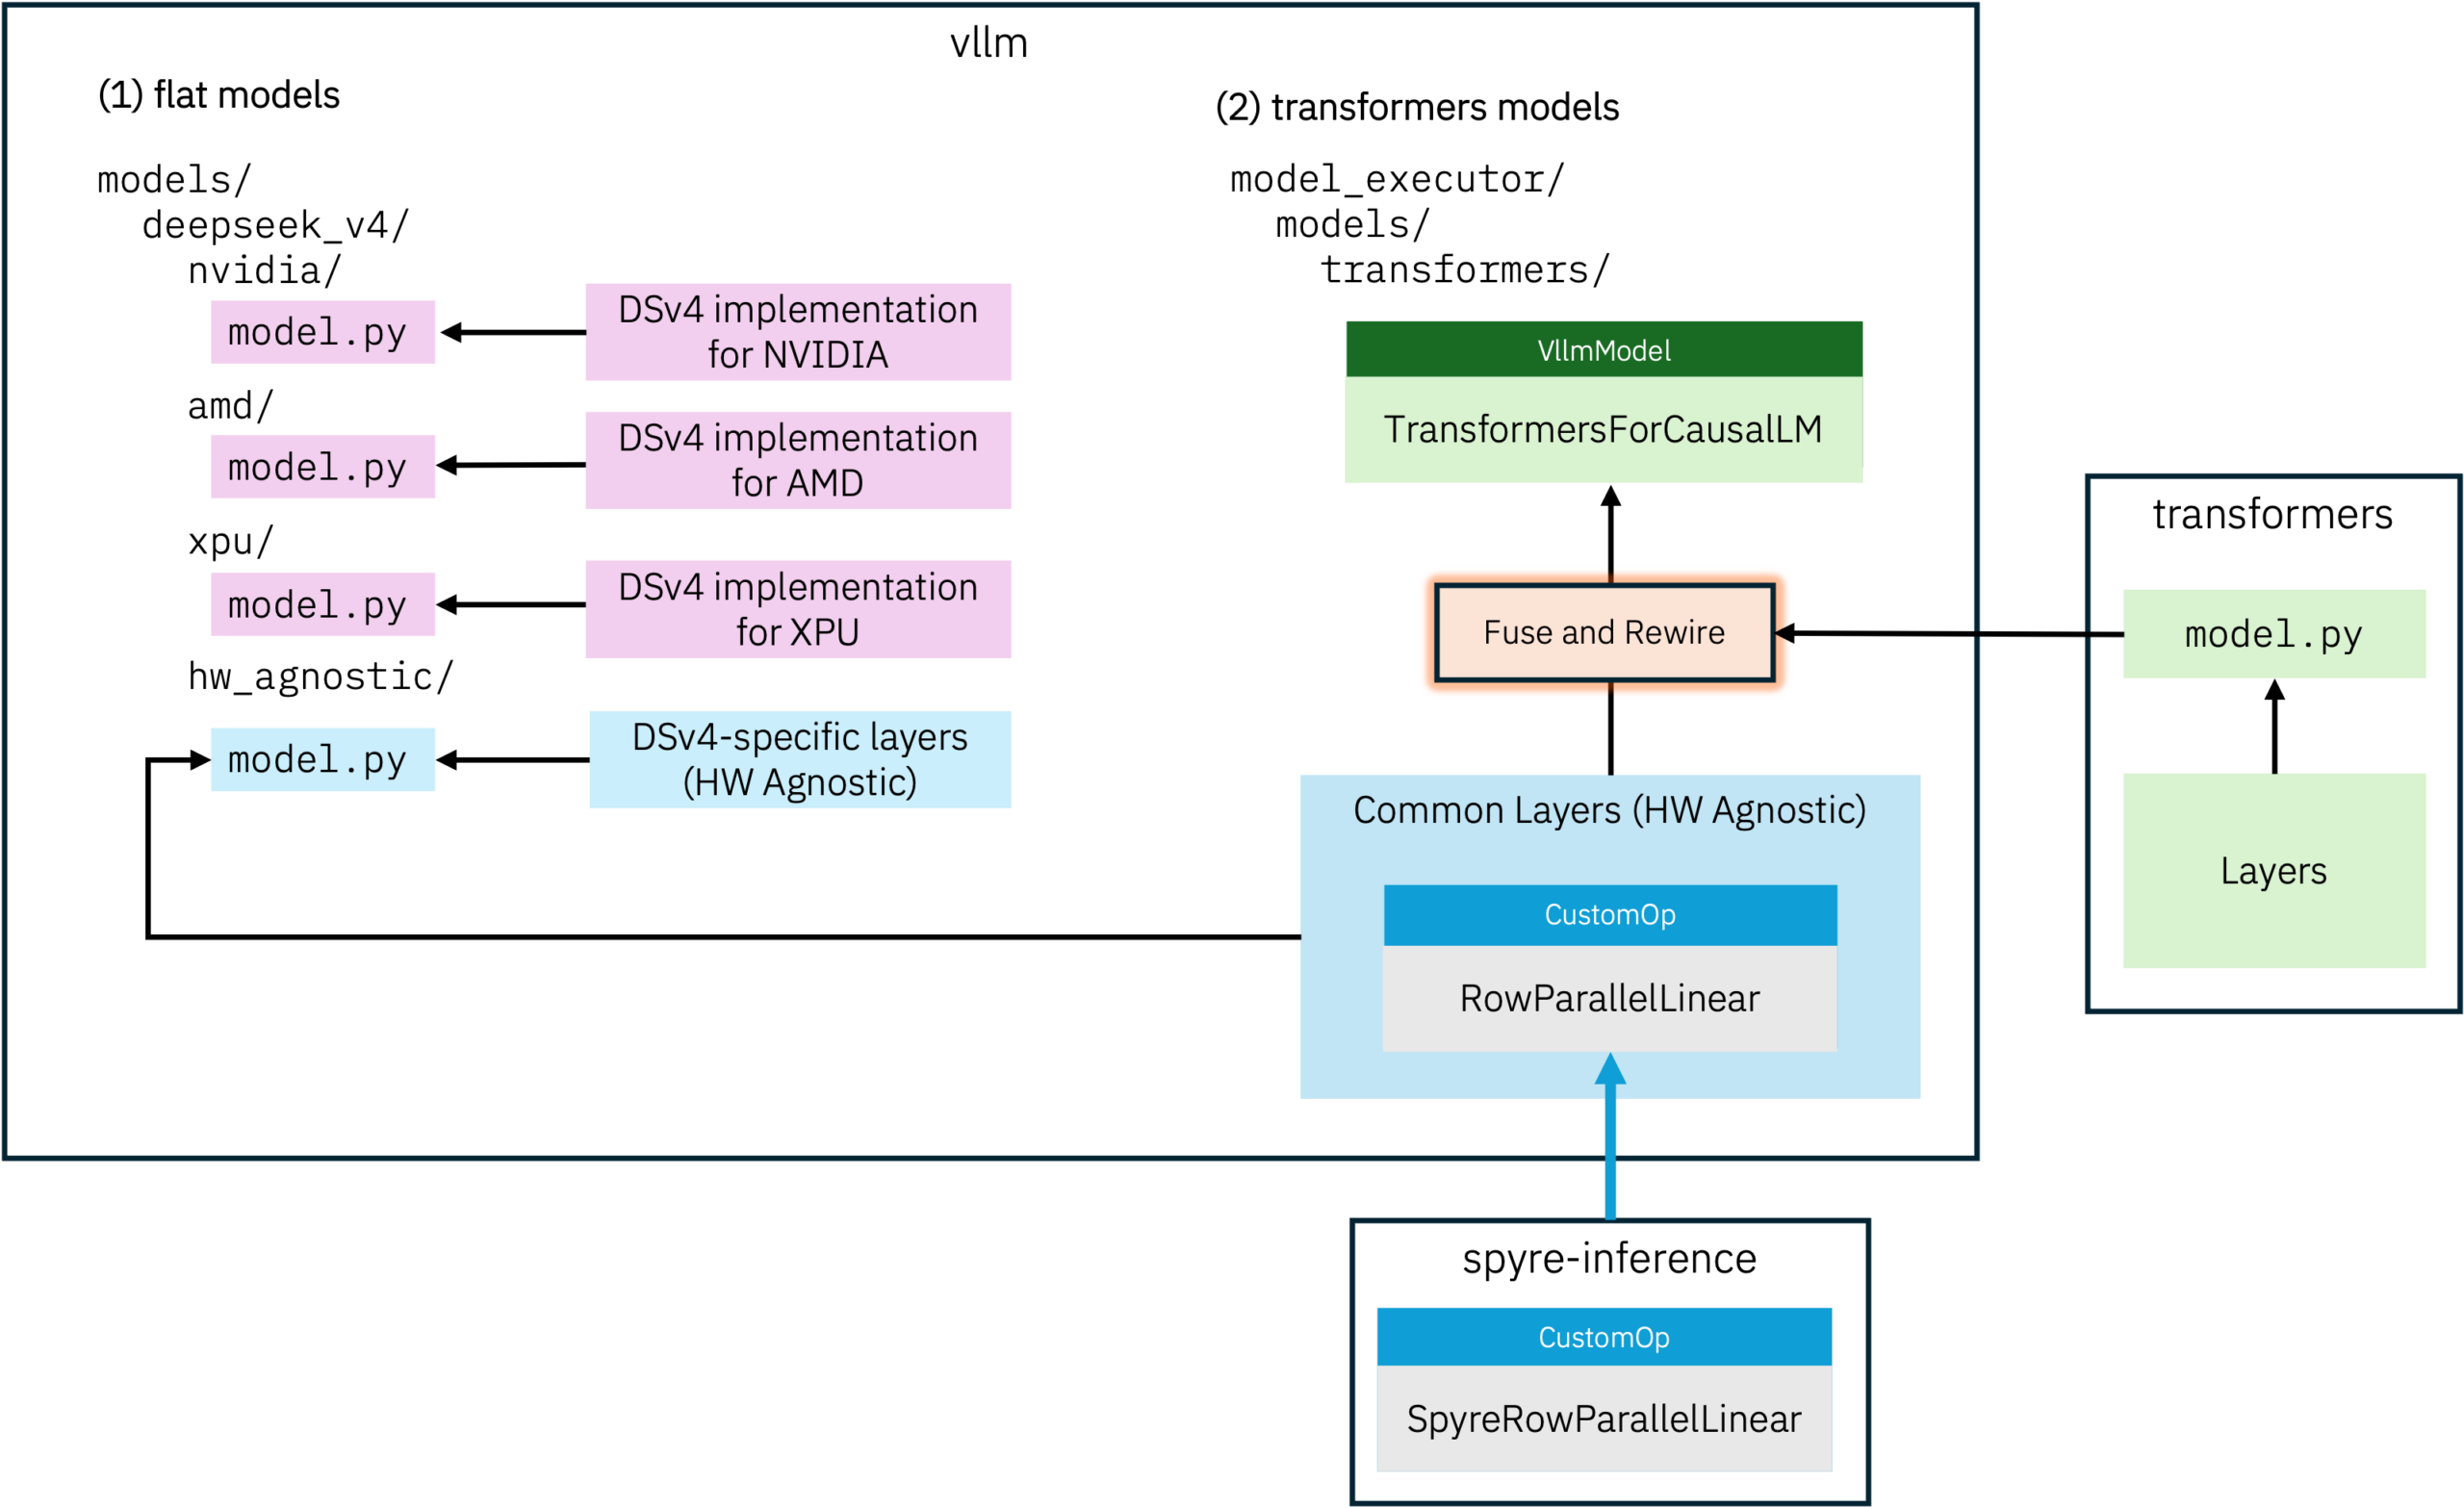
La notizia non è un nuovo modello o un benchmark: vLLM sta ufficialmente separando il percorso dei modelli ottimizzati per le GPU di frontiera da quello della portabilità hardware. Da un lato ci sono i modelli flat, definizioni pensate per acceleratori recenti e ottimizzazioni specifiche; dall'altro arrivano i livelli hardware-agnostic in-tree, pensati per chi deve servire modelli su acceleratori fuori dall'albero, GPU datacenter di generazioni precedenti e schede consumer o prosumer.
Il punto di partenza è un'astrazione che per anni ha funzionato: vLLM usava un insieme di layer condivisi e torch.compile per ottenere alta performance su NVIDIA, AMD, Intel XPU, Google TPU, IBM Spyre, Huawei Ascend e altro. Ma i modelli open-weight di frontiera stanno divergendo: layer personalizzati, kernel ottimizzati e meccanismi di attention completamente diversi. Tenere tutto fullgraph compilabile è diventato un costo per chi aggiunge modelli. Allo stesso tempo, le nuove GPU NVIDIA Blackwell e i sistemi rack-scale richiedono un lavoro di kernel engineering che non si concilia con l'astrazione unica. I modelli flat rispondono a questa esigenza, ma nel processo rompono la compatibilità con torch.compile e con i meccanismi di estensibilità CustomOp usati dai plugin out-of-tree.
Qui sta la tensione: il plugin IBM Spyre, per esempio, dipende da torch.compile e da CustomOp per ottenere prestazioni sul suo acceleratore. Anche il backend transformers di vLLM, usato per modelli più vecchi o esotici, ha bisogno di layer compilabili per non regredire su GPU. E vLLM osserva che una parte significativa degli utenti usa ancora hardware non di frontiera. La soluzione annunciata introduce layer hardware-agnostic in-tree con quattro principi: compilabili, estensibili, isolati e portabili. In pratica, il percorso transformers viene reindirizzato verso i nuovi layer in model_executor/hw_agnostic, attivabili con USE_HW_AGNOSTIC=1. Il team ha già validato il percorso con il plugin Spyre su Gemma 4, Qwen3 e Granite 4.2, e prevede modelli flat con un model.py basato sugli stessi layer.
Sul fronte performance, i test su H100 mostrano che il percorso hardware-agnostic si mantiene entro il 3,4% del throughput totale nativo, con casi leggermente migliori, pur usando implementazioni portabili in PyTorch, Triton o Helion invece di librerie CUDA ottimizzate come FlashAttention e CUTLASS. È un dato importante: la portabilità non è più sinonimo di un crollo delle prestazioni sulle GPU NVIDIA più diffuse.
La tesi di fondo è che vLLM sta riconoscendo che prestazioni di frontiera e portabilità non possono condividere lo stesso percorso di codice senza penalizzarsi a vicenda. La scelta di mantenere due binari in-tree non è una resa, ma un modo per evitare che il progetto si spacchi: chi spinge l'hardware più recente può iterare velocemente sui modelli flat, mentre chi gestisce flotte eterogenee o infrastrutture self-hosted ha un percorso supportato e non deve mantenere fork. Per chi valuta deployment on-premise, questo segnale è chiaro: il parco GPU esistente non diventa obsoleto solo perché la frontiera accelera. I livelli hardware-agnostic riducono la pressione a sostituire hardware o a spostare carichi verso il cloud per restare aggiornati, e preservano la sovranità operativa. Ma introducono anche un costo di complessità: due implementazioni della stessa logica, due percorsi di bug fix e funzionalità, e la necessità per i vendor di acceleratori out-of-tree di mantenere override quando il codice portabile non basta. Non è una soluzione gratuita, ma evita il costo peggiore: un vLLM che diventa di fatto un runtime solo per l'ultima generazione di GPU NVIDIA.


💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!