Topic / Trend Rising

Orchestrazione dell'AI agentica e infrastruttura di memoria

I carichi di lavoro agentici stanno esponendo nuovi colli di bottiglia infrastrutturali legati a cache KV, budget di token ed esecuzioni autonome prolungate. Stanno emergendo strumenti e protocolli per l'aggiornamento delle policy degli agenti e l'orchestrazione locale.

Detected: 2026-09-18 · Updated: 2026-09-18

Articoli Correlati

2026-09-17 • LocalLLaMA

63 ore di inference autonoma su una RTX 3090 per Riemann

Un ricercatore ha lasciato un Qwen 3.8 da 27B in quantization a 4 bit e con 100K token di contesto lavorare per 63 ore su una singola RTX 3090. Ha generato oltre 50 milioni di token senza risolvere la congettura di Riemann, ma mostrando memoria organ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-16 • DigiTimes

Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise

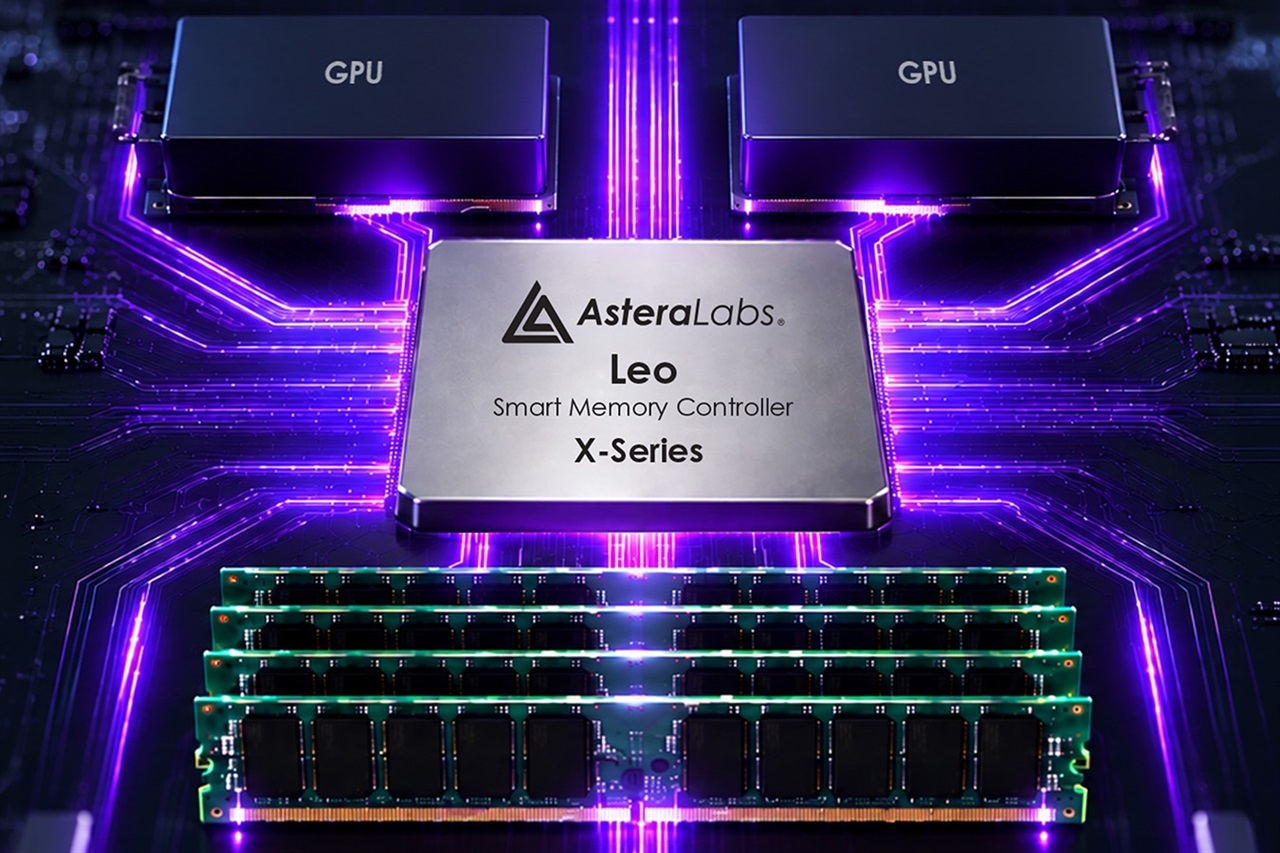
La mossa di Astera Labs sposta l'attenzione dal calcolo alla memoria. La cache KV, critica per i carichi agentici, diventa un vincolo fisico che incide su parallelismo, latenza e TCO. Per i deployment self-hosted e on-premise la gerarchia di memoria ...

2026-09-15 • DigiTimes

Astera Labs affronta il collo di bottiglia della cache KV nell'AI agentica

Quando i sistemi agentici moltiplicano i token di contesto, la cache KV cresce fino a saturare la VRAM delle GPU. Astera Labs punta a questo limite strutturale, segnalando uno spostamento dell'attenzione dal calcolo alla memoria e alle interconnessio...

#Hardware #LLM On-Premise #DevOps
2026-09-15 • TechWire Asia

Ant nomina 10 wallet asiatici per AMP, ma nessuna data di lancio

Ant International ha elencato 10 wallet Alipay+ e 7 acquirer per la Fase I dell’Agentic Mobile Protocol nel 2026. Nessun partner ha indicato una data di go-live e Ant non comunica volumi transati da aprile. Gli impegni dichiarati riguardano identità ...

2026-09-15 • ArXiv cs.LG

Il budget di token diventa la variabile chiave per gli agenti LLM locali

BudgetBench propone un protocollo e un harness per confrontare strategie di memoria negli agenti LLM locali, trattando il budget di token per chiamata come variabile indipendente. I test pilota su qwen2.5:1.5b, Qwen3 30B-A3B e LongMemEval mostrano vi...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic