Topic / Trend Rising

Framework agentici e guasti silenziosi

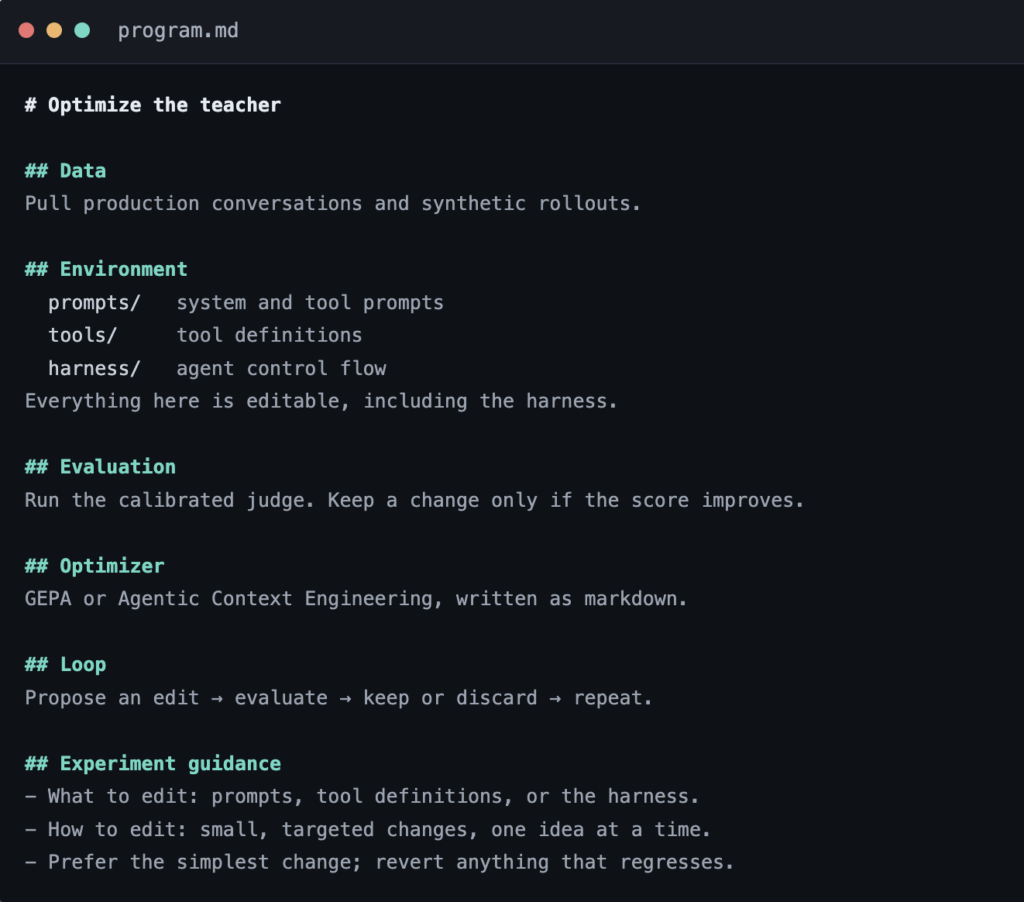
Gli harness agentici per LLM si stanno consolidando attorno a primitive più semplici e strumenti locali, mentre nuovi studi espongono guasti silenziosi quando gli agenti interagiscono con API e sistemi di produzione. Runtime open source e vendor stanno integrando gli agenti nei flussi di lavoro produttivi.

Detected: 2026-09-28 · Updated: 2026-09-28

Articoli Correlati

2026-09-27 • LocalLLaMA

Il collo di bottiglia non è il modello: Codex CLI sblocca un LLM locale

Un utente racconta come un modello Qwen 3.8 Flash Next su due RTX 3090 abbia superato GPT-5.6 Luna in un progetto reale, dopo essere stato collegato a Codex CLI. Il risultato riapre il dibattito su quale strato conti davvero nel deployment locale: no...

#Hardware #LLM On-Premise #DevOps

2026-09-26 • LocalLLaMA

KoboldCpp integra un agente locale: 9 tool, prompt ridotto e 12 GB di VRAM

KoboldCpp ora include un harness agente integrato, attivabile con una spunta o con --agent. L'agente offre nove strumenti integrati, un prompt di sistema da circa 2.000 token e punta a sostituire tool esterni come Opencode, Codex e Claude Code. Richi...

#Hardware #LLM On-Premise #DevOps
2026-09-25 • AI News

Come aggiungere AI al software legacy senza riscriverlo

La convinzione che l’intelligenza artificiale imponga di riscrivere i sistemi legacy è spesso sbagliata. Esistono pattern di integrazione che trattano l’AI come un nuovo strato, non come una nuova fondazione: middleware, RAG, integrazione event-drive...

#LLM On-Premise #Fine-Tuning #DevOps
2026-09-25 • ArXiv cs.AI

Agenti di previsione, il ragionamento non è sempre la scelta giusta

Un gruppo di ricerca ha sottoposto gli agenti di previsione a stress test comportamentali per capire quando retrieval, ragionamento, prior di mercato o analoghi storici meritano fiducia. La scelta del meccanismo dipende dalla fonte. ReliabilityRoute ...

#LLM On-Premise #DevOps
2026-09-24 • DigiTimes

Intel: il coordinamento CPU-GPU al centro dell'AI agentica

Intel sposta il focus sull'AI agentica: il coordinamento tra CPU e GPU diventa il fulcro. La mossa segnala una rilettura dell'hardware per workload che non si esauriscono in una singola inference, ma concatenano ragionamento, tool calling e memoria. ...

#Hardware #LLM On-Premise #DevOps

2026-09-22 • LocalLLaMA

LLM locale e vLLM: automatizzare le modifiche senza perdere il controllo

Un utente self-hosted racconta di aver chiesto al suo LLM locale di modificare vLLM per ridurre i consumi in idle con CUDA_DISABLE_PERF_BOOST=1. La scena mostra potenzialità e rischi dell'automazione operativa: risparmio energetico reale, ma anche ne...

#Hardware #LLM On-Premise #DevOps

2026-09-22 • PyTorch Blog

Shopify ha chiuso il loop: gli errori di produzione diventano pesi del modello

Shopify descrive un loop di apprendimento continuo basato su PyTorch e vLLM: gli errori di produzione diventano aggiornamenti dei pesi del modello. L'agente GraphQL supera la qualità del modello frontier e taglia il costo di serving del 96%, passando...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic