Il collo di bottiglia non è il modello: Codex CLI sblocca un LLM locale
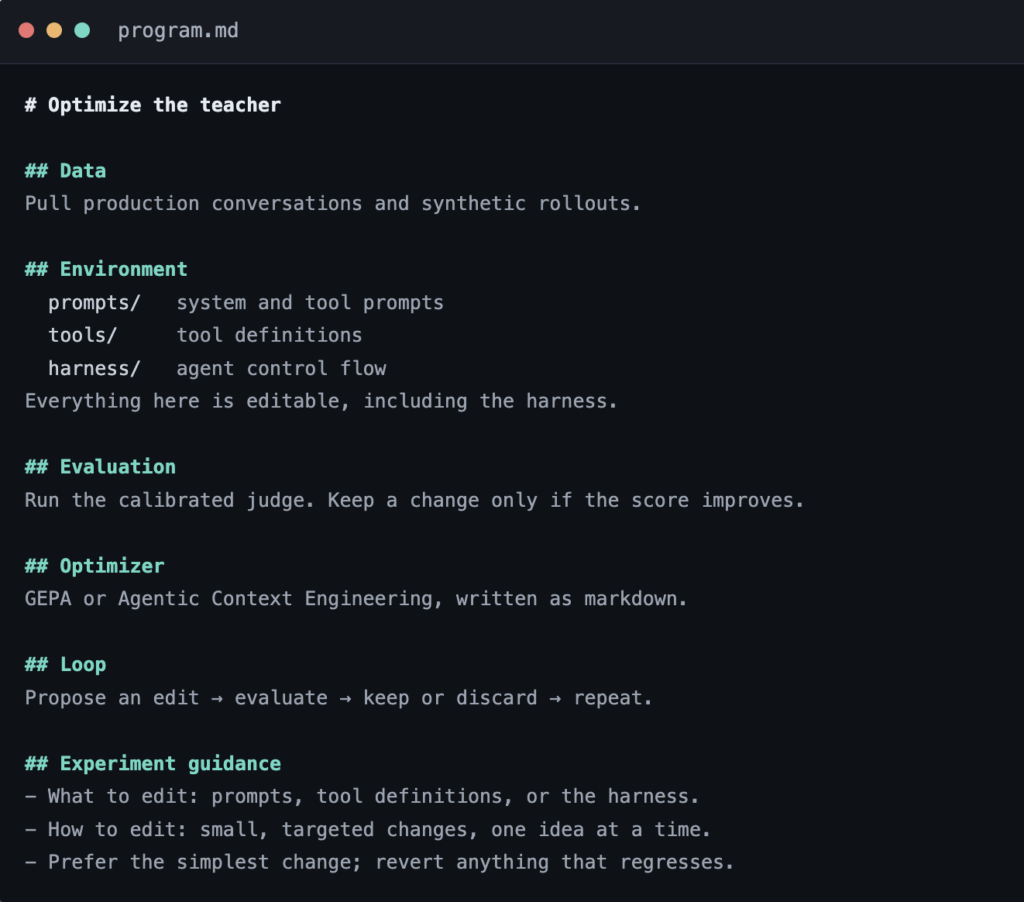
Un utente racconta come un modello Qwen 3.8 Flash Next su due RTX 3090 abbia superato GPT-5.6 Luna in un progetto reale, dopo essere stato collegato a Codex CLI. Il risultato riapre il dibattito su quale strato conti davvero nel deployment locale: no...
#Hardware
#LLM On-Premise
#DevOps