Topic / Trend Rising

Economia degli acceleratori AI e infrastruttura di inference

L'attenzione si sposta dal calcolo puro a memoria, energia ed economia dei token, mentre i carichi agentici mettono sotto pressione la cache KV e i costi delle GPU. Il payback dei TPU/ASIC, la tensione sul packaging TSMC e i prezzi aggressivi di inference definiscono il nuovo collo di bottiglia infrastrutturale.

Detected: 2026-09-16 · Updated: 2026-09-16

Articoli Correlati

2026-09-16 • DigiTimes

Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise

La mossa di Astera Labs sposta l'attenzione dal calcolo alla memoria. La cache KV, critica per i carichi agentici, diventa un vincolo fisico che incide su parallelismo, latenza e TCO. Per i deployment self-hosted e on-premise la gerarchia di memoria ...
2026-09-15 • DigiTimes

Astera Labs affronta il collo di bottiglia della cache KV nell'AI agentica

Quando i sistemi agentici moltiplicano i token di contesto, la cache KV cresce fino a saturare la VRAM delle GPU. Astera Labs punta a questo limite strutturale, segnalando uno spostamento dell'attenzione dal calcolo alla memoria e alle interconnessio...

#Hardware #LLM On-Premise #DevOps
2026-09-15 • DigiTimes

TSMC, la morsa su 3nm, 2nm e CoWoS: AWS, MediaTek e TPU drenano capacità

I nodi TSMC a 3nm e 2nm e il packaging CoWoS restano in tensione mentre AWS, MediaTek e i TPU spostano volumi di capacità. Per chi valuta hardware AI on-premise, la scarsità di acceleratori e interposer si traduce in tempi di attesa e costi sotto pre...

#Hardware #LLM On-Premise #DevOps
2026-09-14 • DigiTimes

Il TPU di Google si ripaga in un anno: la corsa agli ASIC accelera

Secondo DIGITIMES, il TPU di Google recupera l'investimento in circa un anno. Il dato apre prospettive per i ricavi ASIC di MediaTek e Broadcom e segnala che il silicio custom per training e inference è ormai un'opzione economica concreta. Per il mer...

#Hardware #LLM On-Premise #DevOps
2026-09-10 • DigiTimes

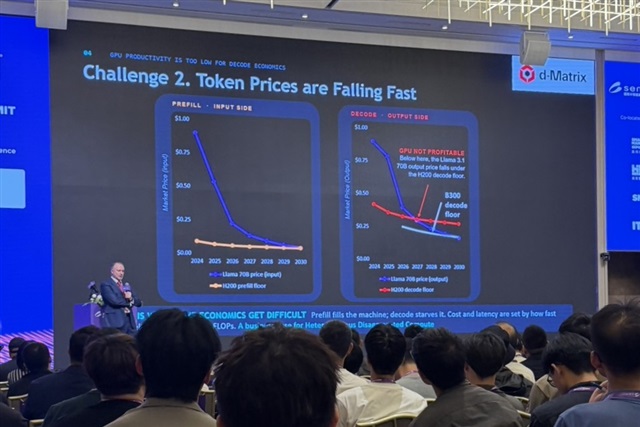
Token in calo: per d-Matrix l’economia delle GPU è sotto pressione

d-Matrix ha presentato al SEMICON Taiwan 2026 un modello di costo per l’inference. Il punto: se i prezzi dei token scendono mentre i costi di ammortamento, energia e banda di memoria delle GPU restano rigidi, i margini per chi vende capacità di calco...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic