Topic / Trend Rising

Agenti AI e affidabilità dell'orchestrazione

I framework agentici si stanno consolidando attorno a primitive minime e harness locali. I guasti silenziosi nelle pipeline agente-strumento e i risultati misti nei benchmark mostrano che orchestrazione e supervisione umana restano il vero collo di bottiglia.

Detected: 2026-09-27 · Updated: 2026-09-27

Articoli Correlati

2026-09-26 • LocalLLaMA

KoboldCpp integra un agente locale: 9 tool, prompt ridotto e 12 GB di VRAM

KoboldCpp ora include un harness agente integrato, attivabile con una spunta o con --agent. L'agente offre nove strumenti integrati, un prompt di sistema da circa 2.000 token e punta a sostituire tool esterni come Opencode, Codex e Claude Code. Richi...

#Hardware #LLM On-Premise #DevOps

2026-09-25 • ArXiv cs.AI

Agenti di previsione, il ragionamento non è sempre la scelta giusta

Un gruppo di ricerca ha sottoposto gli agenti di previsione a stress test comportamentali per capire quando retrieval, ragionamento, prior di mercato o analoghi storici meritano fiducia. La scelta del meccanismo dipende dalla fonte. ReliabilityRoute ...

#LLM On-Premise #DevOps
2026-09-22 • LocalLLaMA

LLM locale e vLLM: automatizzare le modifiche senza perdere il controllo

Un utente self-hosted racconta di aver chiesto al suo LLM locale di modificare vLLM per ridurre i consumi in idle con CUDA_DISABLE_PERF_BOOST=1. La scena mostra potenzialità e rischi dell'automazione operativa: risparmio energetico reale, ma anche ne...

#Hardware #LLM On-Premise #DevOps

2026-09-22 • PyTorch Blog

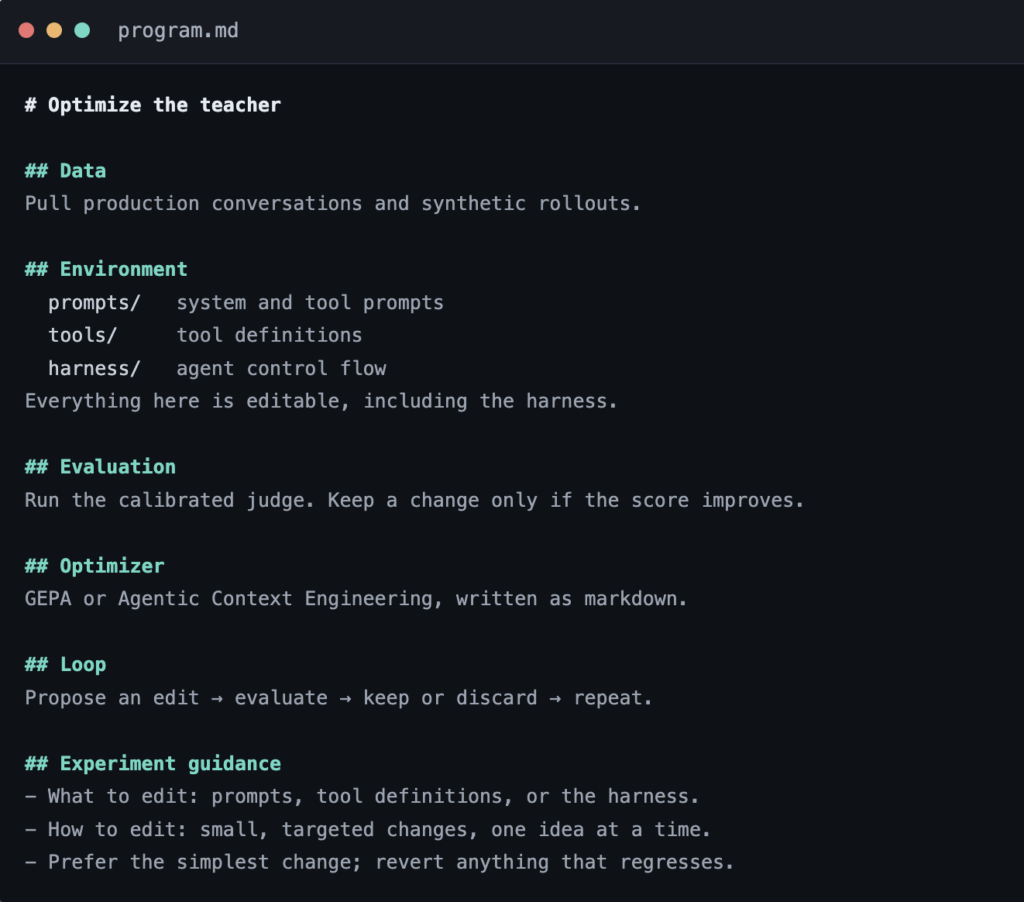
Shopify ha chiuso il loop: gli errori di produzione diventano pesi del modello

Shopify descrive un loop di apprendimento continuo basato su PyTorch e vLLM: gli errori di produzione diventano aggiornamenti dei pesi del modello. L'agente GraphQL supera la qualità del modello frontier e taglia il costo di serving del 96%, passando...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-21 • ArXiv cs.LG

BI-Bench e BI-Agent: il vero divario è nell'orchestrazione dei dati

La BI end-to-end rivela un limite strutturale dei LLM: sotto il 50% di accuratezza senza guida umana. Il guadagno vero arriva da architetture che orchestrano strumenti e da post-training su dati proprietari. Per chi valuta on-premise e self-hosted, i...

2026-09-21 • ArXiv cs.LG

BI-Bench e BI-Agent: il divario dei LLM nella BI end-to-end

Il benchmark BI-Bench, costruito su progetti reali e dashboard pubbliche, mostra che anche i LLM frontier restano sotto il 50% di accuratezza nella business intelligence end-to-end. BI-Agent, un agente tool-augmented che scompone ricerca, join e tras...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic