Il debutto dei futures sulle GPU di CME Group si arena: CFTC frena
Lo stallo dei futures sulle GPU di CME Group, dopo le perplessità della CFTC, complica la pianificazione del TCO per chi costruisce infrastrutture on-premise e self-hosted per LLM.
Cicli accelerati delle TPU e colli di bottiglia nel packaging avanzato stanno ridisegnando l'infrastruttura di calcolo AI, mentre i layer software si adattano per mantenere la portabilità tra GPU e acceleratori. I futures sulle GPU e i runtime hardware-agnostic riflettono una persistente incertezza per i deployment on-premise.
Lo stallo dei futures sulle GPU di CME Group, dopo le perplessità della CFTC, complica la pianificazione del TCO per chi costruisce infrastrutture on-premise e self-hosted per LLM.
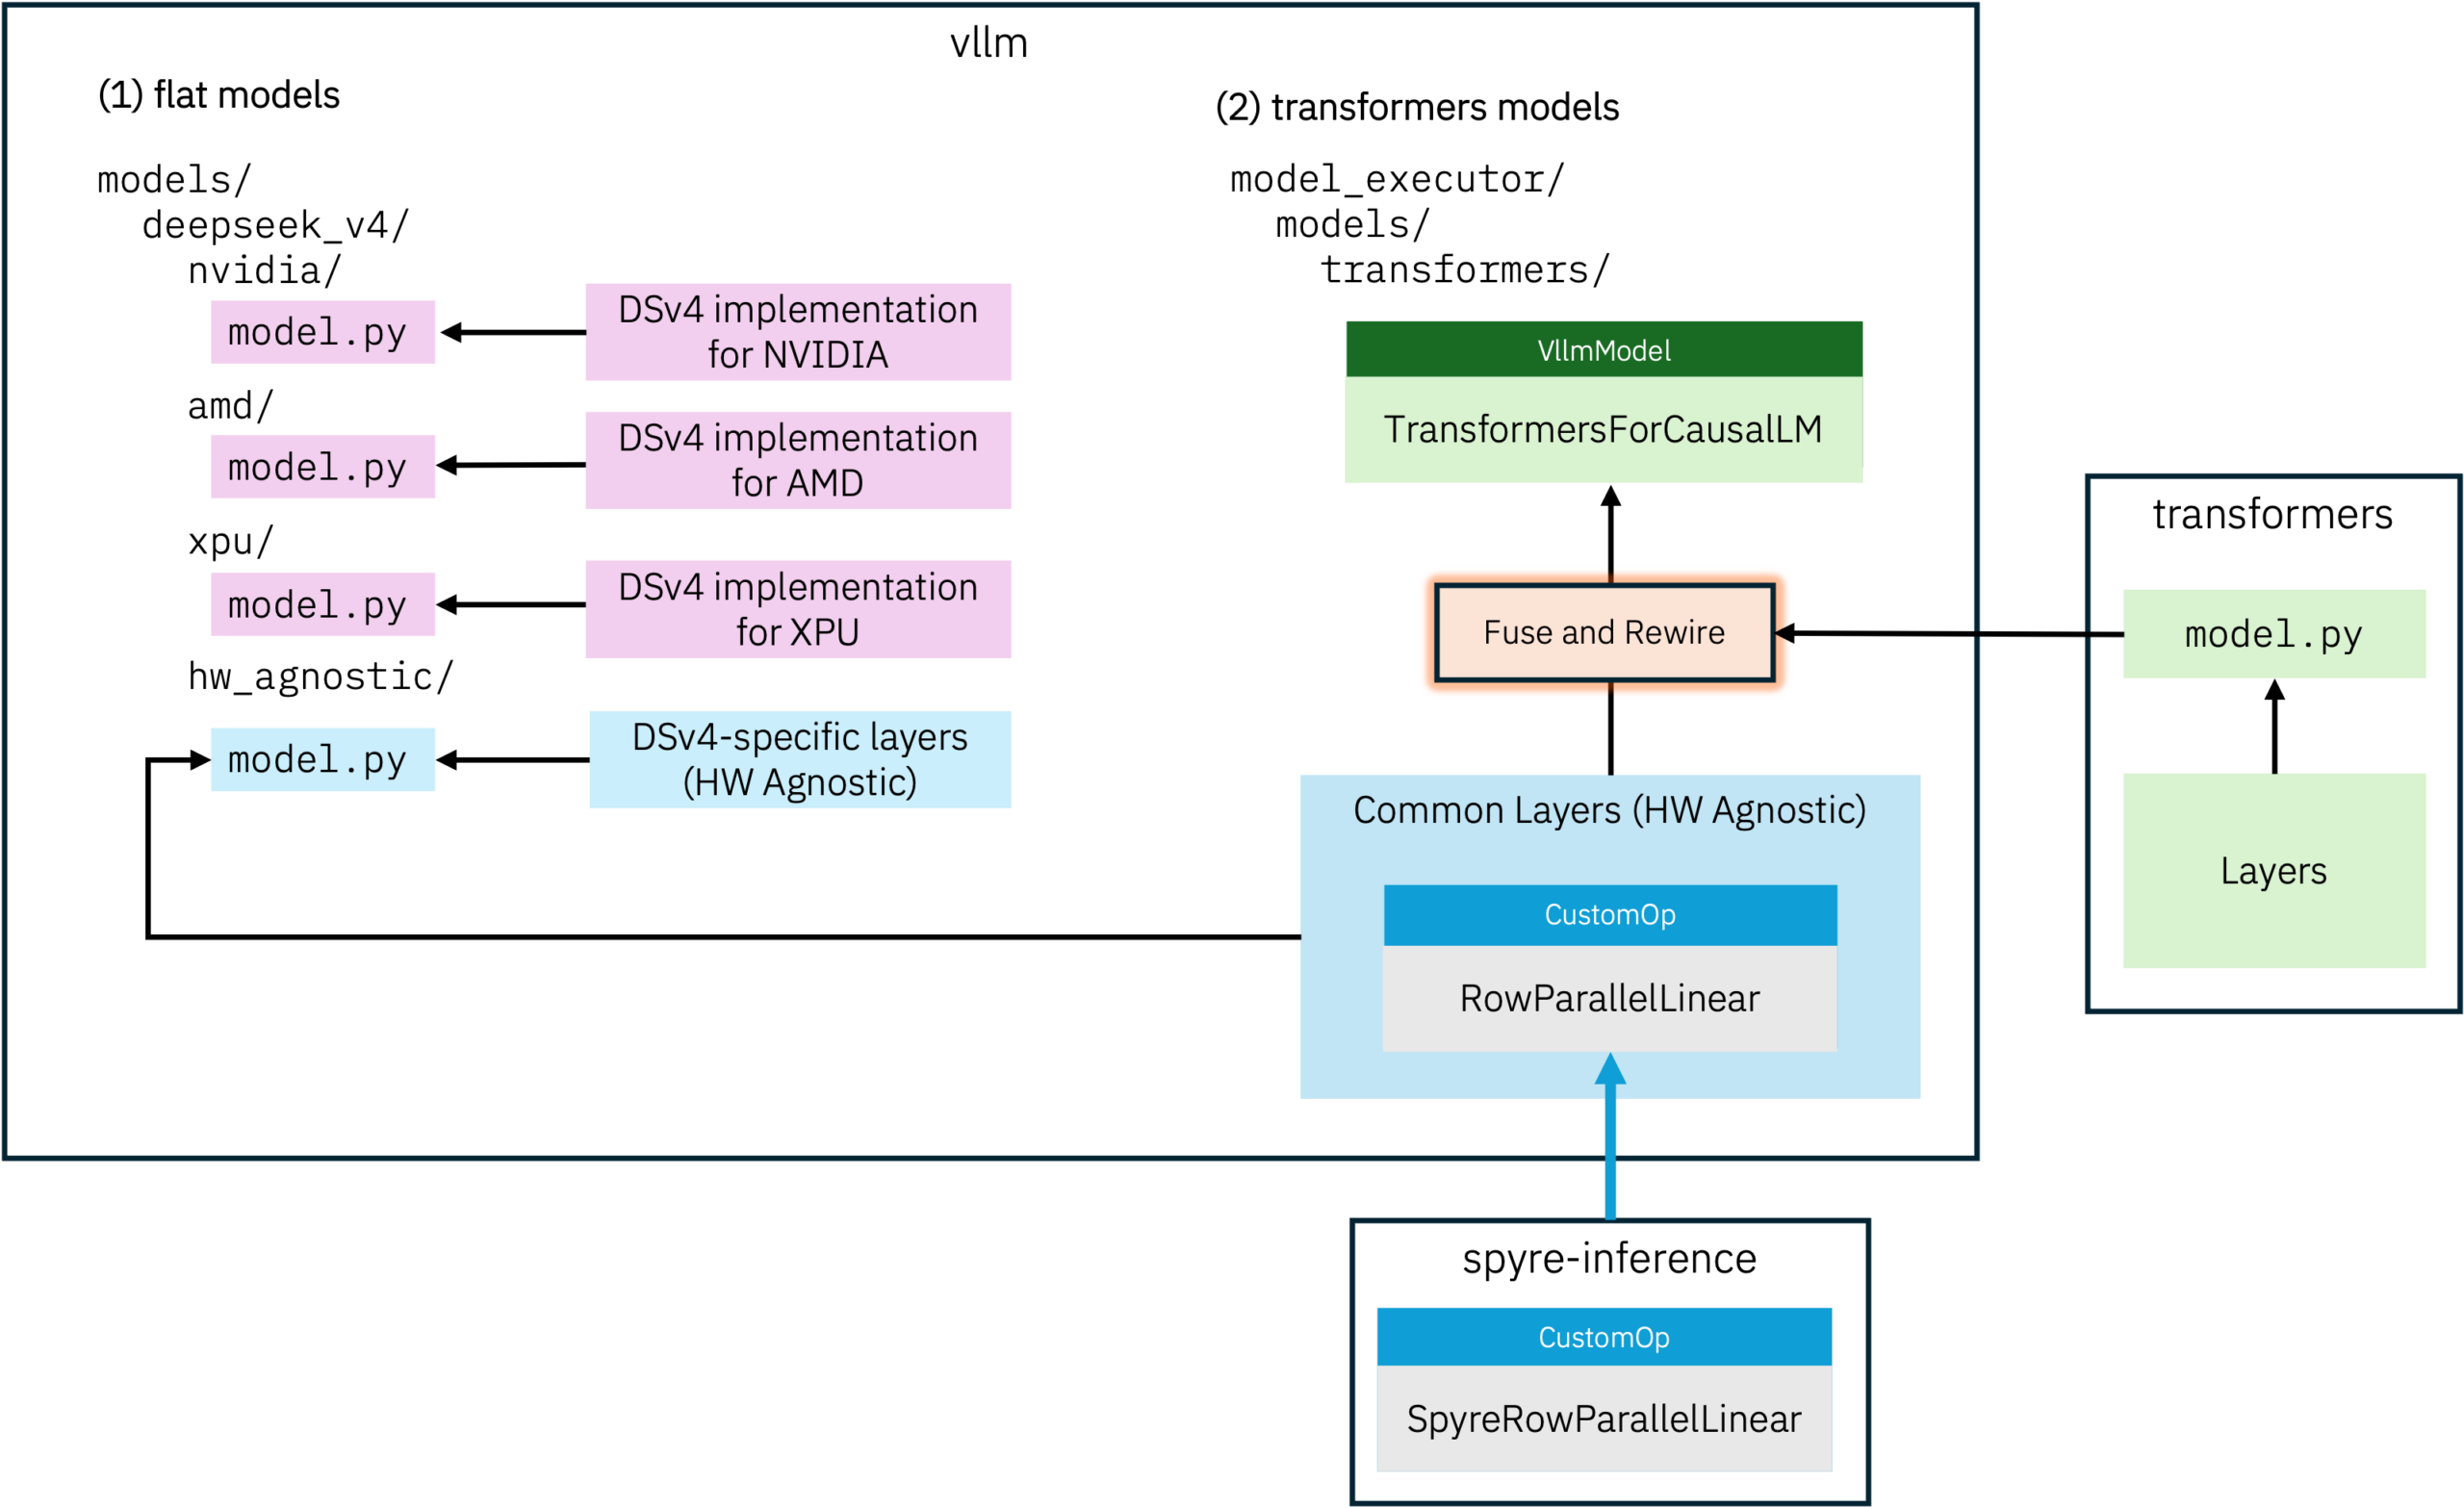
Il progetto vLLM introduce livelli hardware-agnostic in-tree per continuare a supportare acceleratori out-of-tree, GPU datacenter più vecchie e schede consumer. Su NVIDIA H100 il throughput totale resta entro il 3,4% dell'implementazione nativa. La m...
Il progetto open source ZLUDA ha aggiunto il supporto ad alcune API cuFFT di NVIDIA appoggiandosi a hipFFT, il componente dello stack ROCm/HIP di AMD. La novità amplia il perimetro di compatibilità CUDA su GPU non NVIDIA come le Radeon e segnala un c...
Intel ha pubblicato il Compute Runtime 26.35.39758.10 per Windows e Linux. L'aggiornamento tocca OpenCL e Level Zero, abilita LEO per Nova Lake e introduce l'ISA portabile PISA. Per i deployment self-hosted, un'ISA stabile tra generazioni di silicio ...
Google starebbe valutando CoWoS come piano B per i TPU del 2027, perché i rendimenti dei substrati EMIB-T restano sotto le attese. La notizia mette in luce un collo di bottiglia nel packaging avanzato, con effetti potenziali su capacità cloud, costi ...
Google ha delineato un'espansione della capacità di calcolo per l'AI e ha portato il ciclo di sviluppo delle TPU a sei mesi. Un ritmo che avvicina l'hardware specializzato alla logica del software e rafforza il ruolo dei grandi fornitori di cloud, me...