Topic / Trend Rising

Corsa all'hardware e all'infrastruttura AI

Silicio custom, cicli TPU, packaging avanzato e tensioni sull'offerta GPU definiscono una nuova corsa computazionale. Cache KV ed energia emergono come colli di bottiglia strutturali.

Detected: 2026-07-05 · Updated: 2026-09-17

Articoli Correlati

2026-09-16 • DigiTimes

Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise

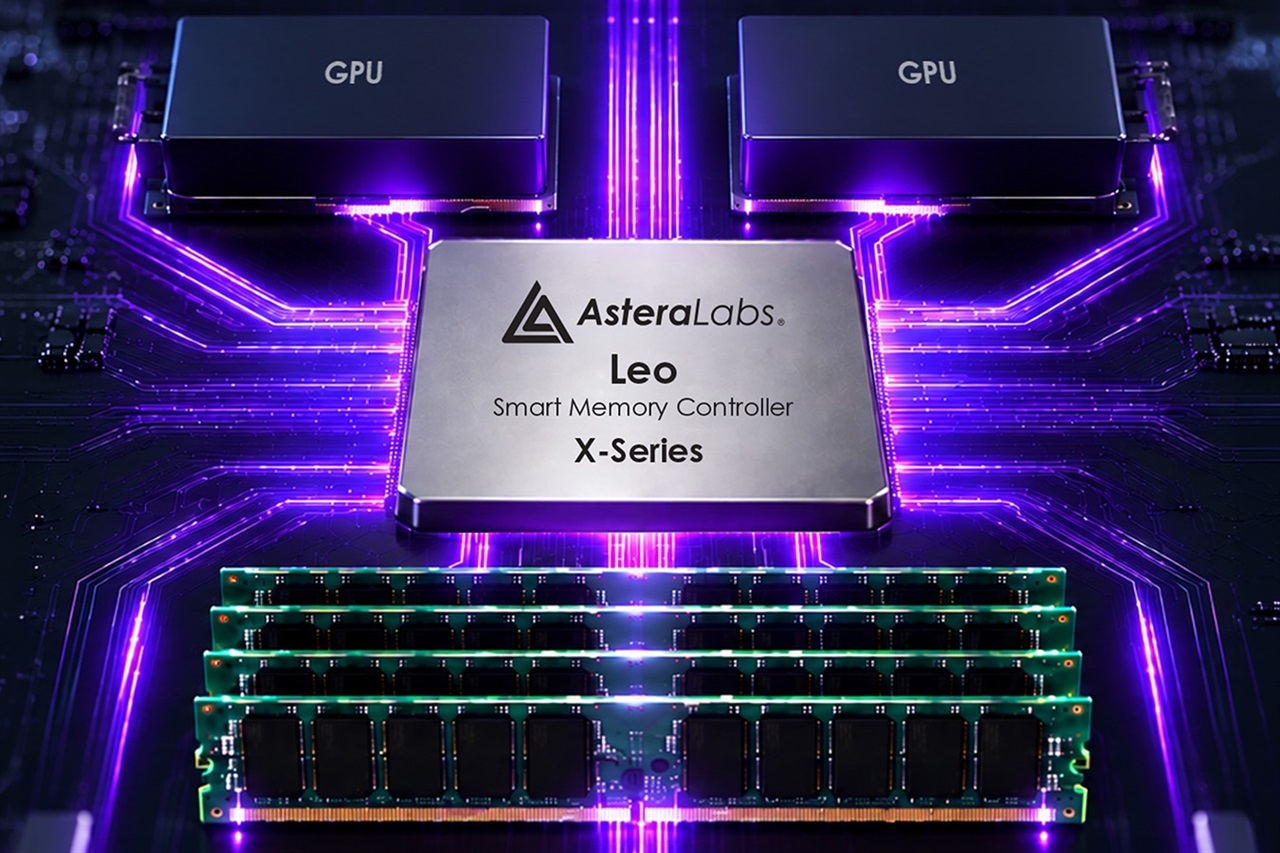
La mossa di Astera Labs sposta l'attenzione dal calcolo alla memoria. La cache KV, critica per i carichi agentici, diventa un vincolo fisico che incide su parallelismo, latenza e TCO. Per i deployment self-hosted e on-premise la gerarchia di memoria ...

2026-09-15 • DigiTimes

Astera Labs affronta il collo di bottiglia della cache KV nell'AI agentica

Quando i sistemi agentici moltiplicano i token di contesto, la cache KV cresce fino a saturare la VRAM delle GPU. Astera Labs punta a questo limite strutturale, segnalando uno spostamento dell'attenzione dal calcolo alla memoria e alle interconnessio...

#Hardware #LLM On-Premise #DevOps
2026-09-15 • DigiTimes

Oltre l’H100: i produttori cinesi puntano alla scala, non solo alla parità

La sfida non è più solo eguagliare l’acceleratore di Nvidia in un singolo benchmark. Il titolo segnala uno spostamento strutturale: i produttori cinesi puntano a piattaforme scalabili, dove contano interconnessioni, ecosistema software e capacità di ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-15 • DigiTimes

TSMC, la morsa su 3nm, 2nm e CoWoS: AWS, MediaTek e TPU drenano capacità

I nodi TSMC a 3nm e 2nm e il packaging CoWoS restano in tensione mentre AWS, MediaTek e i TPU spostano volumi di capacità. Per chi valuta hardware AI on-premise, la scarsità di acceleratori e interposer si traduce in tempi di attesa e costi sotto pre...

#Hardware #LLM On-Premise #DevOps
2026-09-14 • DigiTimes

Il TPU di Google si ripaga in un anno: la corsa agli ASIC accelera

Secondo DIGITIMES, il TPU di Google recupera l'investimento in circa un anno. Il dato apre prospettive per i ricavi ASIC di MediaTek e Broadcom e segnala che il silicio custom per training e inference è ormai un'opzione economica concreta. Per il mer...

#Hardware #LLM On-Premise #DevOps
2026-09-12 • LocalLLaMA

Solo modelli occidentali sugli H100: il vuoto dei 120B con visione

Chi gestisce H100 con vincoli che escludono modelli cinesi parte svantaggiato: nel segmento aperto 120B+ con visione il divario rispetto a GLM, Qwen e DeepSeek è misurabile. Tra i candidati occidentali citati, Inkling Small e Command A+ coprono parte...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-12 • Phoronix

Intel porta il driver Linux per NPU su Ubuntu 26.04 LTS

Venerdì Intel ha pubblicato il driver Linux NPU 1.38, aggiungendo il supporto ufficiale per Ubuntu 26.04 LTS. I componenti user-space open source lavorano con il driver kernel IVPU per sfruttare la NPU dei Core Ultra, un passo concreto per l’inferenc...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-11 • AI News

NVIDIA automatizza la supply chain con Palantir, cuOpt e un LLM da 30B

NVIDIA ha costruito un centro di comando per l’allocazione delle forniture basato su Palantir Foundry e cuOpt. Il sistema combina ottimizzazione MILP e un LLM Nemotron 3.5 Lightning da 30 miliardi di parametri, tre attivi, affinato su due B200 in poc...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-10 • DigiTimes

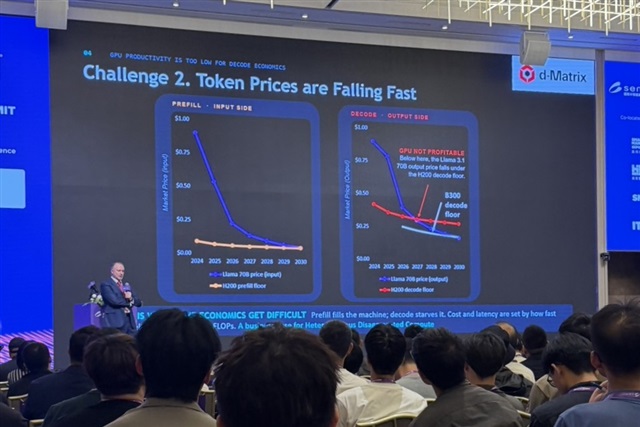
Token in calo: per d-Matrix l’economia delle GPU è sotto pressione

d-Matrix ha presentato al SEMICON Taiwan 2026 un modello di costo per l’inference. Il punto: se i prezzi dei token scendono mentre i costi di ammortamento, energia e banda di memoria delle GPU restano rigidi, i margini per chi vende capacità di calco...

#Hardware #LLM On-Premise #Fine-Tuning
2026-07-02 • DigiTimes

Samsung spinge per il nucleare a sostegno della fab di Gwangju

Il capo della divisione semiconduttori di Samsung, Jeon Young-hyun, ha dichiarato che il cluster di Honam necessita di un'espansione dell'infrastruttura energetica, incluso il ricorso al nucleare. La mossa evidenzia quanto l'affidabilità elettrica si...

#Hardware #LLM On-Premise #Fine-Tuning
2026-06-30 • DigiTimes

TSMC: 2nm e packaging avanzato CoWoS/CoPoS rafforzano la filiera AI

TSMC sta guidando l'innovazione con la tecnicia a 2nm e soluzioni di packaging avanzato come CoWoS e CoPoS. Questi sviluppi non solo consolidano la sua posizione nel settore dei semiconduttori, ma generano anche un significativo impatto positivo sull...

#Hardware #LLM On-Premise #Fine-Tuning

2026-06-30 • DigiTimes

SK Hynix accelera la produzione di HBM: un segnale per il mercato AI

SK Hynix ha annunciato un'accelerazione di dodici anni per la sua fabbrica di Yongin, spinta dalla crescente domanda di High Bandwidth Memory (HBM). Questa mossa evidenzia la pressione sulla capacità produttiva di memoria critica per i carichi di lav...

#Hardware #LLM On-Premise #Fine-Tuning
2026-06-29 • TechCrunch AI

550 miliardi di dollari: i colossi coreani contro la RAMageddon

Samsung e SK hynix, i due maggiori produttori mondiali di chip di memoria, hanno annunciato un investimento complessivo superiore a 550 miliardi di dollari per costruire nuovi impianti di produzione in Corea del Sud. L’obiettivo è scongiurare la temu...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic