Topic / Trend Rising

Efficienza infrastrutturale IA oltre le GPU

Dopo le GPU, i guadagni di efficienza arrivano da rete, banda di memoria e kernel di basso livello. Gli esempi di F5, AMD e Meta mostrano che orchestrazione, spostamento dati e kernel di attention possono moltiplicare il throughput a paritร  di calcolo.

Detected: 2026-10-02 ยท Updated: 2026-10-02

Articoli Correlati

2026-10-02 โ€ข ServeTheHome

BIG-IP Next per Kubernetes: l'efficienza AI si sposta dalla GPU alla rete

Il test F5 su BIG-IP Next for Kubernetes mostra che lo stesso cluster GPU puรฒ rendere piรน del triplo agendo su bilanciamento e instradamento del traffico. Per i deployment on-premise l'efficienza per nodo diventa centrale per il TCO; il rischio รจ leg...

2026-10-01 โ€ข PyTorch Blog

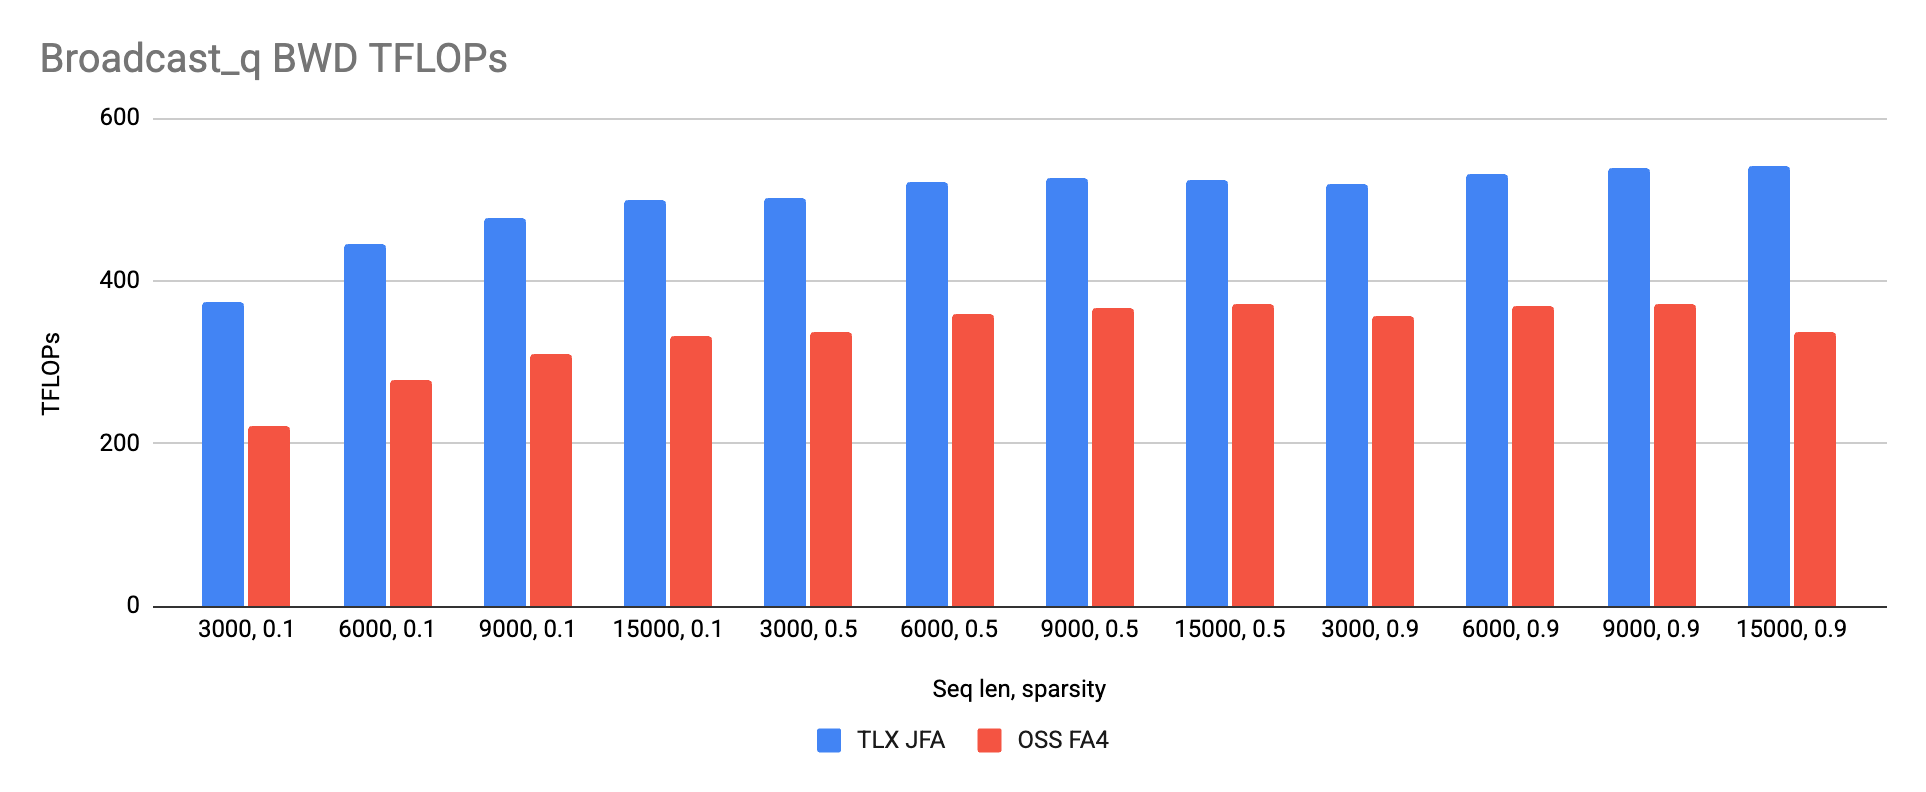
TLX porta l'attenzione jagged su Blackwell oltre FA4, con un terzo del codice

Il kernel attention di Meta per GEM, riscritto in TLX, supera FlashAttention-4 sui carichi jagged Blackwell: +13% in forward e +50% in backward in media, con circa 3.200 righe contro 10.000. Il risultato mostra che il controllo hardware esplicito non...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-01 โ€ข ServeTheHome

Nel lab F5, BIG-IP Next per Kubernetes triplica l'efficienza dei cluster GPU

Nel laboratorio F5, l'uso di BIG-IP Next per Kubernetes ha mostrato prestazioni piรน che triple a paritร  di cluster GPU. Il dato sposta l'attenzione dal solo calcolo all'efficienza di rete e orchestrazione: per i deployment on-premise di LLM, il traff...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-29 โ€ข LocalLLaMA

L'EPYC a 256 core di AMD sfida la banda memoria delle GPU per LLM self-hosted

Il nuovo EPYC a 256 core porta una banda memoria pari al 91% di una RTX 5090 con controller a 16 canali DDR5-12800. La community LocalLLaMA reagisce tra sarcasmo e realismo per i costi dei moduli RDIMM ad alta densitร  e per il dubbio su quanti token ...

#Hardware #LLM On-Premise #DevOps
2026-09-26 โ€ข Tom's Hardware

Nvidia: con RTX Mega Geometry 2.0 la geometria arriva in VRAM on demand

Nvidia presenta RTX Mega Geometry 2.0, che gestisce la geometria del ray tracing caricandola in VRAM su richiesta. L'approccio riduce la pressione sulla memoria video e segnala una direzione importante per i carichi locali, inclusi quelli legati all'...

#Hardware #LLM On-Premise #DevOps
โ† Torna ai Topic