Topic / Trend Rising

Ottimizzazione dell'infrastruttura di serving AI

Le ottimizzazioni nel serving stanno migliorando throughput e utilizzo: i GEMM autotuned di Helion in vLLM, l'attenzione TLX su Blackwell, l'elasticità prefill-decode di FluidPD e il bilanciamento di rete di BIG-IP Next riducono lo spreco di GPU.

Detected: 2026-10-08 · Updated: 2026-10-08

Articoli Correlati

2026-10-07 • ArXiv cs.AI

FluidPD: elasticità in-place per il serving LLM prefill-decode

FluidPD affronta il disallineamento tra prefill e decode nel serving LLM senza aggiungere worker. FluidToken scarica parte del prefill sui worker di decode quando c'è margine; FluidRole riassegna i ruoli in esecuzione senza ricaricare il modello. Su ...

#Hardware #LLM On-Premise #DevOps

2026-10-02 • PyTorch Blog

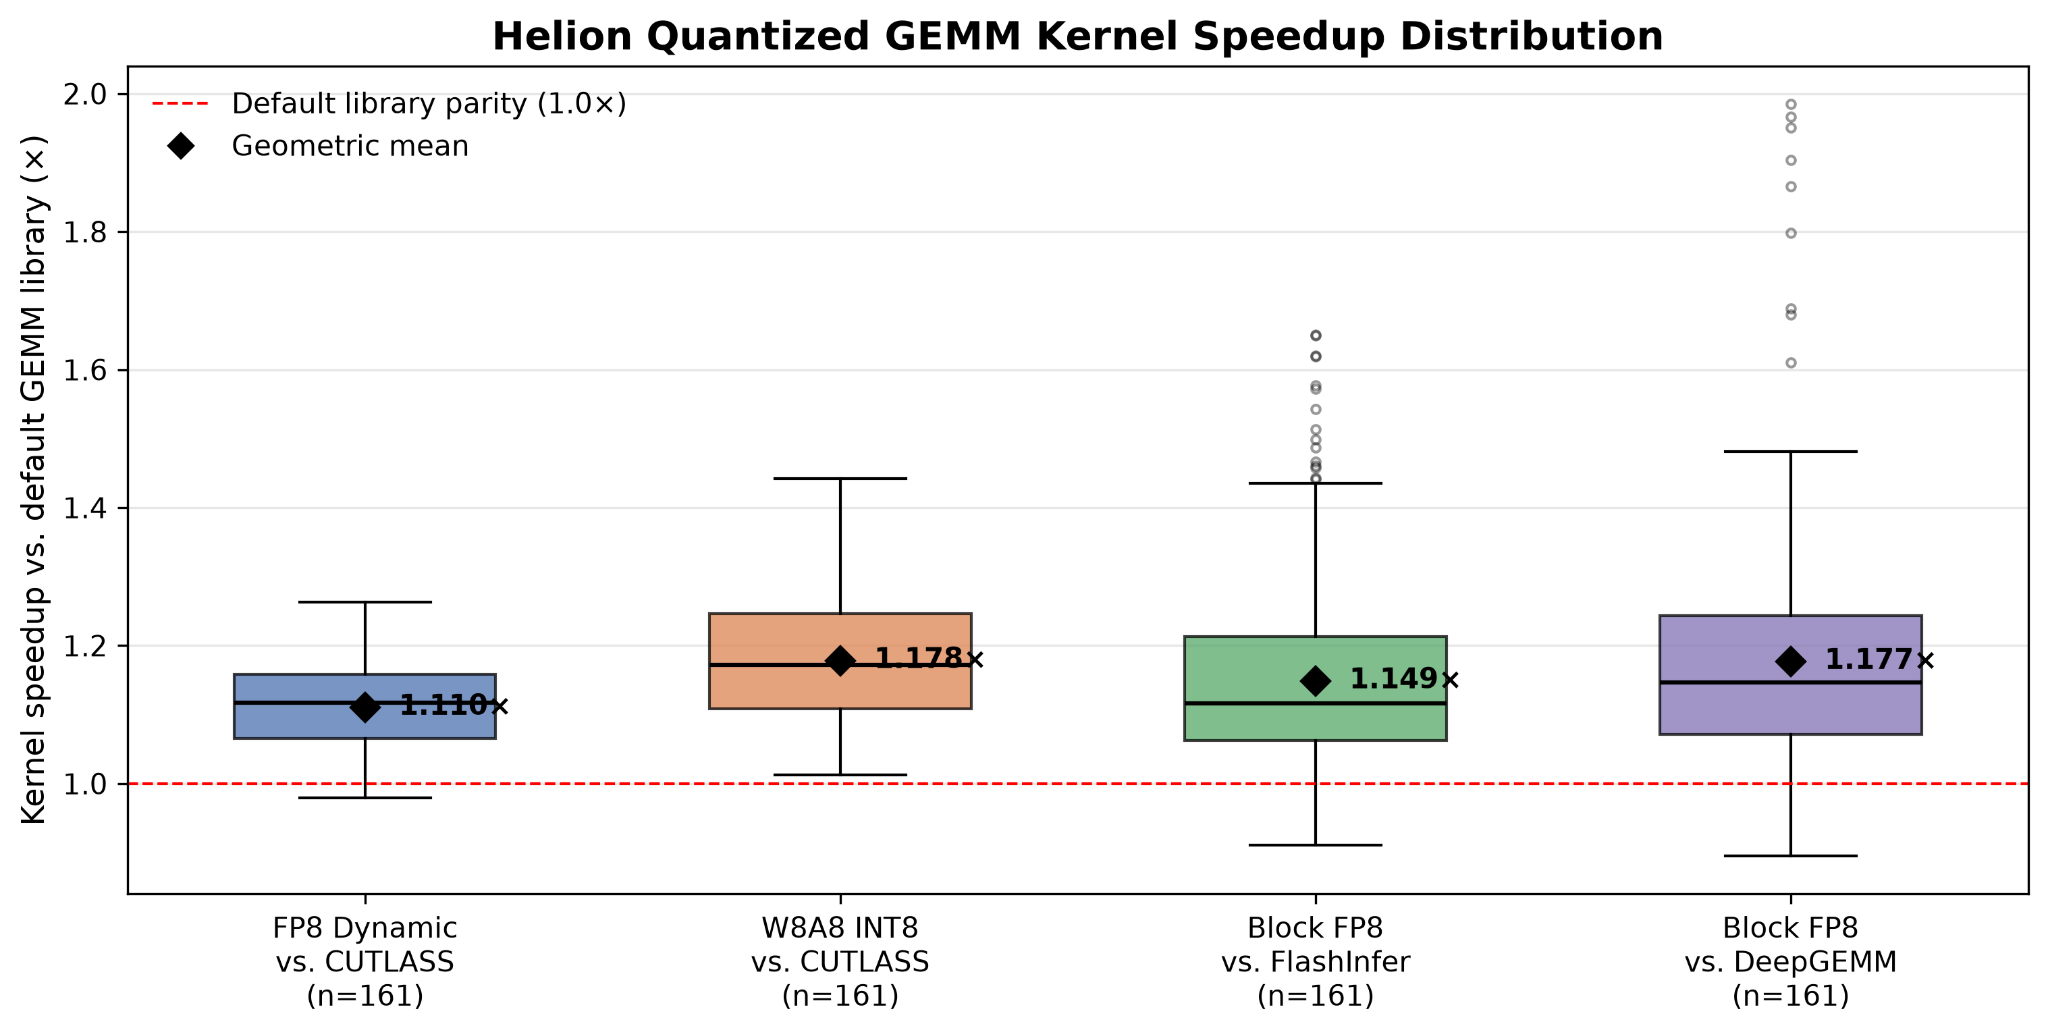
Helion nel backend vLLM: un solo GEMM, tuning per forma e guadagni fino al 10%

Red Hat e Meta hanno integrato Helion nel backend lineare di vLLM. Un'unica implementazione GEMM copre Standard, Split-K e Swap-AB, con autotuning per forma su GPU Hopper. Nei test su H100, i kernel superano CUTLASS, FlashInfer e DeepGEMM, con miglio...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-01 • PyTorch Blog

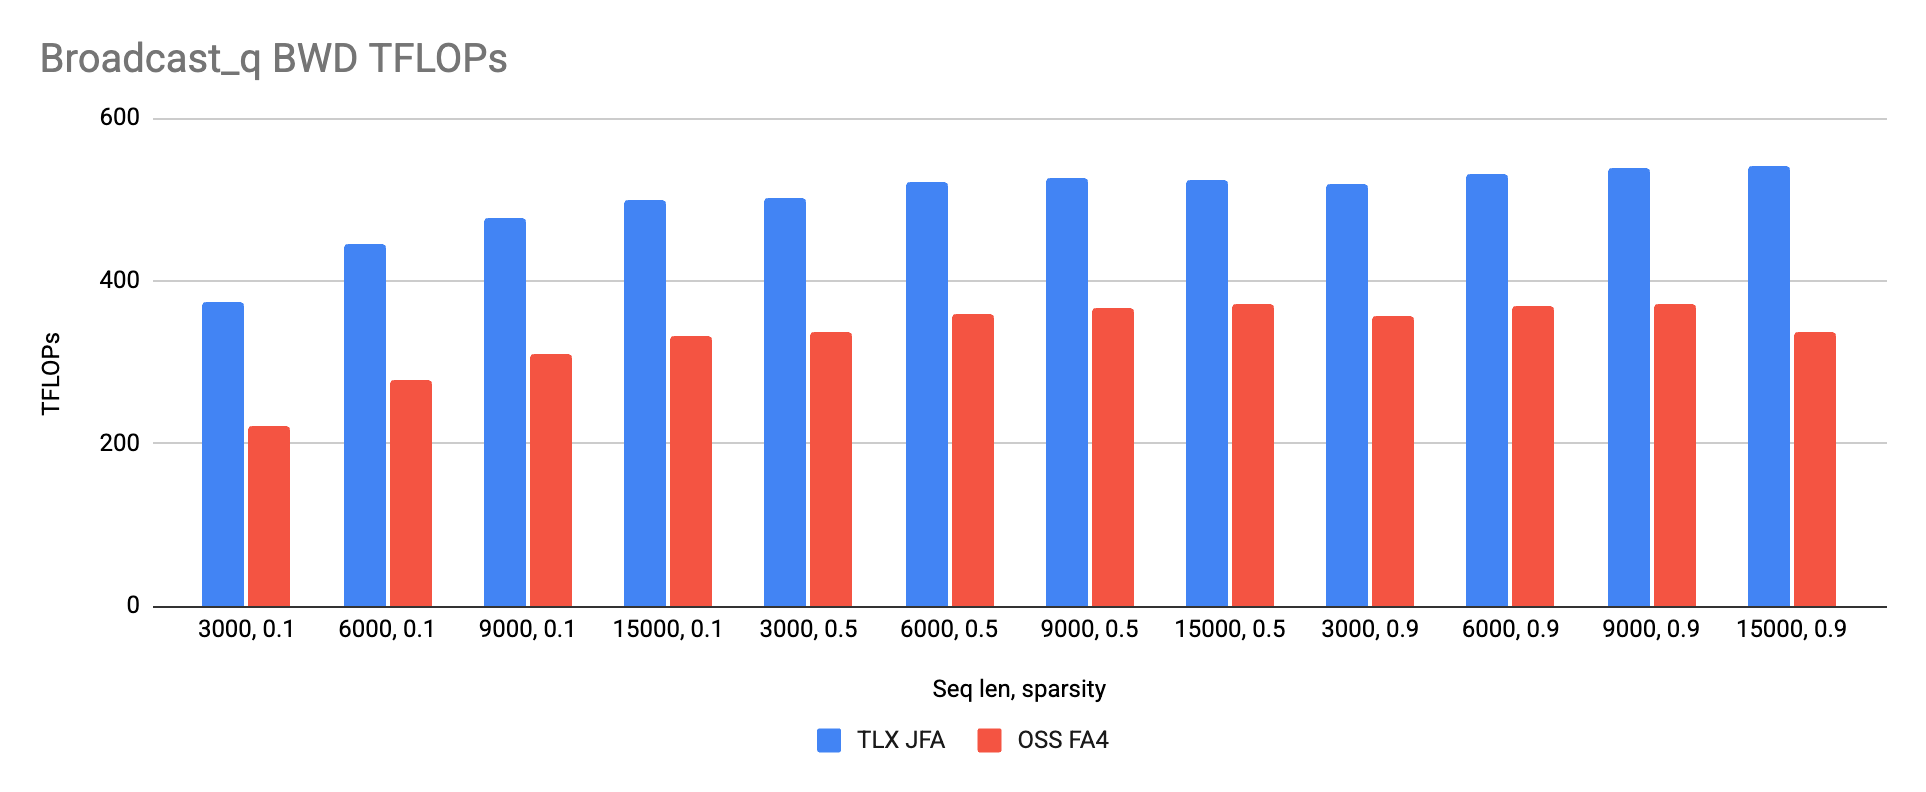
TLX porta l'attenzione jagged su Blackwell oltre FA4, con un terzo del codice

Il kernel attention di Meta per GEM, riscritto in TLX, supera FlashAttention-4 sui carichi jagged Blackwell: +13% in forward e +50% in backward in media, con circa 3.200 righe contro 10.000. Il risultato mostra che il controllo hardware esplicito non...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-01 • ServeTheHome

Nel lab F5, BIG-IP Next per Kubernetes triplica l'efficienza dei cluster GPU

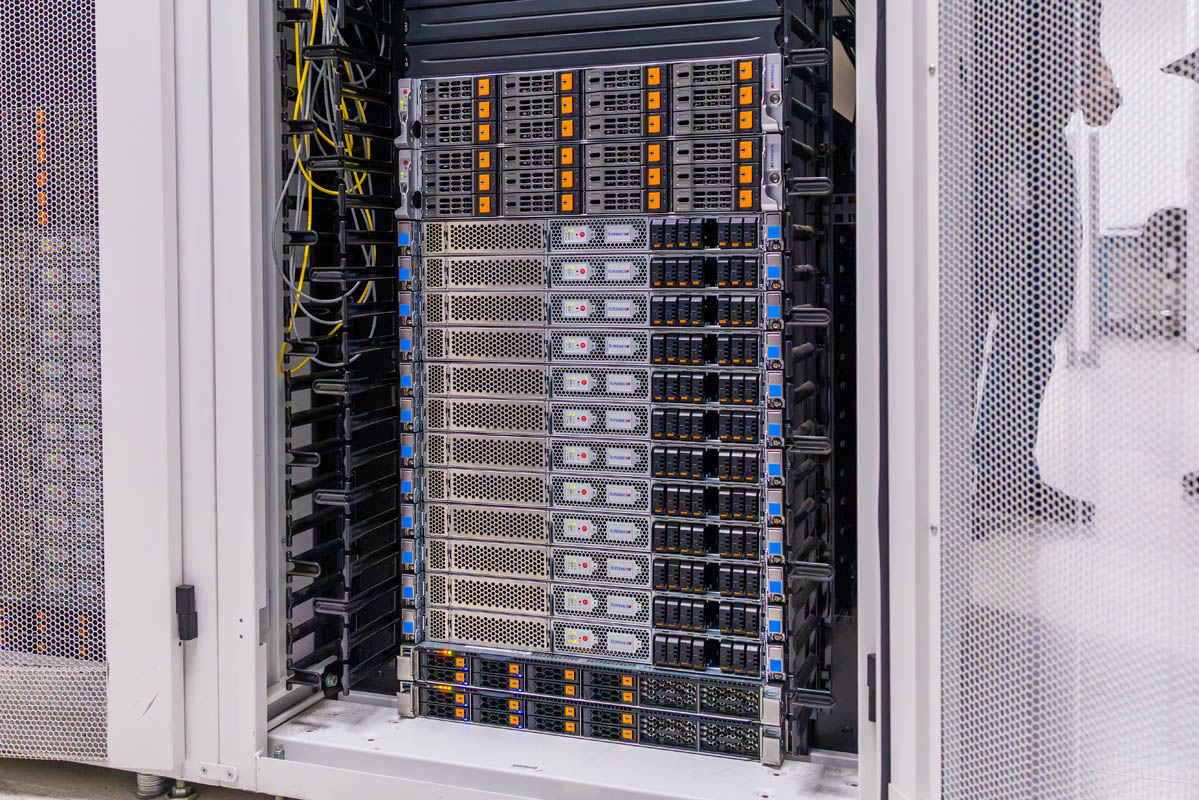
Nel laboratorio F5, l'uso di BIG-IP Next per Kubernetes ha mostrato prestazioni più che triple a parità di cluster GPU. Il dato sposta l'attenzione dal solo calcolo all'efficienza di rete e orchestrazione: per i deployment on-premise di LLM, il traff...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic