Topic / Trend Rising

La VRAM delle GPU consumer diventa il nuovo vincolo per l'AI locale

L'aumento della domanda per schede da 16GB come la RTX 5060 Ti e le voci di una RTX 5080 24GB cancellata mostrano che la capacità VRAM consumer sta guidando l'adozione dell'AI locale. Gli strumenti che mostrano l'uso della VRAM e gli esperimenti con agenti locali rivelano i limiti pratici dell'hardware consumer attuale.

Detected: 2026-11-15 · Updated: 2026-11-15

Articoli Correlati

2026-11-11 • LocalLLaMA

Report: RTX 5080 da 24 GB cancellata, resta il modello da 16 GB

La GeForce RTX 5080 da 24 GB non arriverà secondo le ultime indiscrezioni. Resta il taglio da 16 GB, una scelta che ridefinisce il posizionamento di NVIDIA e i vincoli per chi usa GPU consumer per LLM on-premise.

#Hardware #LLM On-Premise #DevOps
2026-11-11 • LocalLLaMA

RTX 5080, niente 24 GB: Nvidia si ferma per i costi della GDDR7

Secondo indiscrezioni, Nvidia avrebbe accantonato la RTX 5080 da 24 GB, mantenendo solo la versione da 16 GB a causa dei costi elevati della memoria GDDR7. Una scelta che riduce le opzioni per chi usa GPU consumer per inference LLM locale e self-host...

#Hardware #LLM On-Premise #DevOps
2026-11-08 • LocalLLaMA

RTX 5060 Ti 16GB, la corsa all'acquisto per l'AI

La community segnala acquisti in massa della GeForce RTX 5060 Ti 16GB per eseguire modelli AI. Non è un dettaglio da appassionati: indica che la VRAM consumer è diventata la porta d'ingresso per l'inference self-hosted. Il nodo resta la memoria: 16 G...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-08 • LocalLLaMA

RTX 5070 Ti da 16GB: gli agenti locali restano un cantiere aperto

Un utente con RTX 5070 Ti da 16GB e 32GB di RAM ha provato Ollama, vLLM e i framework Goose, Hermes Agent e OpenCode per costruire assistenti locali. Il risultato? Niente di utile. La storia mostra il divario tra narrativa degli agenti self-hosted e ...

#Hardware #LLM On-Premise #DevOps
2026-11-08 • Tom's Hardware

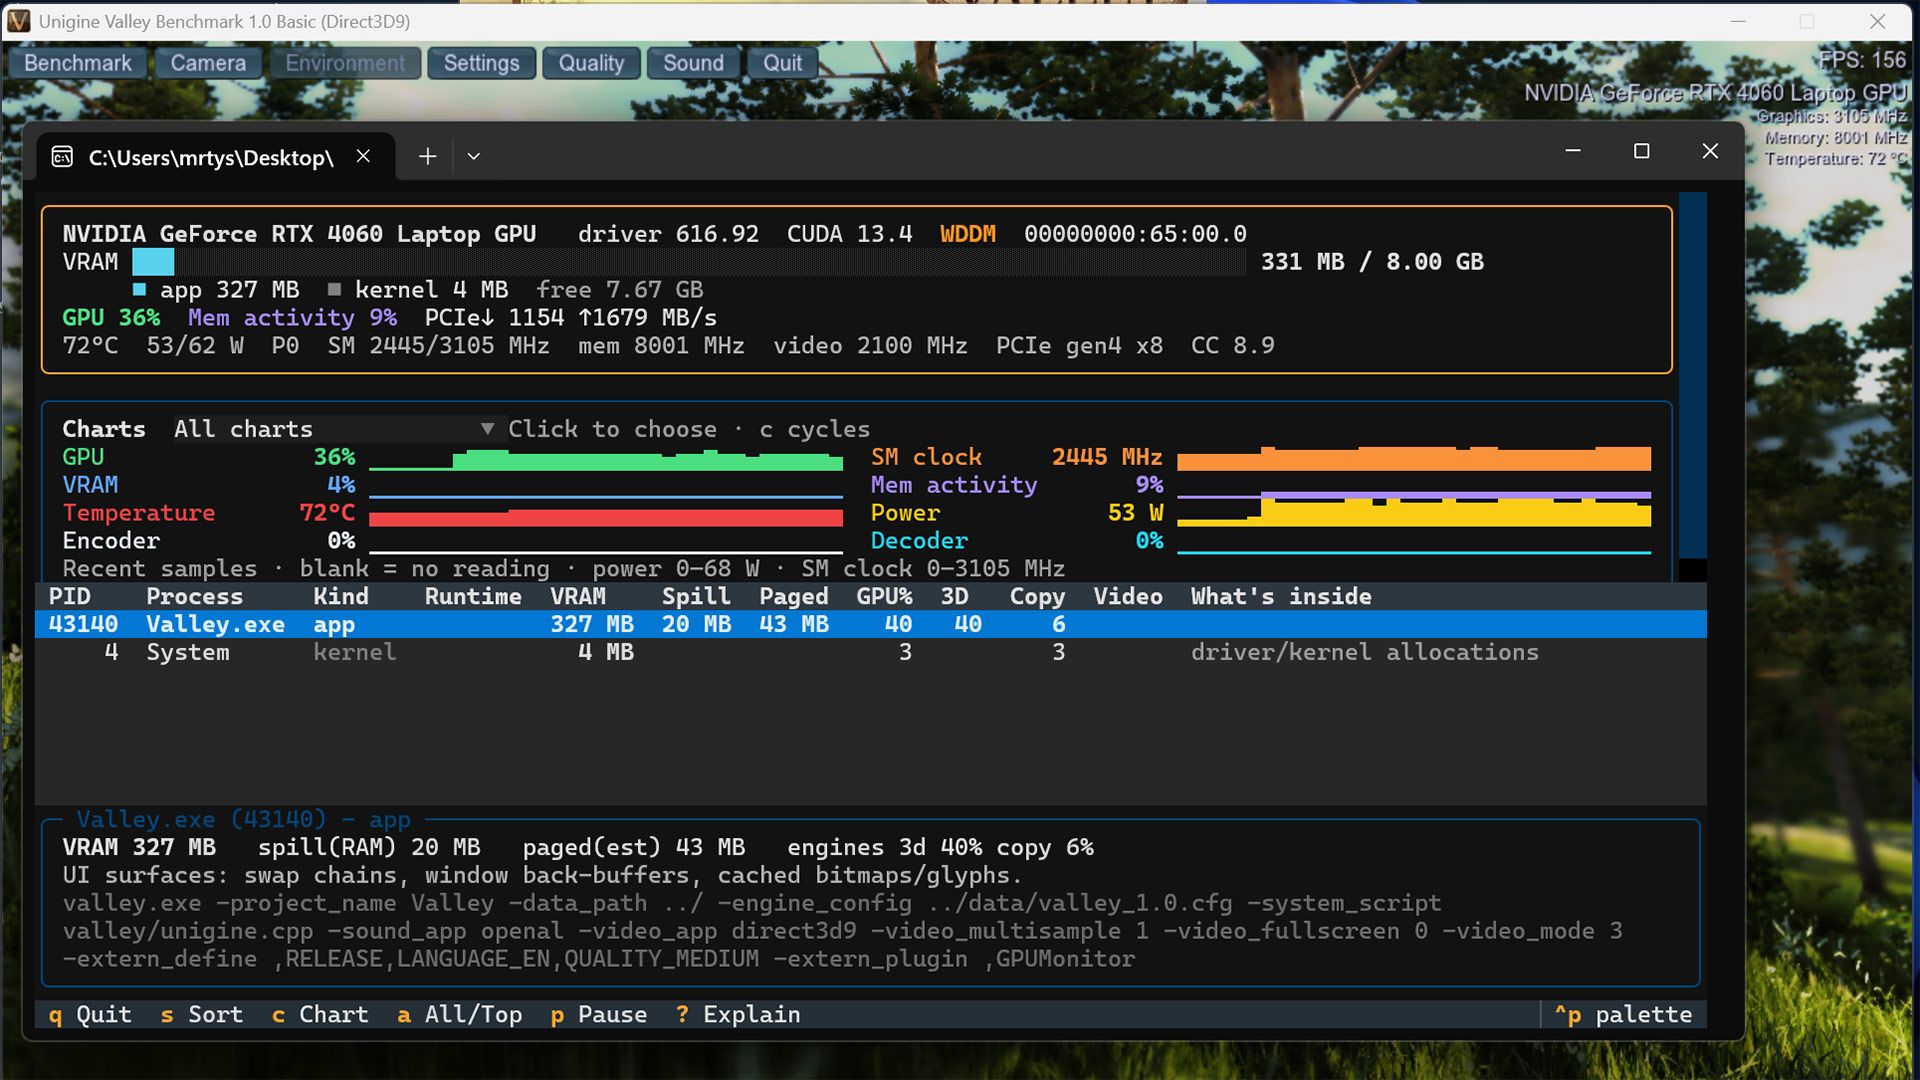
Il task manager GPU open source che svela cosa occupa la VRAM

Un nuovo strumento open source promette di mostrare con precisione quali processi consumano la VRAM. Per chi gestisce LLM in locale, questa visibilità cambia il modo di affrontare colli di bottiglia, dimensionare l'hardware e calcolare il costo reale...

#Hardware #LLM On-Premise
← Torna ai Topic