Helion in vLLM: il tuning dei GEMM diventa ricerca, non artigianato GPU
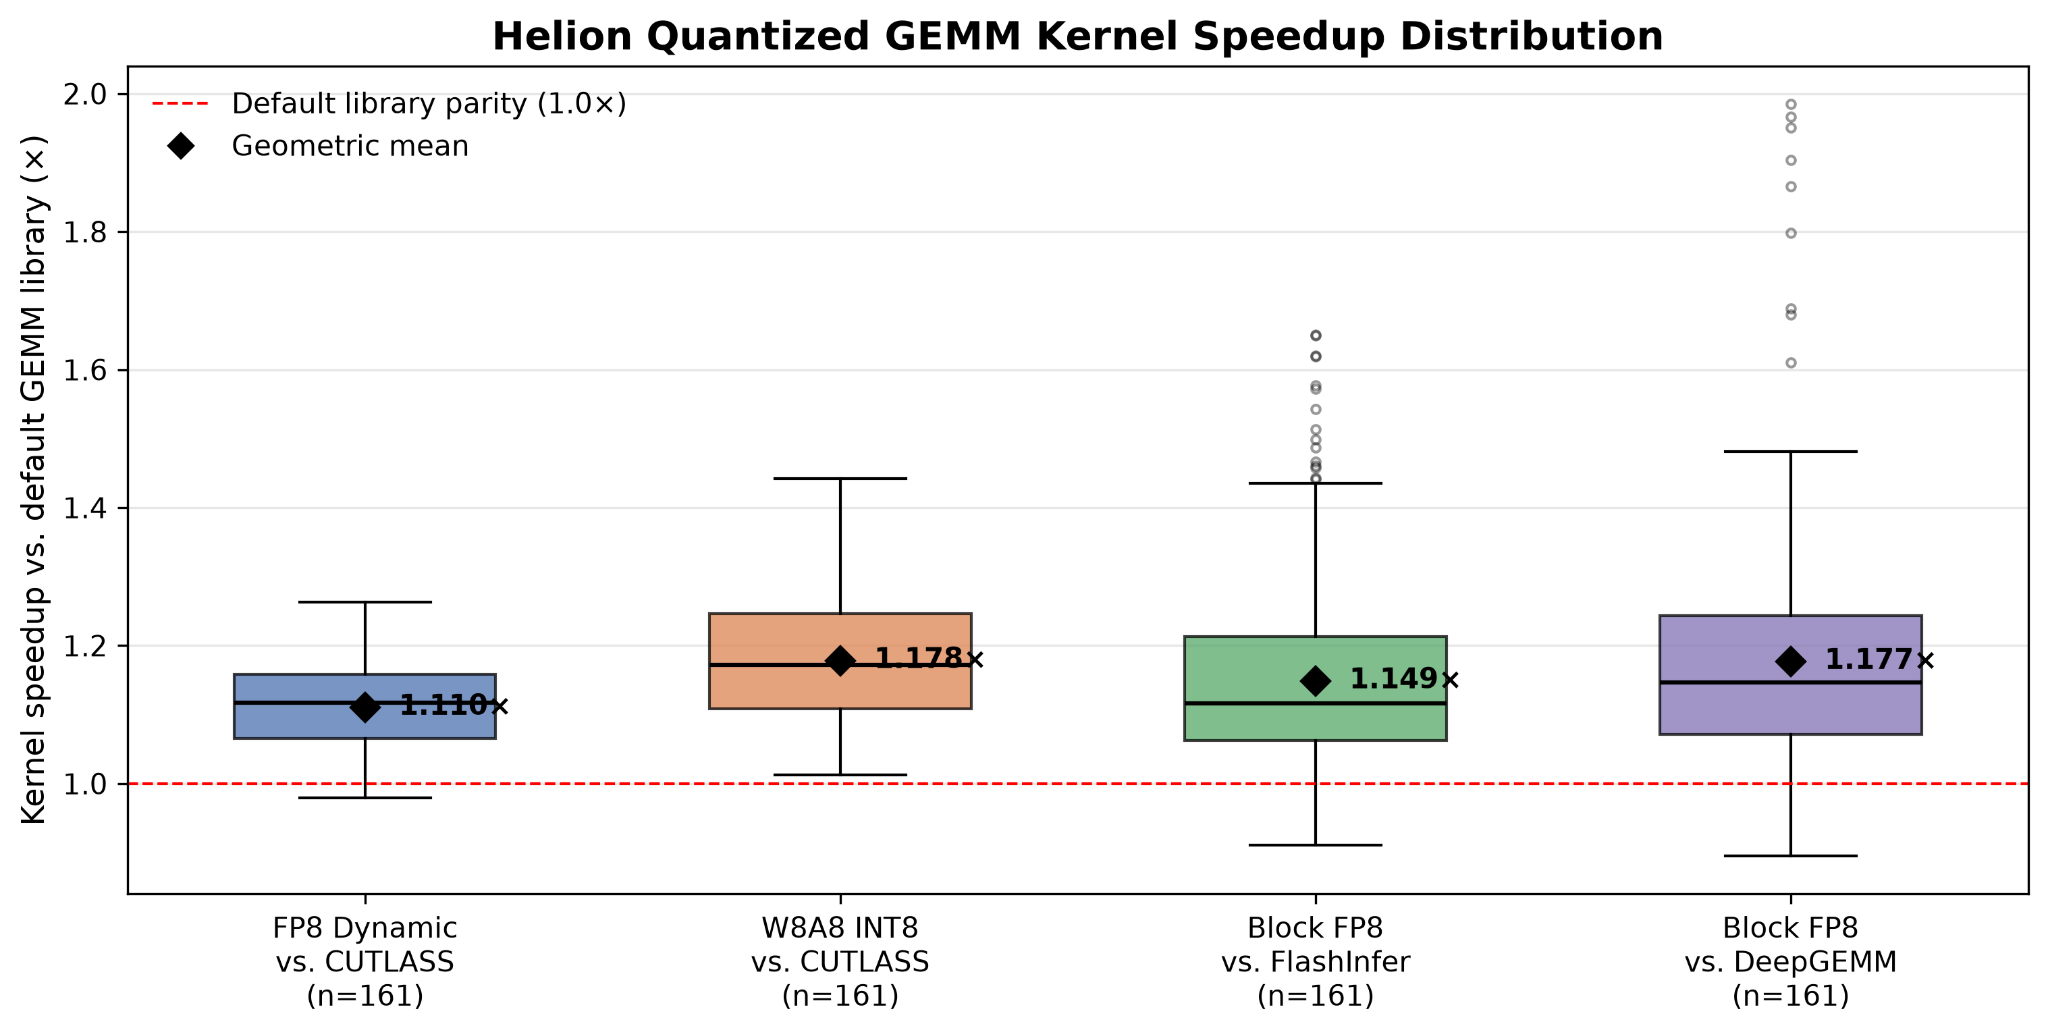
L'integrazione di Helion nel backend lineare di vLLM mostra che un solo kernel GEMM con autotuner ahead-of-time può coprire varianti specializzate e migliorare l'inference fino al 10% su Qwen3. Per chi gestisce LLM self-hosted, il segnale è duplice: ...