Topic / Trend Stable

Ottimizzazione di Kernel di Inference e Driver GPU

I guadagni prestazionali arrivano sempre più dal lavoro di basso livello su kernel e driver—tuning GEMM unificati, kernel attention jagged e stack GPU/calcolo aperti—piuttosto che dal solo scaling dei modelli. L’attenzione si sposta verso un’esecuzione efficiente su Hopper, Blackwell e architetture GPU alternative.

Detected: 2026-10-05 · Updated: 2026-10-05

Articoli Correlati

2026-10-02 • PyTorch Blog

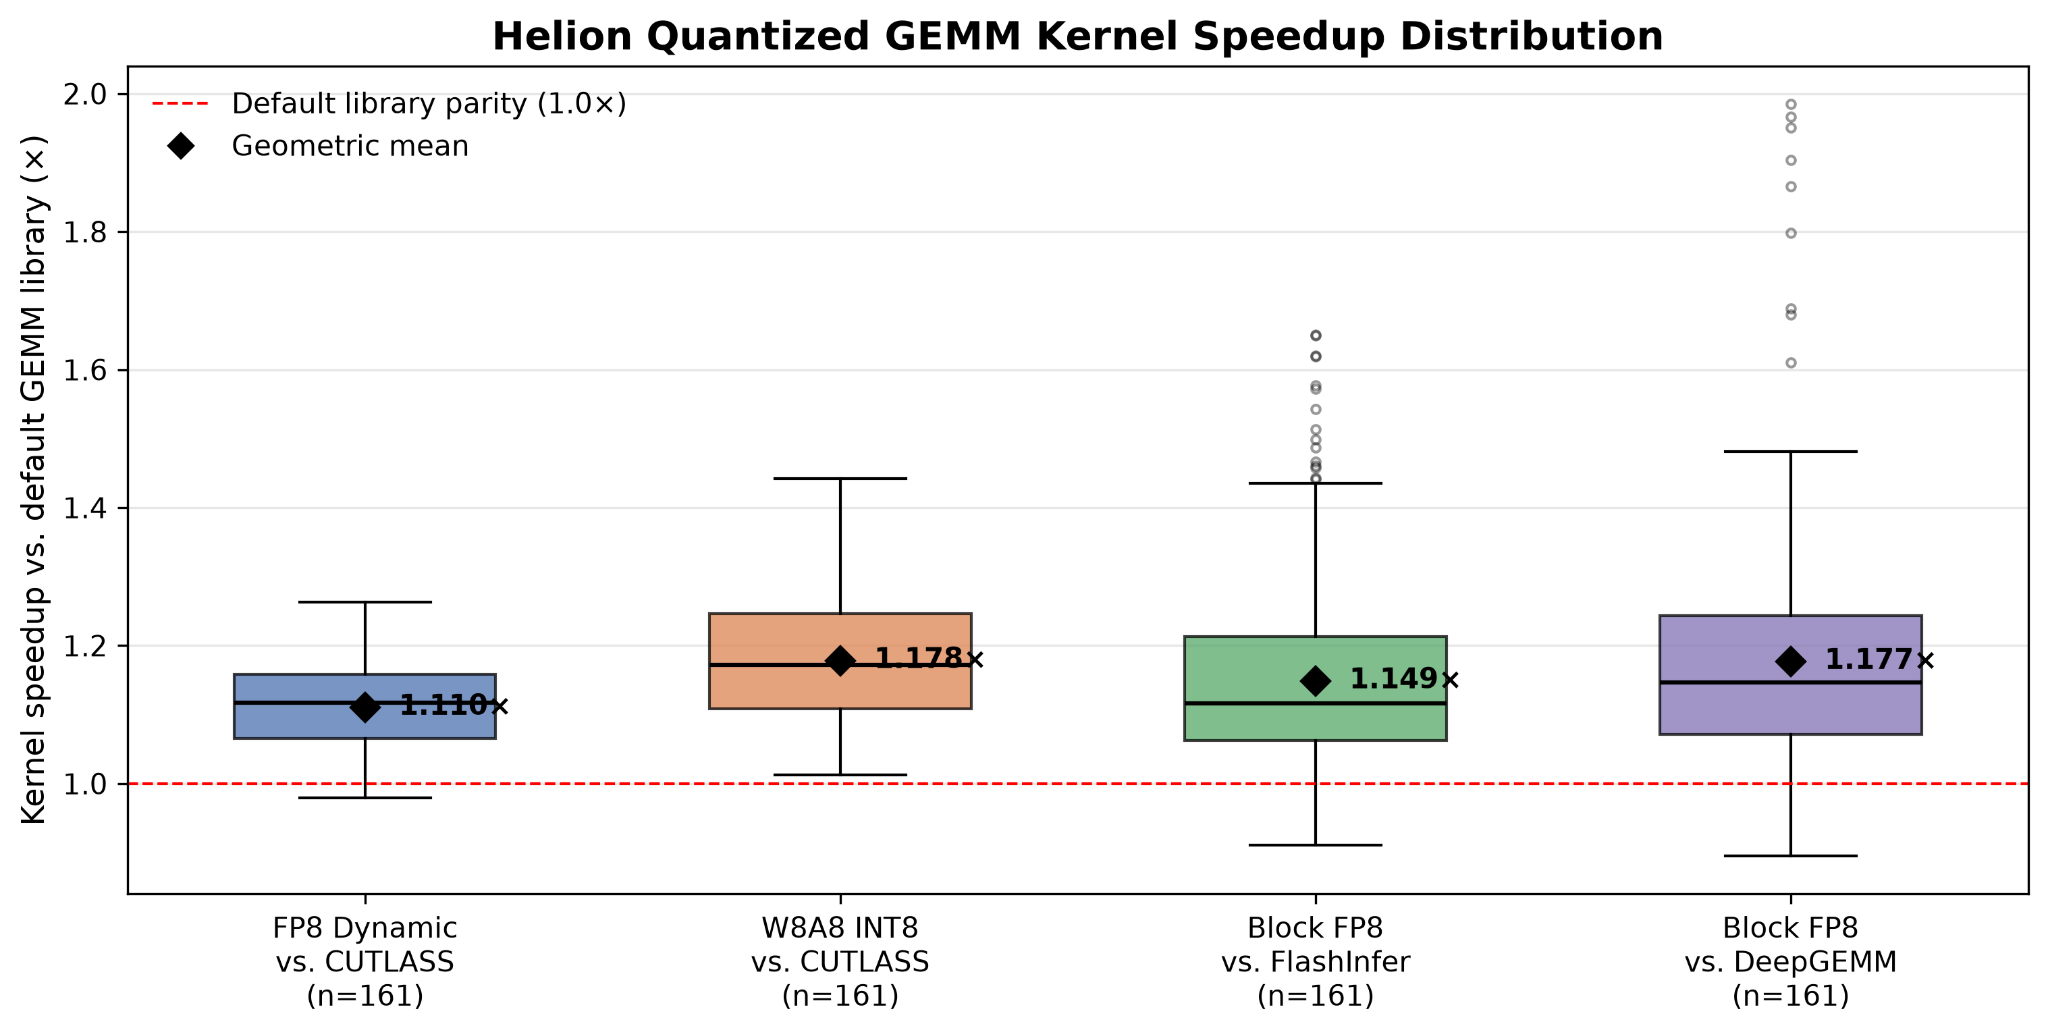
Helion nel backend vLLM: un solo GEMM, tuning per forma e guadagni fino al 10%

Red Hat e Meta hanno integrato Helion nel backend lineare di vLLM. Un'unica implementazione GEMM copre Standard, Split-K e Swap-AB, con autotuning per forma su GPU Hopper. Nei test su H100, i kernel superano CUTLASS, FlashInfer e DeepGEMM, con miglio...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-02 • Phoronix

Imagination accelera sul driver Vulkan open source e prepara la GPU Volcanic

A XDC 2026 Toronto, Imagination ha illustrato lo stato del driver Mesa Vulkan per PowerVR e del driver DRM kernel PVR upstream, con piani per la nuova architettura Volcanic. Meno annunci, più infrastruttura: un driver open source riduce il lock-in e ...

#Hardware #LLM On-Premise #DevOps
2026-10-02 • Phoronix

Driver open-source Intel Iris: indirizzamento a 64 bit più efficiente

Il driver open-source Intel Iris Gallium3D per OpenGL ha ricevuto il supporto per una modalità di indirizzamento a 64 bit efficiente. La modifica arriva dopo l'annuncio della nuova modalità GPU a 64 bit per la grafica Nova Lake P. Per chi usa GPU Int...

#Hardware #LLM On-Premise #DevOps
2026-10-01 • PyTorch Blog

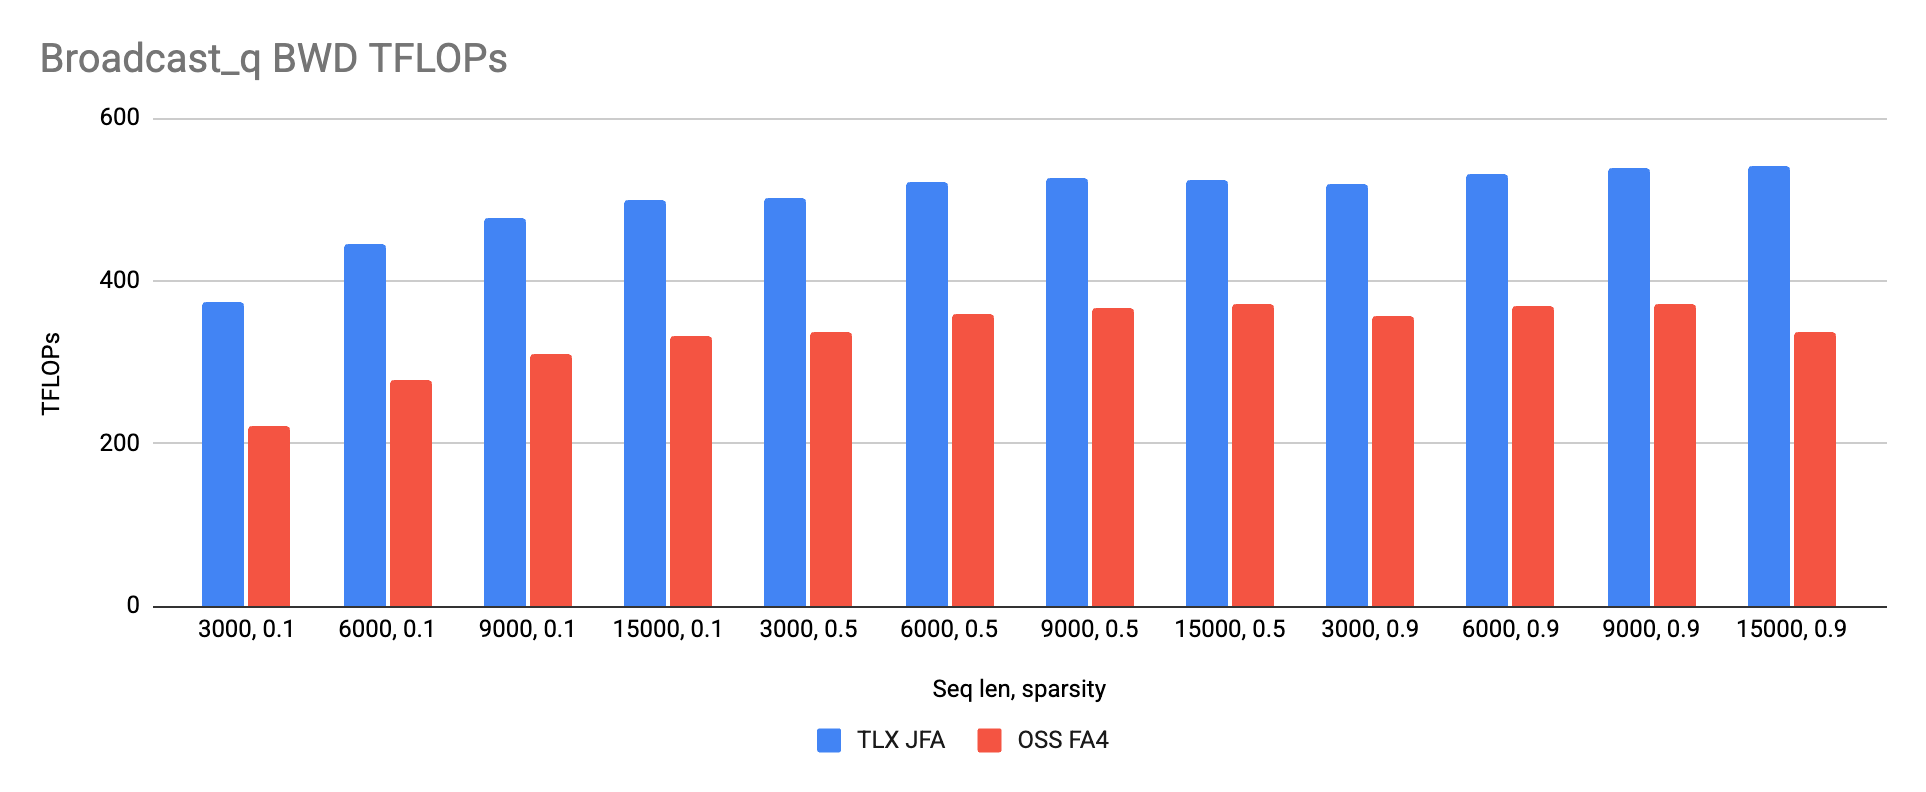
TLX porta l'attenzione jagged su Blackwell oltre FA4, con un terzo del codice

Il kernel attention di Meta per GEM, riscritto in TLX, supera FlashAttention-4 sui carichi jagged Blackwell: +13% in forward e +50% in backward in media, con circa 3.200 righe contro 10.000. Il risultato mostra che il controllo hardware esplicito non...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-30 • Phoronix

EDG apre il front-end C/C++: impatto sulla toolchain dei compilatori

Edison Design Group ha aperto il suo front-end C/C++, componente commerciale noto per il supporto esteso dei dialetti e usato da Intel C++ Compiler classic, NVIDIA CUDA NVCC e Microsoft Visual Studio IntelliSense. La mossa rende più ispezionabile e i...

#Hardware #LLM On-Premise #DevOps
2026-09-29 • Phoronix

NOCL porta OpenCL su GPU NVIDIA tramite Mesa e CUDA

Mesa sta sviluppando NOCL, un'implementazione Gallium3D sopra l'API driver CUDA di NVIDIA. Abbinato a Rusticl, permette di eseguire workload OpenCL usando il driver proprietario NVIDIA. Un'opzione di calcolo che sposta il controllo dall'ecosistema CU...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic