Topic / Trend Rising

Ottimizzazione dell'Inference Locale e Gestione della VRAM

llama.cpp e metodi di speculative decoding stanno riducendo l'uso di memoria per cache KV e offload MoE, consentendo contesti più lunghi su GPU limitate. Riproducibilità e visibilità della VRAM stanno diventando questioni centrali per l'inference locale.

Detected: 2026-11-12 · Updated: 2026-11-12

Articoli Correlati

2026-11-11 • LocalLLaMA

llama.cpp aggiunge la cache KV in FP8: meno VRAM, contesti più lunghi

llama.cpp ha introdotto il supporto per la cache KV in FP8, riducendo l'occupazione di VRAM durante l'inference di LLM locali. Per chi valuta deployment self-hosted, il vantaggio immediato è gestire contesti più ampi su hardware esistente, ma il camb...

#Hardware #LLM On-Premise #DevOps

2026-11-08 • Tom's Hardware

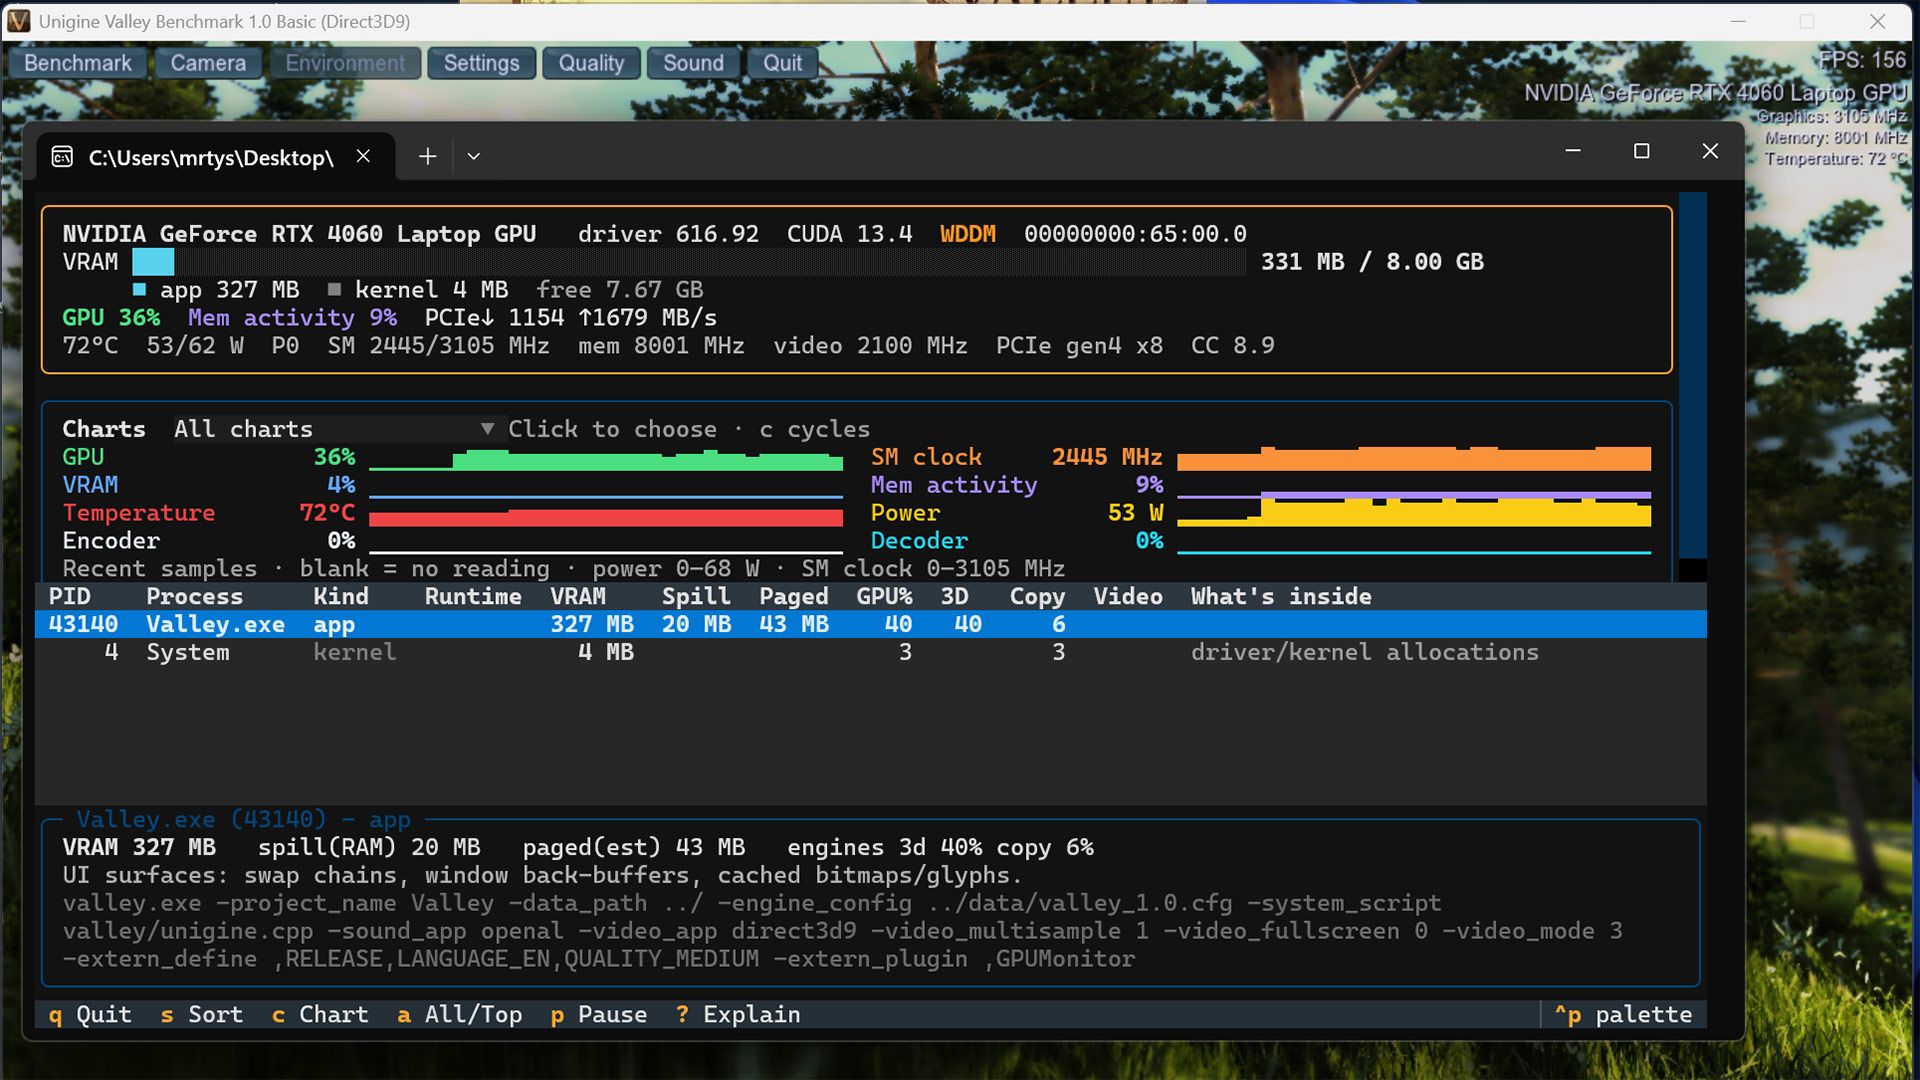
Il task manager GPU open source che svela cosa occupa la VRAM

Un nuovo strumento open source promette di mostrare con precisione quali processi consumano la VRAM. Per chi gestisce LLM in locale, questa visibilità cambia il modo di affrontare colli di bottiglia, dimensionare l'hardware e calcolare il costo reale...

#Hardware #LLM On-Premise
2026-11-07 • LocalLLaMA

KV cache a 8 bit quasi gratis, 4 bit azzardo: i numeri su Qwen3.8 27B

Un benchmark su 35 quantizzazioni con llama.cpp, ExLlamaV3 e vLLM misura la divergenza KL introdotta dalla KV cache quantizzata. A 8 bit il calo di memoria è di circa 1,9-2 GiB a 64k token e l'effetto sulla distribuzione dei token è quasi nullo. Il 4...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-07 • LocalLLaMA

llama.cpp: cache per esperti MoE su CPU, sollievo per GPU con poca VRAM

Una pull request nel progetto llama.cpp introduce llama_moe_cache: una cache per gli esperti MoE eseguiti su CPU e uno script di tuning. L'obiettivo è accelerare l'offloading dei modelli MoE per chi ha poca VRAM, un'idea simile a meccanismi già visti...

#Hardware #LLM On-Premise #DevOps
2026-11-06 • ArXiv cs.LG

Octopus: un solo modello, molti rami con KV cache condivisa

Un framework multi-agente a modello singolo condivide una backbone e coordina thread su un DAG di stati KV residenti in GPU. Con fork radix zero-copy, montaggio KV solo su attenzione e trainer DAG-GRPO impacchettato, riduce la memoria KV di picco di ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-05 • LocalLLaMA

Qwen3.8-27B peggiorato? La zona cieca dell'inference locale

Una segnalazione aneddotica su un modello Q4 eseguito con llama.cpp su RTX 4090 riapre il problema della riproducibilità nei deployment self-hosted: senza hash e versioni bloccate, il controllo locale resta incompleto.

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic

