Topic / Trend Rising

Hardware AI Locale e Pressione sulla VRAM

Memoria GPU, supporto NPU e strategie vendor data-center-first stanno ridisegnando l'inference LLM locale. Le voci su RTX con molta VRAM, la svolta strategica di AMD e l'abilitazione NPU su Linux riflettono domanda e incertezza hardware.

Detected: 2026-11-09 · Updated: 2026-11-09

Articoli Correlati

2026-11-08 • LocalLLaMA

RTX 5060 Ti 16GB, la corsa all'acquisto per l'AI

La community segnala acquisti in massa della GeForce RTX 5060 Ti 16GB per eseguire modelli AI. Non è un dettaglio da appassionati: indica che la VRAM consumer è diventata la porta d'ingresso per l'inference self-hosted. Il nodo resta la memoria: 16 G...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-08 • LocalLLaMA

RTX 5070 Ti da 16GB: gli agenti locali restano un cantiere aperto

Un utente con RTX 5070 Ti da 16GB e 32GB di RAM ha provato Ollama, vLLM e i framework Goose, Hermes Agent e OpenCode per costruire assistenti locali. Il risultato? Niente di utile. La storia mostra il divario tra narrativa degli agenti self-hosted e ...

#Hardware #LLM On-Premise #DevOps
2026-11-08 • Tom's Hardware

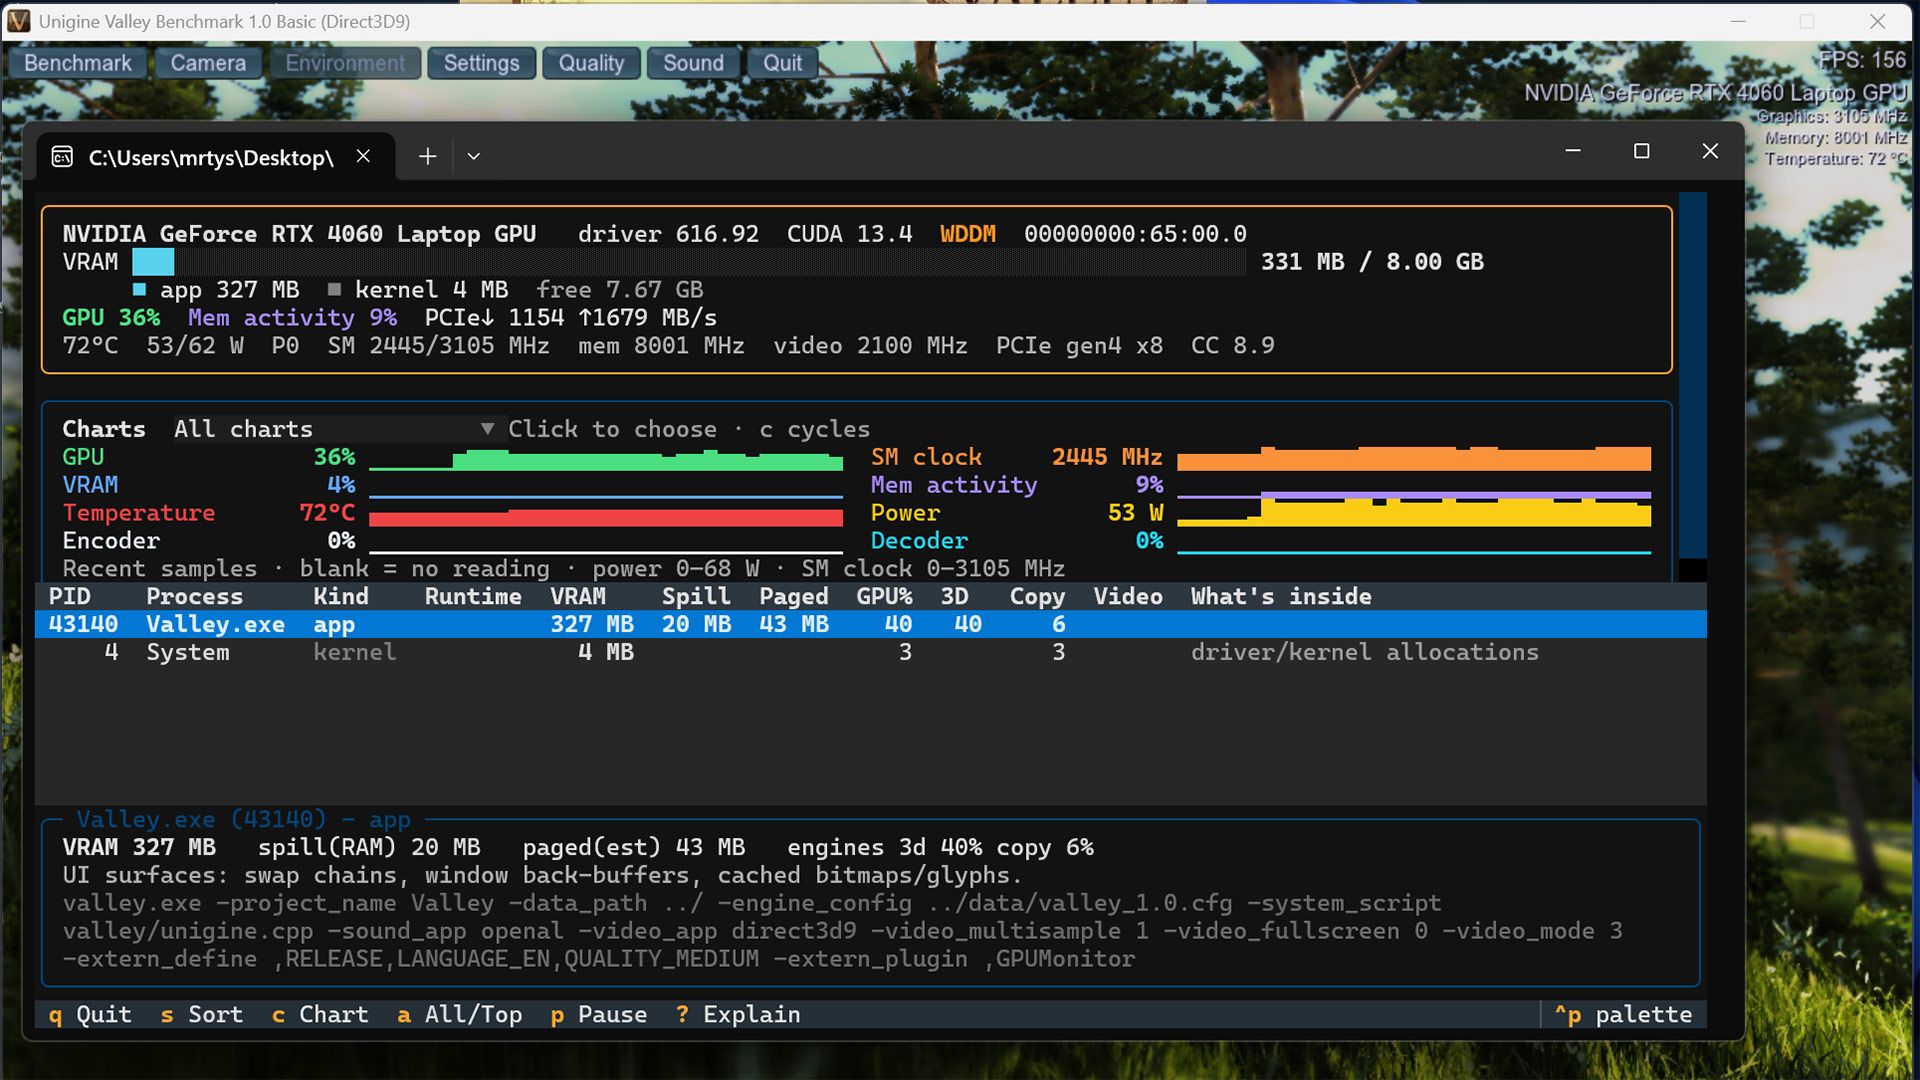
Il task manager GPU open source che svela cosa occupa la VRAM

Un nuovo strumento open source promette di mostrare con precisione quali processi consumano la VRAM. Per chi gestisce LLM in locale, questa visibilità cambia il modo di affrontare colli di bottiglia, dimensionare l'hardware e calcolare il costo reale...

#Hardware #LLM On-Premise
2026-11-08 • Phoronix

Linux 7.5 accelera il supporto alle NPU AMD Ryzen AI con AIE4

Nel ciclo verso Linux 7.5 si sono già accumulate tre pull request drm-misc-next per l'abilitazione delle NPU AMD Ryzen AI con AIE4. Un segnale concreto per chi guarda all'inference locale e self-hosted.

#Hardware #LLM On-Premise #DevOps
2026-11-07 • LocalLLaMA

GPU economiche addio: AMD è 'data center first', avverte il CEO

Il CEO di AMD ha definito l'azienda 'data center first', chiudendo di fatto l'era delle GPU consumer a basso costo come priorità strategica. Per chi pianifica inference LLM self-hosted, il segnale conta: l'offerta di silicio, packaging e VRAM si spos...

#Hardware #LLM On-Premise
2026-11-05 • PyTorch Blog

La call di PyTorch Day China 2026 mappa l’inference locale

La scadenza del 10 novembre per PyTorch Day China 2026 rivela un'agenda concentrata su training distribuito, inference efficiente, accelerazione hardware e AI fisica. L'analisi: le tracce scelte mostrano come il framework guardi sempre più ai vincoli...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-04 • Phoronix

CUDA 13.5 porta Vera Rubin nel ciclo di produzione

NVIDIA ha rilasciato CUDA 13.5 insieme al driver Linux 620.70.06. La novità centrale è il supporto in general availability per Vera Rubin, architettura GPU di NVIDIA. Per chi lavora su infrastrutture self-hosted e LLM, il toolchain diventa disponibil...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-04 • PyTorch Blog

PyTorch Day China 2026: la call svela la svolta verso inference e hardware

La Call for Proposals del PyTorch Day China 2026 chiude il 10 novembre. L'evento di Pechino del 12 dicembre mette al centro cinque aree tematiche, con un'enfasi inedita su inference efficiente, accelerazione hardware e physical AI. Per chi valuta sta...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-04 • Tom's Hardware

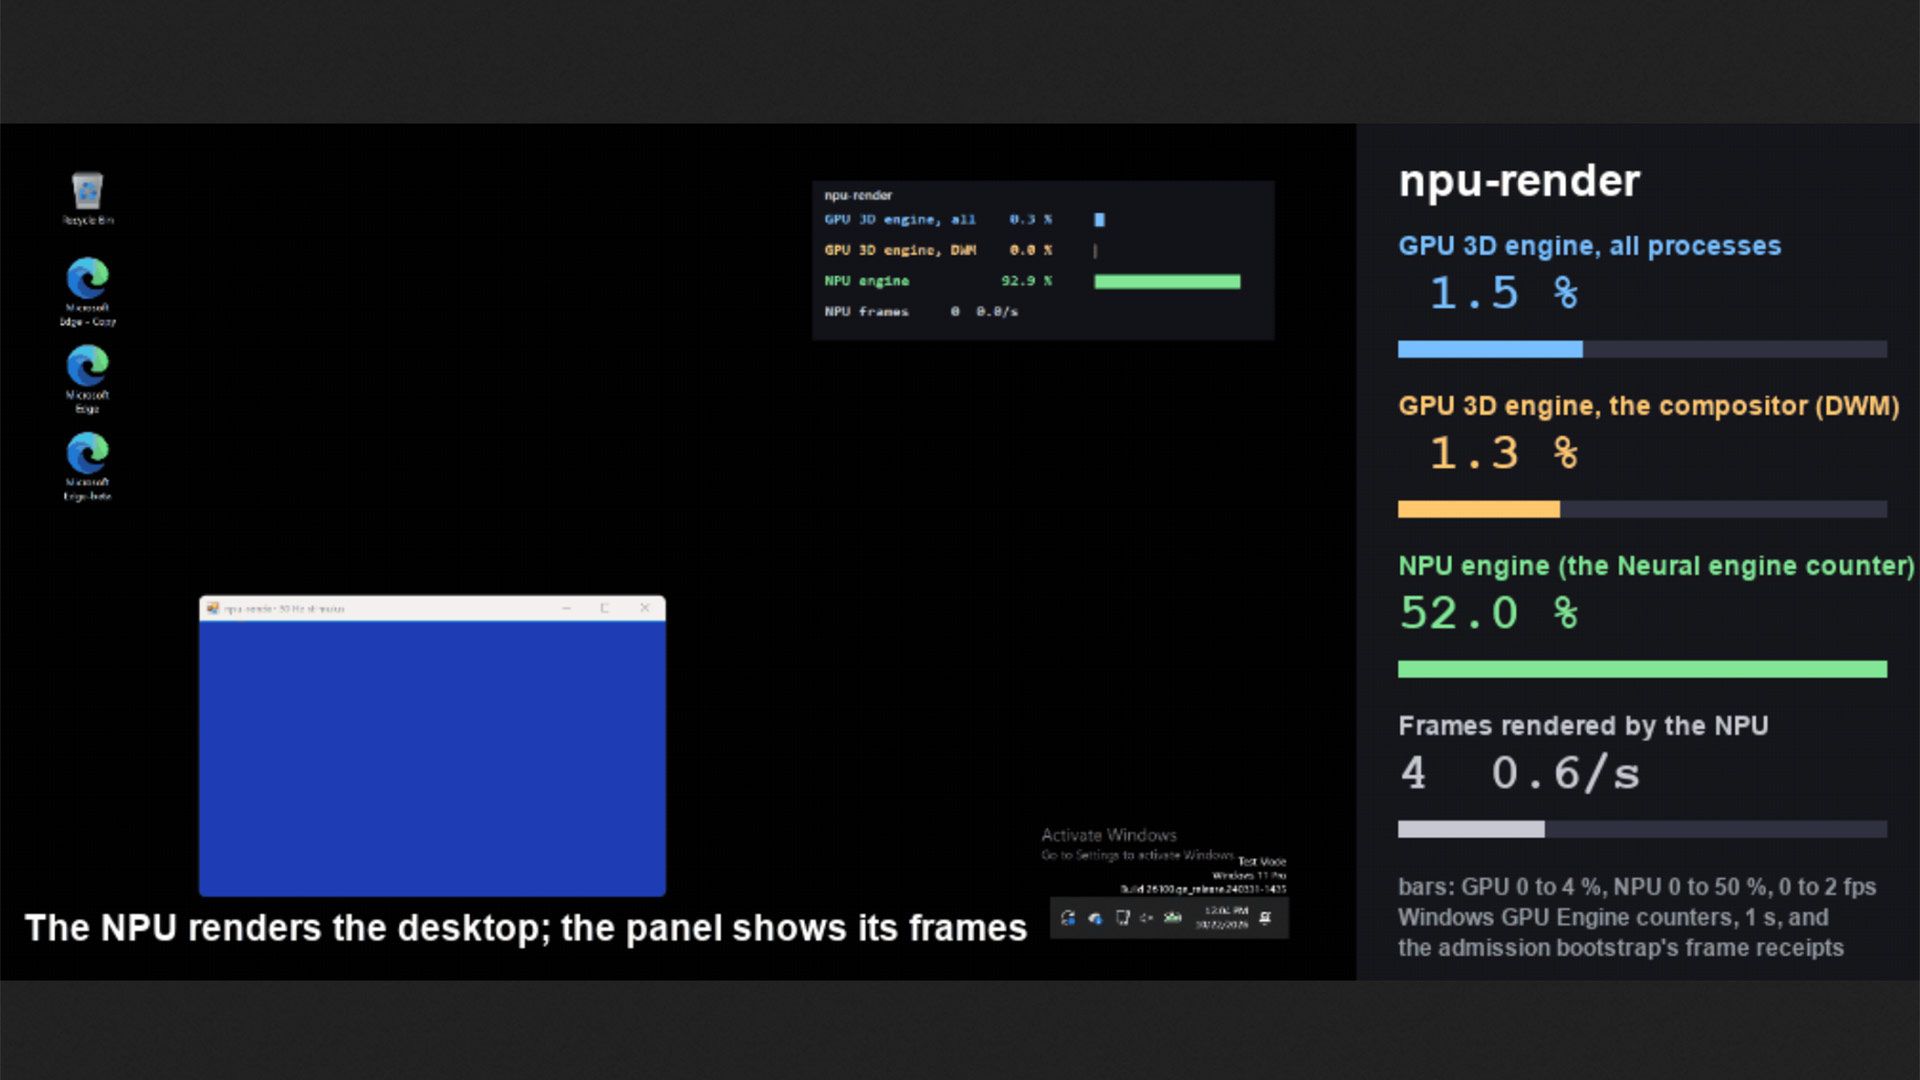
Driver open source npu-driver porta Windows 11 sulla NPU, non sulla GPU

Un progetto open source, npu-driver, sta provando a spostare la composizione del desktop di Windows 11 dalla GPU alla NPU. Oggi viaggia a 2-3 Hz, ma punta a 30 Hz. Non è una vittoria prestazionale: è la dimostrazione che le NPU possono uscire dal ruo...

#Hardware #LLM On-Premise #DevOps
2026-11-04 • LocalLLaMA

RTX 5090 da 64 e 96 GB: la voce che riapre la partita VRAM

La voce su GeForce RTX 5090 con 64 e 96 GB di VRAM tocca il nodo critico per chi usa LLM in locale: la memoria video come collo di bottiglia. Un'analisi sulle implicazioni per self-hosted, quantization, TCO e sovranità dei dati, oltre il semplice ann...

2026-11-03 • LocalLLaMA

RTX 5090 da 64 e 96 GB: la voce che riapre la partita VRAM

Un tecnico riparatore statunitense avrebbe segnalato l'esistenza di RTX 5090 con 64 e 96 GB di VRAM. La notizia, da verificare, tocca il nodo centrale per l'inference locale: più memoria video significa modelli più grandi, quantization meno aggressiv...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic