Topic / Trend Rising

Maturazione dello stack di inference locale

llama.cpp 1.0, compressione della KV cache, caching MoE e porting assistiti dall'AI stanno trasformando l'esecuzione locale degli LLM in una piattaforma stabile e con minore uso di VRAM. Nuovi strumenti migliorano anche la visibilità GPU/VRAM e distribuiscono i carichi tra CPU, GPU e NPU.

Detected: 2026-11-14 · Updated: 2026-11-14

Articoli Correlati

2026-11-14 • Phoronix

Il porting dei LLM come variabile di TCO: il segnale da AMD

L'esperimento AMD con HRX Loom e Ryzen AI Max mostra che portare 50 LLM su GPU client in tre giorni non è solo una prova di forza hardware. Il vero segnale è lo spostamento del valore verso il middleware e le pipeline di porting, con effetti su self-...

2026-11-13 • Phoronix

AMD: 50 LLM su GPU client in tre giorni con HRX Loom

Un team AMD ha portato 50 modelli Hugging Face su GPU client in circa tre giorni, usando il flusso di lavoro con agenti AI e il software HRX Loom v0.1 su hardware Ryzen AI Max 'Strix Halo'. L'esperimento segnala che la barriera per l'inference locale...

#Hardware #LLM On-Premise #DevOps
2026-11-12 • PyTorch Blog

SGLang su IBM Spyre in una settimana: integrazione AI-assisted da 1.500 righe

Due sviluppatori hanno portato SGLang sull'acceleratore IBM Spyre in meno di una settimana, con un plugin di circa 1.500 righe e prestazioni pari a vLLM, 3,6× rispetto a PyTorch. Il lavoro riusa il supporto hardware di PyTorch e i punti di estensione...

#Hardware #LLM On-Premise #DevOps
2026-11-11 • Tom's Hardware

Kora: il sistema Linux che spartisce i modelli AI fra CPU, GPU e NPU

Il co-fondatore di Cyanogen presenta Kora, un sistema operativo Linux pensato per distribuire l'esecuzione dei modelli AI tra CPU, GPU e NPU. L'annuncio segnala un cambiamento strutturale: sfruttare l'intero hardware locale invece di concentrare l'in...

#Hardware #LLM On-Premise #DevOps
2026-11-11 • LocalLLaMA

llama.cpp aggiunge la cache KV in FP8: meno VRAM, contesti più lunghi

llama.cpp ha introdotto il supporto per la cache KV in FP8, riducendo l'occupazione di VRAM durante l'inference di LLM locali. Per chi valuta deployment self-hosted, il vantaggio immediato è gestire contesti più ampi su hardware esistente, ma il camb...

#Hardware #LLM On-Premise #DevOps
2026-11-08 • Tom's Hardware

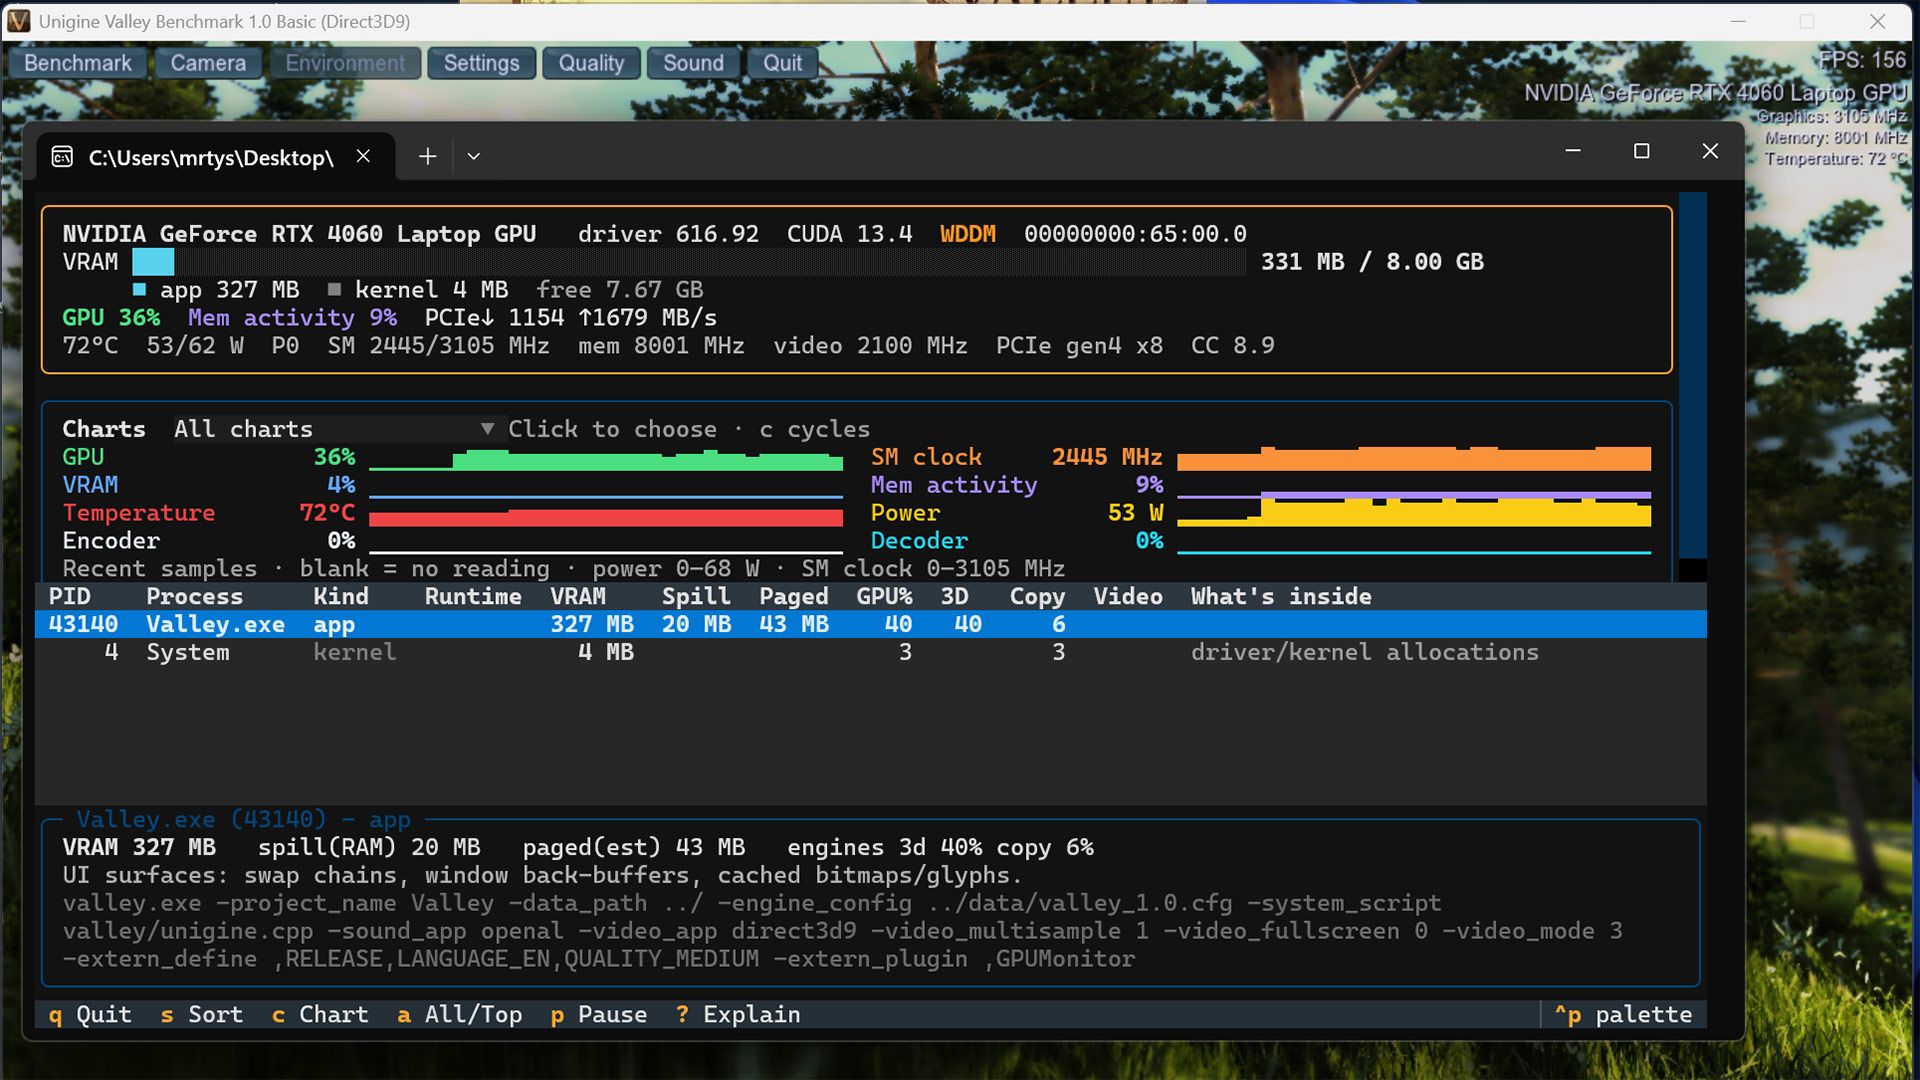
Il task manager GPU open source che svela cosa occupa la VRAM

Un nuovo strumento open source promette di mostrare con precisione quali processi consumano la VRAM. Per chi gestisce LLM in locale, questa visibilità cambia il modo di affrontare colli di bottiglia, dimensionare l'hardware e calcolare il costo reale...

#Hardware #LLM On-Premise
2026-11-07 • LocalLLaMA

KV cache a 8 bit quasi gratis, 4 bit azzardo: i numeri su Qwen3.8 27B

Un benchmark su 35 quantizzazioni con llama.cpp, ExLlamaV3 e vLLM misura la divergenza KL introdotta dalla KV cache quantizzata. A 8 bit il calo di memoria è di circa 1,9-2 GiB a 64k token e l'effetto sulla distribuzione dei token è quasi nullo. Il 4...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-07 • LocalLLaMA

llama.cpp: cache per esperti MoE su CPU, sollievo per GPU con poca VRAM

Una pull request nel progetto llama.cpp introduce llama_moe_cache: una cache per gli esperti MoE eseguiti su CPU e uno script di tuning. L'obiettivo è accelerare l'offloading dei modelli MoE per chi ha poca VRAM, un'idea simile a meccanismi già visti...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic