Topic / Trend Rising

Inference AI local-first e slancio di llama.cpp

Lo stack di inference locale si consolida attorno a llama.cpp con speculative decoding MTP, cache GPU per esperti MoE e supporto a più modelli. I deployment coprono GPU RTX, iPad con eGPU, FPGA, sistemi deskside Blackwell e configurazioni DGX Spark multi-nodo.

Detected: 2026-10-11 · Updated: 2026-10-11

Articoli Correlati

2026-10-09 • LocalLLaMA

Qwen3.8-27B su iPad Pro via eGPU: 159 token/s su R9700

LemonSeed Studio porta l'inference locale di Qwen3.8-27B su iPad Pro usando una GPU AMD esterna in enclosure Thunderbolt. Il motore LSE, identico su iPadOS, macOS e Linux, raggiunge 158,5 token/s su R9700 con decodifica speculativa DFlash2 e 64,4 su ...

#Hardware #LLM On-Premise #DevOps

2026-10-07 • LocalLLaMA

llama.cpp sul palco: il self-hosted cambia fase

Il titolo “llama.cpp on the stage” e un link bastano a segnalare un cambio di percezione. Il runtime C/C++ per inference locale non è più confinato ai repository GitHub: il suo palcoscenico pubblico legittima il deployment self-hosted come scelta str...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-07 • LocalLLaMA

llama.cpp: una cache GPU per gli esperti MoE in memoria di sistema

Una pull request su llama.cpp propone una cache GPU per gli esperti dei modelli MoE quando l’intero modello non entra in VRAM. L’idea mira a ridurre i trasferimenti dalla memoria di sistema, velocizzando l’inference locale su hardware con GPU modesta...

#Hardware #LLM On-Premise #DevOps
2026-10-07 • LocalLLaMA

llama.cpp apre a GLM 5 Flash MTP: il locale si allarga

Una pull request nel repository di llama.cpp introduce il supporto per GLM5Next MTP; la segnalazione su Reddit conferma la possibilità di eseguire GLM 5 Flash MTP in locale. Per chi valuta deployment self-hosted, il passaggio allarga il parco modelli...

#Hardware #LLM On-Premise #DevOps
2026-10-07 • ArXiv cs.AI

FluidPD: elasticità in-place per il serving LLM prefill-decode

FluidPD affronta il disallineamento tra prefill e decode nel serving LLM senza aggiungere worker. FluidToken scarica parte del prefill sui worker di decode quando c'è margine; FluidRole riassegna i ruoli in esecuzione senza ricaricare il modello. Su ...

#Hardware #LLM On-Premise #DevOps

2026-10-06 • ServeTheHome

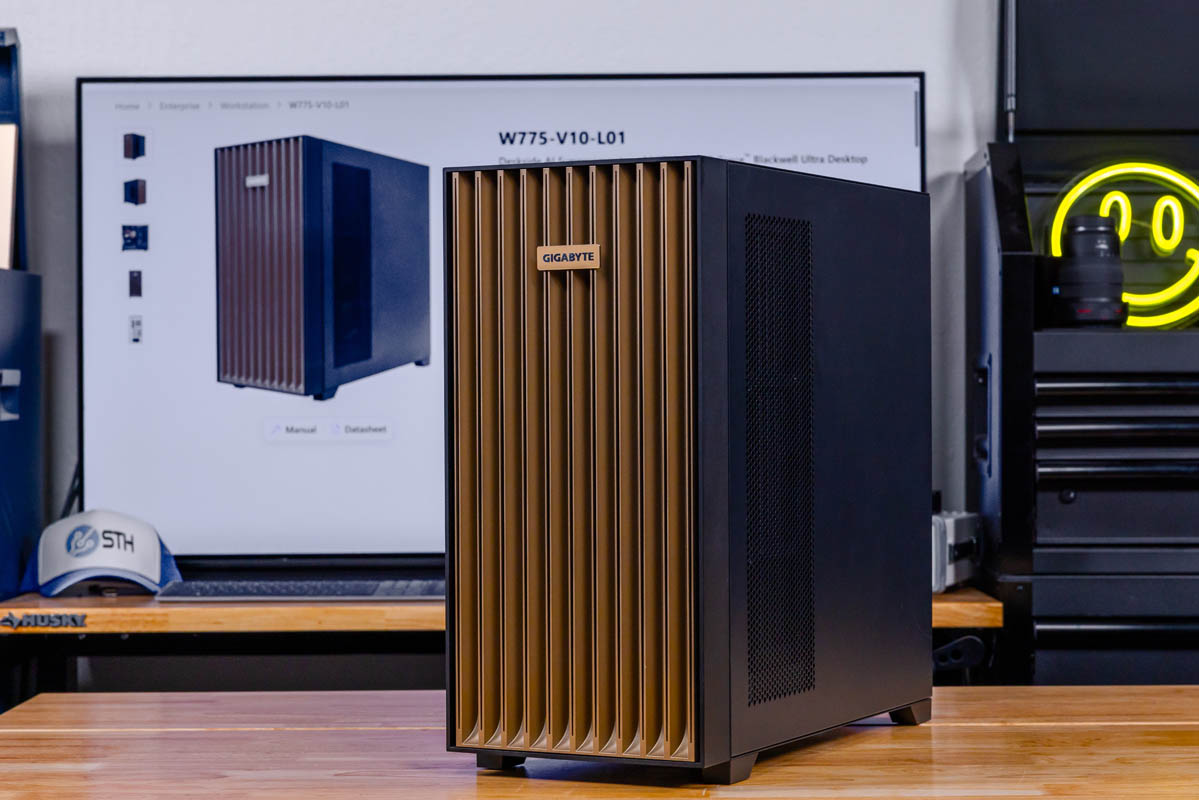
Gigabyte W775-V10-L01: il GB300 porta l'inference locale in formato deskside

Gigabyte ha testato il sistema W775-V10-L01 con NVIDIA GB300, registrando oltre 2,2 miliardi di token al giorno sulla GPU Blackwell Ultra, 800 Gbps dalla ConnectX-8 SuperNIC e il collegamento C2C tra CPU Grace e GPU. Il banco prova deskside segnala c...

#Hardware #LLM On-Premise #DevOps

2026-10-05 • LocalLLaMA

llama.cpp 0.6.0 accelera l'inference locale con il MTP speculative decoding

Il runtime per inference locale llama.cpp arriva alla versione 0.6.0 introducendo il supporto al speculative decoding MTP per i modelli Qwen4Exp. Una novità che rafforza il percorso degli LLM self-hosted, dove il controllo dell'hardware e della pipel...

#Hardware #LLM On-Premise #DevOps

2026-10-05 • Phoronix

Server AI locali, AMD tra ROCm e Vulkan: il test con Llama.cpp

Phoronix mette a confronto i backend Vulkan e ROCm di Llama.cpp su due macchine con GPU AMD Radeon e il server AI locale Lemonade. Il test segnala una scelta strutturale per lo stack self-hosted su AMD: compatibilità hardware contro prestazioni ottim...

#Hardware #LLM On-Premise
2026-10-04 • LocalLLaMA

FPGA ex-mining per Qwen3.5-9B: inference locale a basso costo

Un progetto GitHub esegue un LLM Qwen3.5-9B INT4 su FPGA SQRL ex-mining. Con due FK33 a 75 MHz si ottengono 3,2 token/s in generazione a contesti brevi e 2,4 token/s tra 2k e 3k token. Le stime per Qwen3.8-27B arrivano a 25 token/s con quattro die XC...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic

