Topic / Trend Rising

Inference LLM locale tra vincoli di memoria e hardware

I progetti della community eseguono LLM su GPU consumer, dove la VRAM resta il collo di bottiglia principale. Strumenti come cache KV in FP8, caching degli esperti MoE, GGUF dinamici e speculative decoding stanno emergendo per rendere più praticabile l'inference locale.

Detected: 2026-11-11 · Updated: 2026-11-11

Articoli Correlati

2026-11-11 • LocalLLaMA

llama.cpp aggiunge la cache KV in FP8: meno VRAM, contesti più lunghi

llama.cpp ha introdotto il supporto per la cache KV in FP8, riducendo l'occupazione di VRAM durante l'inference di LLM locali. Per chi valuta deployment self-hosted, il vantaggio immediato è gestire contesti più ampi su hardware esistente, ma il camb...

#Hardware #LLM On-Premise #DevOps

2026-11-09 • LocalLLaMA

Gemma 5 e l'inference self-hosted: il caso di una startup europea

Una startup europea chiede informazioni sui prossimi modelli Gemma e descrive un deployment reale: Gemma 4 31B con quantization NVFP4 su tre RTX Pro 6000, usato per ragionamento linguistico in tedesco e inglese. Il punto non è il coding ma la qualità...

#Hardware #LLM On-Premise #DevOps
2026-11-08 • LocalLLaMA

RTX 5060 Ti 16GB, la corsa all'acquisto per l'AI

La community segnala acquisti in massa della GeForce RTX 5060 Ti 16GB per eseguire modelli AI. Non è un dettaglio da appassionati: indica che la VRAM consumer è diventata la porta d'ingresso per l'inference self-hosted. Il nodo resta la memoria: 16 G...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-08 • LocalLLaMA

RTX 5070 Ti da 16GB: gli agenti locali restano un cantiere aperto

Un utente con RTX 5070 Ti da 16GB e 32GB di RAM ha provato Ollama, vLLM e i framework Goose, Hermes Agent e OpenCode per costruire assistenti locali. Il risultato? Niente di utile. La storia mostra il divario tra narrativa degli agenti self-hosted e ...

#Hardware #LLM On-Premise #DevOps
2026-11-08 • Tom's Hardware

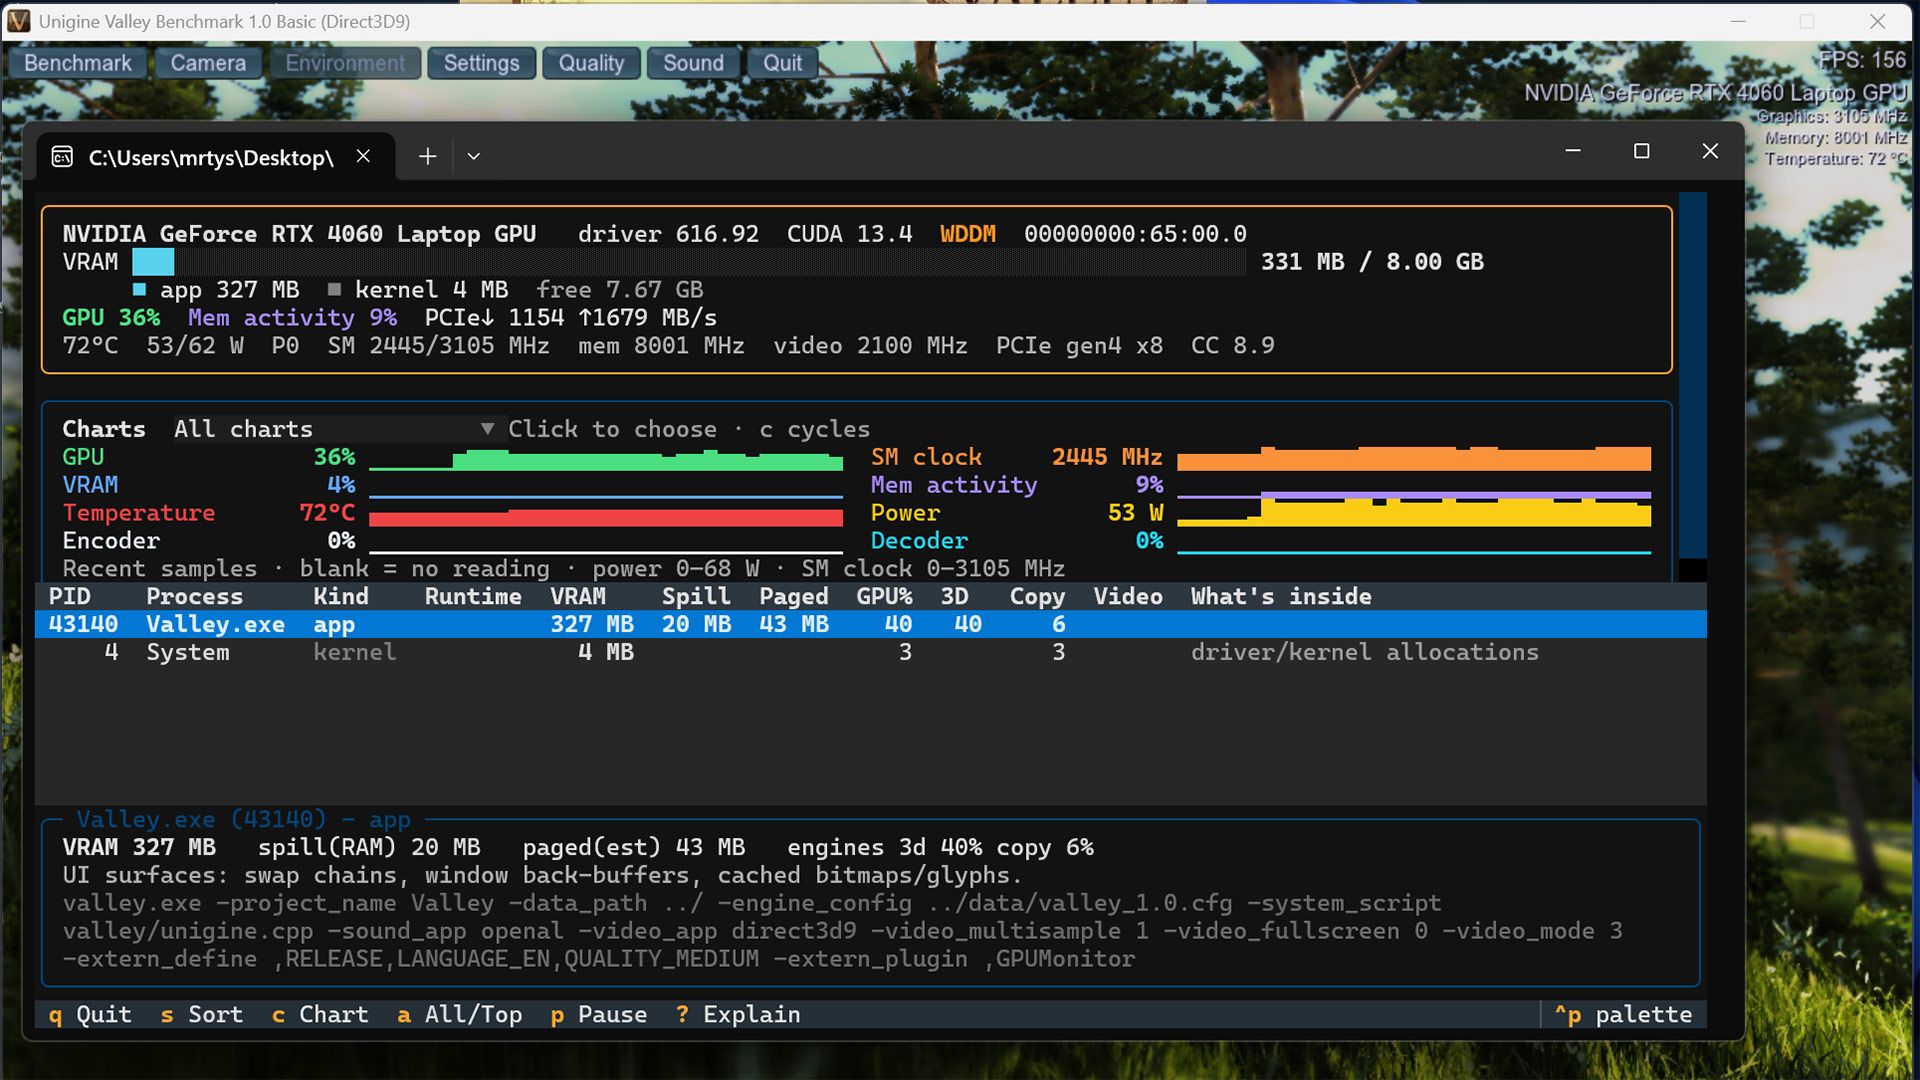
Il task manager GPU open source che svela cosa occupa la VRAM

Un nuovo strumento open source promette di mostrare con precisione quali processi consumano la VRAM. Per chi gestisce LLM in locale, questa visibilità cambia il modo di affrontare colli di bottiglia, dimensionare l'hardware e calcolare il costo reale...

#Hardware #LLM On-Premise
2026-11-07 • LocalLLaMA

KV cache a 8 bit quasi gratis, 4 bit azzardo: i numeri su Qwen3.8 27B

Un benchmark su 35 quantizzazioni con llama.cpp, ExLlamaV3 e vLLM misura la divergenza KL introdotta dalla KV cache quantizzata. A 8 bit il calo di memoria è di circa 1,9-2 GiB a 64k token e l'effetto sulla distribuzione dei token è quasi nullo. Il 4...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-07 • LocalLLaMA

llama.cpp: cache per esperti MoE su CPU, sollievo per GPU con poca VRAM

Una pull request nel progetto llama.cpp introduce llama_moe_cache: una cache per gli esperti MoE eseguiti su CPU e uno script di tuning. L'obiettivo è accelerare l'offloading dei modelli MoE per chi ha poca VRAM, un'idea simile a meccanismi già visti...

#Hardware #LLM On-Premise #DevOps
2026-11-07 • LocalLLaMA

Livello di reasoning a zero: risparmio o trappola per gli agenti LLM?

Un utente chiede se qualcuno usa il livello di reasoning 'none' nei task agentici. La tentazione è risparmiare tempo di generazione token, ma il timore è di perdere pianificazione. Per chi gestisce LLM self-hosted, questo parametro tocca VRAM, latenz...

#LLM On-Premise #DevOps
2026-11-04 • LocalLLaMA

Unsloth migliora i GGUF dinamici per Qwen3.8-Flash-Next

Unsloth ha rilasciato i nuovi GGUF Unsloth Dynamic v3.1 per Qwen3.8-Flash-Next, con guadagni di accuratezza del 10-15% su benchmark agentici come DeepSWE e Terminal Bench. Include un processo di switching tra precisioni BF16, Q8_0, Q5_1 e IQ4_NL, con...

#Hardware #LLM On-Premise #DevOps

← Torna ai Topic