Topic / Trend Rising

Inference LLM locale e ottimizzazione dei runtime

Un'ondata di aggiornamenti in llama.cpp, runtime specializzati e stack di serving sta migliorando i deployment LLM locali, dallo speculative decoding alla cache MoE e al serving elastico. Insieme ad acceleratori accessibili, esperimenti su FPGA e GPU deskside di fascia alta, lo stack self-hosted diventa più veloce e prevedibile.

Detected: 2026-10-09 · Updated: 2026-10-09

Articoli Correlati

2026-10-09 • LocalLLaMA

Qwen3.8-27B su iPad Pro via eGPU: 159 token/s su R9700

LemonSeed Studio porta l'inference locale di Qwen3.8-27B su iPad Pro usando una GPU AMD esterna in enclosure Thunderbolt. Il motore LSE, identico su iPadOS, macOS e Linux, raggiunge 158,5 token/s su R9700 con decodifica speculativa DFlash2 e 64,4 su ...

#Hardware #LLM On-Premise #DevOps

2026-10-07 • LocalLLaMA

llama.cpp sul palco: il self-hosted cambia fase

Il titolo “llama.cpp on the stage” e un link bastano a segnalare un cambio di percezione. Il runtime C/C++ per inference locale non è più confinato ai repository GitHub: il suo palcoscenico pubblico legittima il deployment self-hosted come scelta str...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-07 • LocalLLaMA

llama.cpp: una cache GPU per gli esperti MoE in memoria di sistema

Una pull request su llama.cpp propone una cache GPU per gli esperti dei modelli MoE quando l’intero modello non entra in VRAM. L’idea mira a ridurre i trasferimenti dalla memoria di sistema, velocizzando l’inference locale su hardware con GPU modesta...

#Hardware #LLM On-Premise #DevOps
2026-10-07 • LocalLLaMA

llama.cpp apre a GLM 5 Flash MTP: il locale si allarga

Una pull request nel repository di llama.cpp introduce il supporto per GLM5Next MTP; la segnalazione su Reddit conferma la possibilità di eseguire GLM 5 Flash MTP in locale. Per chi valuta deployment self-hosted, il passaggio allarga il parco modelli...

#Hardware #LLM On-Premise #DevOps
2026-10-07 • ArXiv cs.AI

FluidPD: elasticità in-place per il serving LLM prefill-decode

FluidPD affronta il disallineamento tra prefill e decode nel serving LLM senza aggiungere worker. FluidToken scarica parte del prefill sui worker di decode quando c'è margine; FluidRole riassegna i ruoli in esecuzione senza ricaricare il modello. Su ...

#Hardware #LLM On-Premise #DevOps

2026-10-06 • ServeTheHome

Gigabyte W775-V10-L01: il GB300 porta l'inference locale in formato deskside

Gigabyte ha testato il sistema W775-V10-L01 con NVIDIA GB300, registrando oltre 2,2 miliardi di token al giorno sulla GPU Blackwell Ultra, 800 Gbps dalla ConnectX-8 SuperNIC e il collegamento C2C tra CPU Grace e GPU. Il banco prova deskside segnala c...

#Hardware #LLM On-Premise #DevOps

2026-10-05 • LocalLLaMA

llama.cpp 0.6.0 accelera l'inference locale con il MTP speculative decoding

Il runtime per inference locale llama.cpp arriva alla versione 0.6.0 introducendo il supporto al speculative decoding MTP per i modelli Qwen4Exp. Una novità che rafforza il percorso degli LLM self-hosted, dove il controllo dell'hardware e della pipel...

#Hardware #LLM On-Premise #DevOps

2026-10-05 • Phoronix

Server AI locali, AMD tra ROCm e Vulkan: il test con Llama.cpp

Phoronix mette a confronto i backend Vulkan e ROCm di Llama.cpp su due macchine con GPU AMD Radeon e il server AI locale Lemonade. Il test segnala una scelta strutturale per lo stack self-hosted su AMD: compatibilità hardware contro prestazioni ottim...

#Hardware #LLM On-Premise
2026-10-05 • LocalLLaMA

Una RTX 5090 sfida Claude Code: la harness è decisiva

Un benchmark comunitario mostra che configurazioni locali con RTX 5090 raggiungono il 96% su task di coding, avvicinandosi al 100% di Claude Code Opus 5.5. La variabile critica non è solo il modello: con la stessa GPU e quantization identica, la harn...

#Hardware #LLM On-Premise #DevOps
2026-10-04 • LocalLLaMA

Due DGX Spark in casa: GLM 5.3 Flash gira in locale a velocità interattive

Un utente ha assemblato un setup di inference interamente locale con GLM 5.3 Flash su due DGX Spark, usando vLLM con parallelismo tensoriale a due vie. I numeri dichiarati: prefill a circa 1.500 token/s e decode a circa 40 token/s con 100mila token d...

#Hardware #LLM On-Premise #DevOps

2026-10-04 • LocalLLaMA

FPGA ex-mining per Qwen3.5-9B: inference locale a basso costo

Un progetto GitHub esegue un LLM Qwen3.5-9B INT4 su FPGA SQRL ex-mining. Con due FK33 a 75 MHz si ottengono 3,2 token/s in generazione a contesti brevi e 2,4 token/s tra 2k e 3k token. Le stime per Qwen3.8-27B arrivano a 25 token/s con quattro die XC...

#Hardware #LLM On-Premise #DevOps

2026-10-04 • LocalLLaMA

IQ3_S in loop dopo 10k token: il runtime è parte del problema

Un test sul campo con una quantization IQ3_S mostra che lo stesso identico modello può produrre una risposta coerente in llama.cpp e un loop ripetitivo altrove. Il racconto mette in discussione l'idea che basti scegliere il modello giusto: runtime, s...

#Hardware #LLM On-Premise #DevOps

2026-10-03 • LocalLLaMA

I runtime di inference monoscopo? La nuova normalità per l'hardware locale

Runtime ultra-specializzati come Strata e ninfer rinunciano alla generalità di llama.cpp e vLLM per ottimizzare pochi modelli e una singola famiglia hardware. La scommessa: massimo output da configurazioni locali fisse, anche a costo di codice usa e ...

#Hardware #LLM On-Premise #DevOps

2026-10-03 • LocalLLaMA

Due MoE da 300B su un mini PC da 128 GB: Kyojin spinge Strix Halo

Il progetto Kyojin porta due modelli MoE da circa 300 miliardi di parametri su un singolo mini PC con AMD Strix Halo e 128 GB di memoria. Misurati su Ryzen AI Max+ 395, GLM-5.3-Flash e MiMo-V2.6-Flash raggiungono prefill fino a 650 token/s e decode f...

#Hardware #LLM On-Premise #DevOps

2026-10-03 • LocalLLaMA

llama.cpp dimezza la memoria dell'indice per Qwen Flash Next

Una pull request nel repository llama.cpp introduce un'ottimizzazione che dimezza la memoria dell'indice di scoring per Qwen Flash Next. Il cambiamento, segnalato su Reddit, si traduce in un minore uso di VRAM durante l'inference. Per i deployment on...

#Hardware #LLM On-Premise
2026-10-02 • PyTorch Blog

Helion nel backend vLLM: un solo GEMM, tuning per forma e guadagni fino al 10%

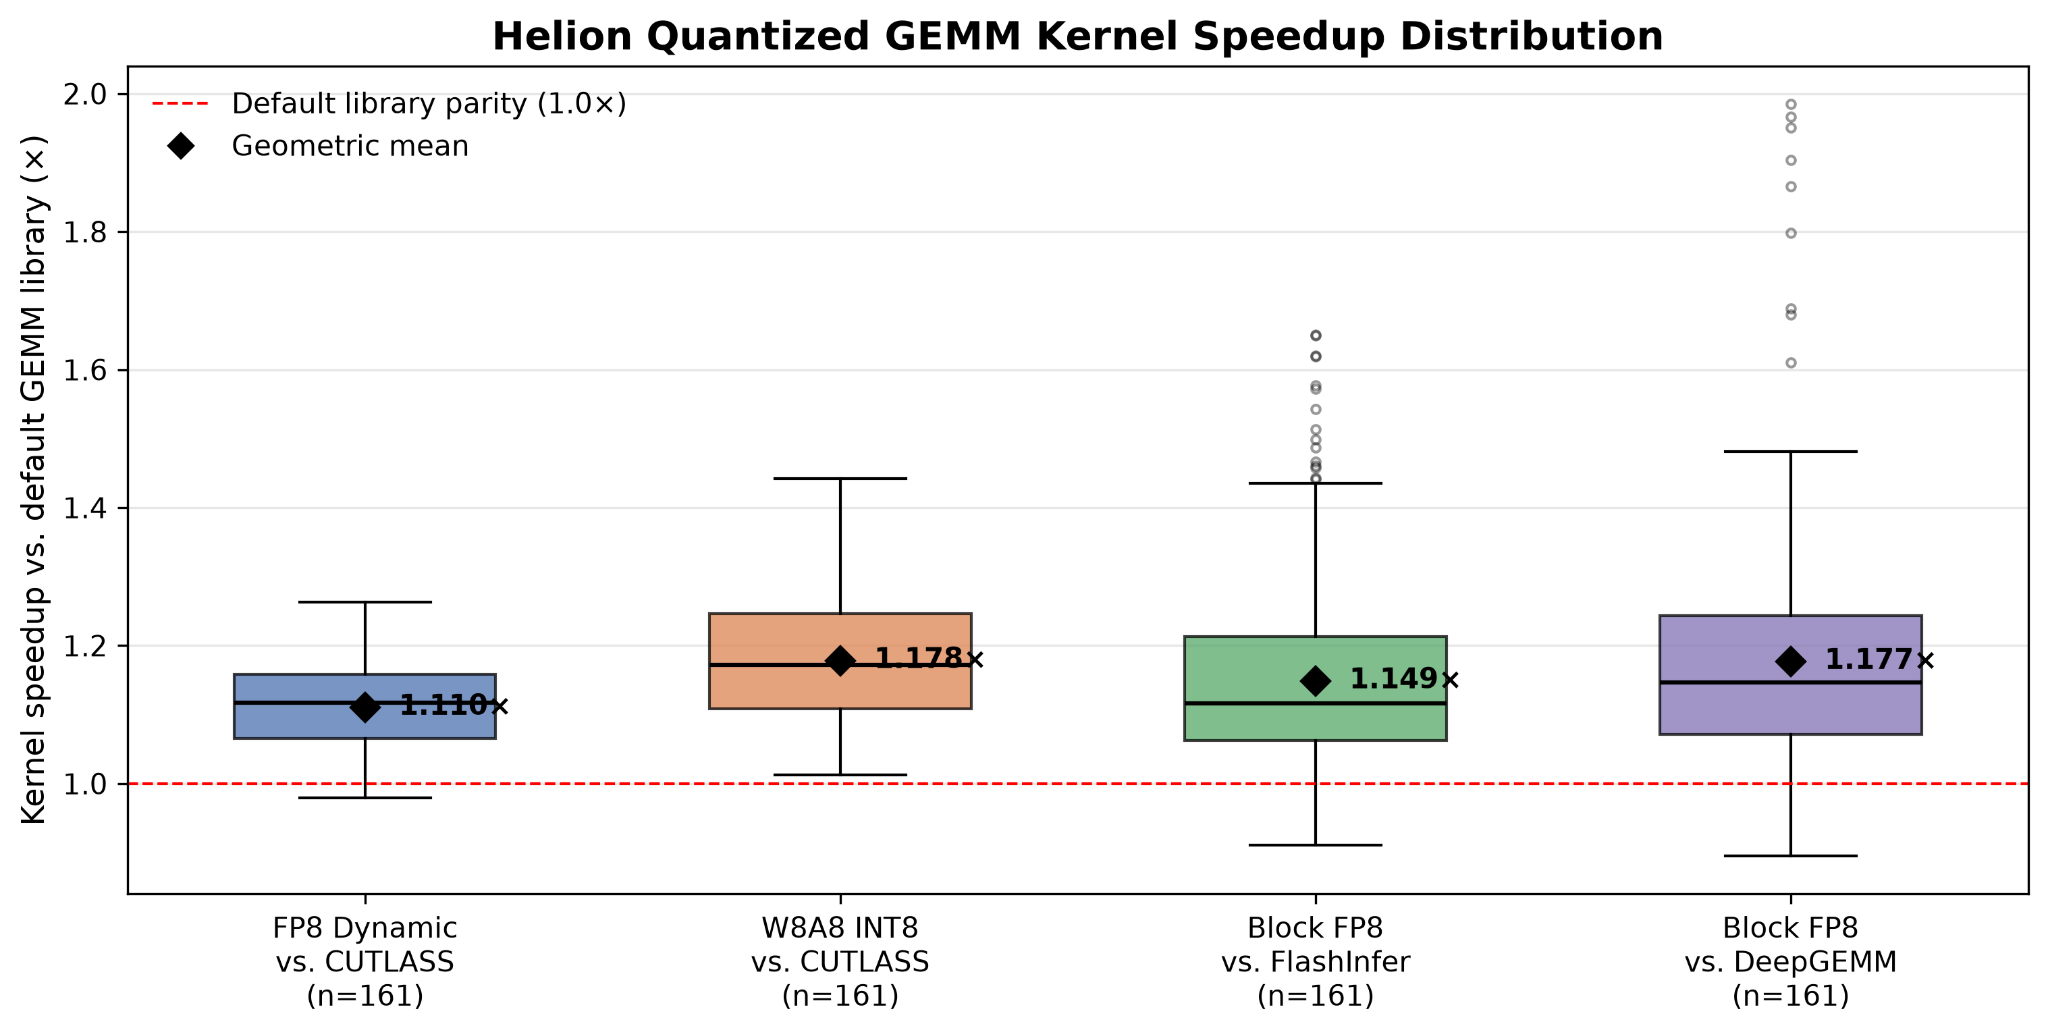
Red Hat e Meta hanno integrato Helion nel backend lineare di vLLM. Un'unica implementazione GEMM copre Standard, Split-K e Swap-AB, con autotuning per forma su GPU Hopper. Nei test su H100, i kernel superano CUTLASS, FlashInfer e DeepGEMM, con miglio...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-02 • LocalLLaMA

llama.cpp aggiunge i Decision Models: l'inference locale cambia passo

Il progetto llama.cpp ha annunciato una nuova funzionalità denominata Decision Models, segnalando un ampliamento oltre la generazione testuale pura. Per chi gestisce Large Language Models in locale, la mossa suggerisce una maturazione verso output pi...

#Hardware #LLM On-Premise #DevOps

← Torna ai Topic