Topic / Trend Rising

L'inference AI locale e self-hosted matura

Le release di llama.cpp, le distribuzioni GGUF MoE e i deployment locali su workstation, hardware Apple e iPad mostrano che l'AI self-hosted supera la nicchia di GitHub.

Detected: 2026-10-12 · Updated: 2026-10-12

Articoli Correlati

2026-10-11 • LocalLLaMA

LLM locali su 10-16GB di VRAM: la classifica e i compromessi reali

Una classifica dal basso mette in fila i modelli eseguibili su GPU consumer con 10-16GB di VRAM e 26-32GB di RAM. L'attenzione è su velocità di almeno 10 token/s, coerenza, gestione di prompt complessi e presenza di pattern ripetitivi. Emergono vinco...

#Hardware #LLM On-Premise #DevOps

2026-10-10 • LocalLLaMA

DigUp porta EmbeddingGemma 2 in locale sul Mac

DigUp è un'app Mac gratuita e open source che esegue EmbeddingGemma 2 in locale per cercare nei file per contenuto, non per nome. Il modello GGUF Q8_0 da 865 MB gira su Apple Silicon via llama.cpp e Metal; la ricerca carica solo il text encoder da 25...

#LLM On-Premise #DevOps
2026-10-09 • LocalLLaMA

Qwen-Image-2.1-Turbo su Hugging Face: il nodo del self-hosting

La presenza di Qwen-Image-2.1-Turbo su Hugging Face segnala un'opzione in più per chi vuole generare immagini in locale. La variante Turbo punta a ridurre la latenza, un aspetto critico per deployment self-hosted con VRAM limitata. Il repository dive...

#Hardware #LLM On-Premise #DevOps

2026-10-09 • LocalLLaMA

Qwen3.8-27B su iPad Pro via eGPU: 159 token/s su R9700

LemonSeed Studio porta l'inference locale di Qwen3.8-27B su iPad Pro usando una GPU AMD esterna in enclosure Thunderbolt. Il motore LSE, identico su iPadOS, macOS e Linux, raggiunge 158,5 token/s su R9700 con decodifica speculativa DFlash2 e 64,4 su ...

#Hardware #LLM On-Premise #DevOps

2026-10-08 • LocalLLaMA

Modelli decisionali su RTX 4090: vince il runtime, non solo la dimensione

Quattro modelli decisionali open testati su una RTX 4090 in affitto: Laya, d1, Clef-Flash e Lev hanno letto 9.534 parole e segnalato nomi di centopiedi. Laya è il più veloce con 3,9 ms per parola su llama.cpp, Lev il più accurato sul target ma circa ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-08 • LocalLLaMA

Mellum2.1: il MoE compatto in GGUF cambia i conti dell'inference locale

La collezione JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF mette in fila due scelte tecniche rilevanti per il self-hosted: architettura MoE con pochi parametri attivi e distribuzione in GGUF. Meno calcolo per token, quantization pronta per CPU e GPU c...

#Hardware #LLM On-Premise #DevOps

2026-10-07 • LocalLLaMA

llama.cpp sul palco: il self-hosted cambia fase

Il titolo “llama.cpp on the stage” e un link bastano a segnalare un cambio di percezione. Il runtime C/C++ per inference locale non è più confinato ai repository GitHub: il suo palcoscenico pubblico legittima il deployment self-hosted come scelta str...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-07 • LocalLLaMA

llama.cpp: una cache GPU per gli esperti MoE in memoria di sistema

Una pull request su llama.cpp propone una cache GPU per gli esperti dei modelli MoE quando l’intero modello non entra in VRAM. L’idea mira a ridurre i trasferimenti dalla memoria di sistema, velocizzando l’inference locale su hardware con GPU modesta...

#Hardware #LLM On-Premise #DevOps

2026-10-07 • LocalLLaMA

LiquidAI d1-3B: un 3B su Hugging Face accende il fronte on-premise

La pagina LiquidAI/d1-3B su Hugging Face, segnalata senza dettagli tecnici, proietta il progetto nel segmento dei LLM compatti. Il nome 3B suggerisce un modello pensato per inference locale, self-hosted e vincoli di sovranità dei dati. L'articolo ana...

#Hardware #LLM On-Premise #DevOps
2026-10-07 • LocalLLaMA

llama.cpp apre a GLM 5 Flash MTP: il locale si allarga

Una pull request nel repository di llama.cpp introduce il supporto per GLM5Next MTP; la segnalazione su Reddit conferma la possibilità di eseguire GLM 5 Flash MTP in locale. Per chi valuta deployment self-hosted, il passaggio allarga il parco modelli...

#Hardware #LLM On-Premise #DevOps
2026-10-06 • ServeTheHome

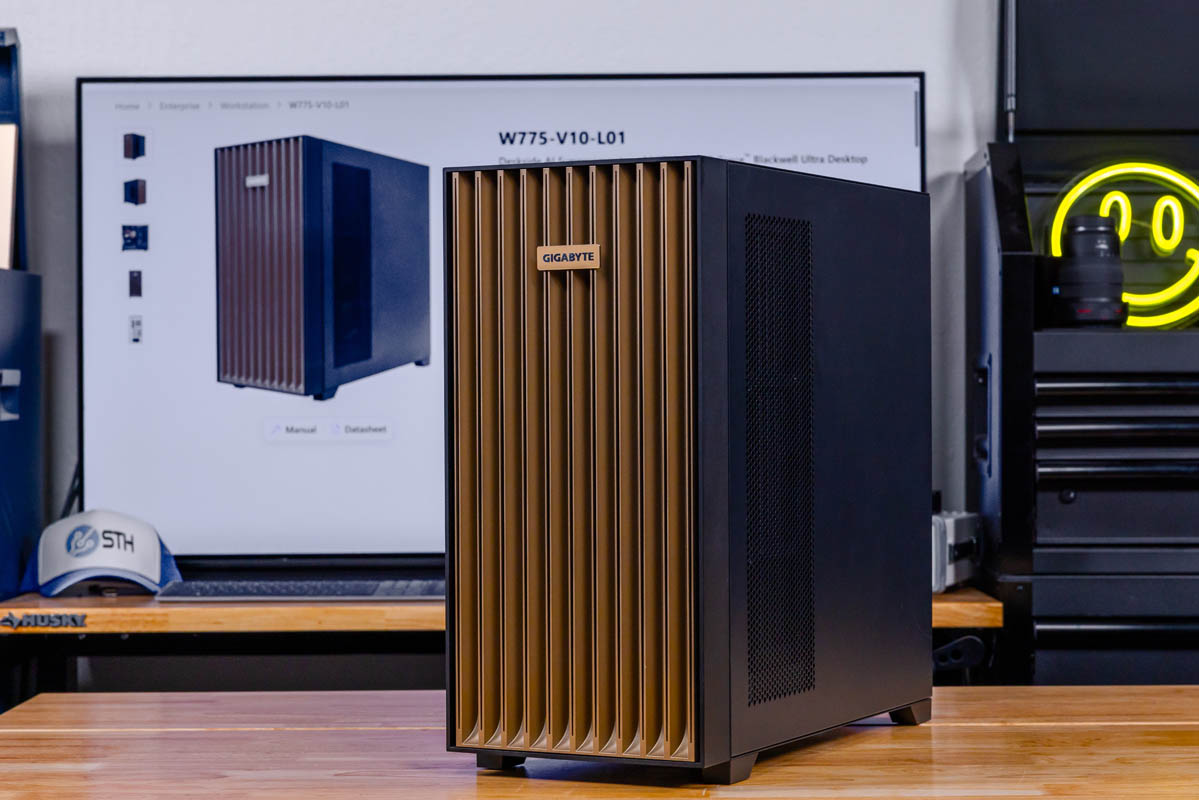
Gigabyte W775-V10-L01: il GB300 porta l'inference locale in formato deskside

Gigabyte ha testato il sistema W775-V10-L01 con NVIDIA GB300, registrando oltre 2,2 miliardi di token al giorno sulla GPU Blackwell Ultra, 800 Gbps dalla ConnectX-8 SuperNIC e il collegamento C2C tra CPU Grace e GPU. Il banco prova deskside segnala c...

#Hardware #LLM On-Premise #DevOps

2026-10-06 • Phoronix

ROCm 10.1: la cadenza software che riscrive il TCO on-premise

ROCm 10.1 conferma il ciclo di sei settimane di AMD per lo stack GPU. Più delle singole funzionalità, conta la prevedibilità: per i deployment self-hosted riduce il rischio di restare bloccati su versioni vecchie e rende il software parte governabile...

2026-10-05 • Phoronix

ROCm 10.1: il ciclo di sei settimane diventa la vera notizia

AMD ha rilasciato ROCm 10.1, poche settimane dopo ROCm 10.0 di fine agosto, confermando il ciclo di aggiornamenti ogni sei settimane. La notizia rilevante non è solo il nuovo pacchetto, ma la cadenza: per chi usa GPU AMD in ambienti self-hosted, la p...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-05 • LocalLLaMA

llama.cpp 0.6.0 accelera l'inference locale con il MTP speculative decoding

Il runtime per inference locale llama.cpp arriva alla versione 0.6.0 introducendo il supporto al speculative decoding MTP per i modelli Qwen4Exp. Una novità che rafforza il percorso degli LLM self-hosted, dove il controllo dell'hardware e della pipel...

#Hardware #LLM On-Premise #DevOps

2026-10-05 • Phoronix

Server AI locali, AMD tra ROCm e Vulkan: il test con Llama.cpp

Phoronix mette a confronto i backend Vulkan e ROCm di Llama.cpp su due macchine con GPU AMD Radeon e il server AI locale Lemonade. Il test segnala una scelta strutturale per lo stack self-hosted su AMD: compatibilità hardware contro prestazioni ottim...

#Hardware #LLM On-Premise
2026-10-05 • LocalLLaMA

Una RTX 5090 sfida Claude Code: la harness è decisiva

Un benchmark comunitario mostra che configurazioni locali con RTX 5090 raggiungono il 96% su task di coding, avvicinandosi al 100% di Claude Code Opus 5.5. La variabile critica non è solo il modello: con la stessa GPU e quantization identica, la harn...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic
