Topic / Trend Rising

Hardware AI on-premise e consumer

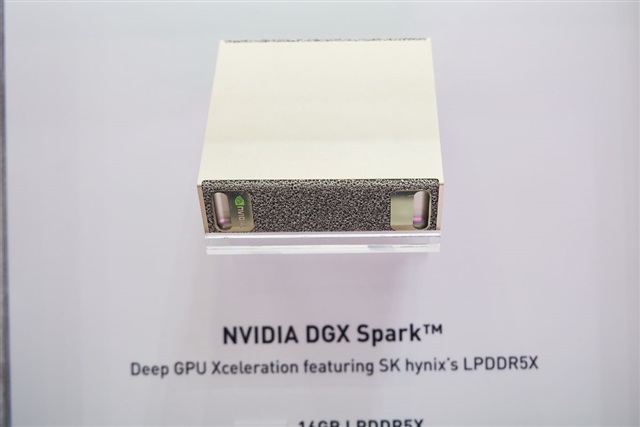
L'inference AI si sposta dal cloud alle macchine locali, spinta dai personal AI computer Nvidia e dalle piattaforme AMD ad alta banda di memoria. Mini PC e workstation ora eseguono grandi modelli MoE interamente in locale, riducendo la dipendenza dal cloud.

Detected: 2026-10-04 · Updated: 2026-10-04

Articoli Correlati

2026-10-03 • LocalLLaMA

Due MoE da 300B su un mini PC da 128 GB: Kyojin spinge Strix Halo

Il progetto Kyojin porta due modelli MoE da circa 300 miliardi di parametri su un singolo mini PC con AMD Strix Halo e 128 GB di memoria. Misurati su Ryzen AI Max+ 395, GLM-5.3-Flash e MiMo-V2.6-Flash raggiungono prefill fino a 650 token/s e decode f...

#Hardware #LLM On-Premise #DevOps

2026-09-28 • DigiTimes

La spinta di Nvidia sui personal AI computer accelera il calcolo on-premise

La spinta di Nvidia verso i personal AI computer, segnalata da DIGITIMES, indica un cambiamento strutturale: l'inference si sposta dal cloud a macchine locali. Per le aziende si aprono scenari di sovranità dei dati e TCO, ma anche vincoli di VRAM e q...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-27 • LocalLLaMA

Qwen 27B genera motion graphics su una RTX 4090: il confine locale si sposta

Un utente ha usato Qwen 27B su una RTX 4090 per produrre motion graphics ispirate ai recenti post con Opus 5.5. Il progetto, costruito con il framework Accuretta, mostra che la generazione creativa locale comincia a coprire casi d'uso finora riservat...

#Hardware #LLM On-Premise #DevOps
← Torna ai Topic