Topic / Trend Rising

Inference LLM locale ottimizzata

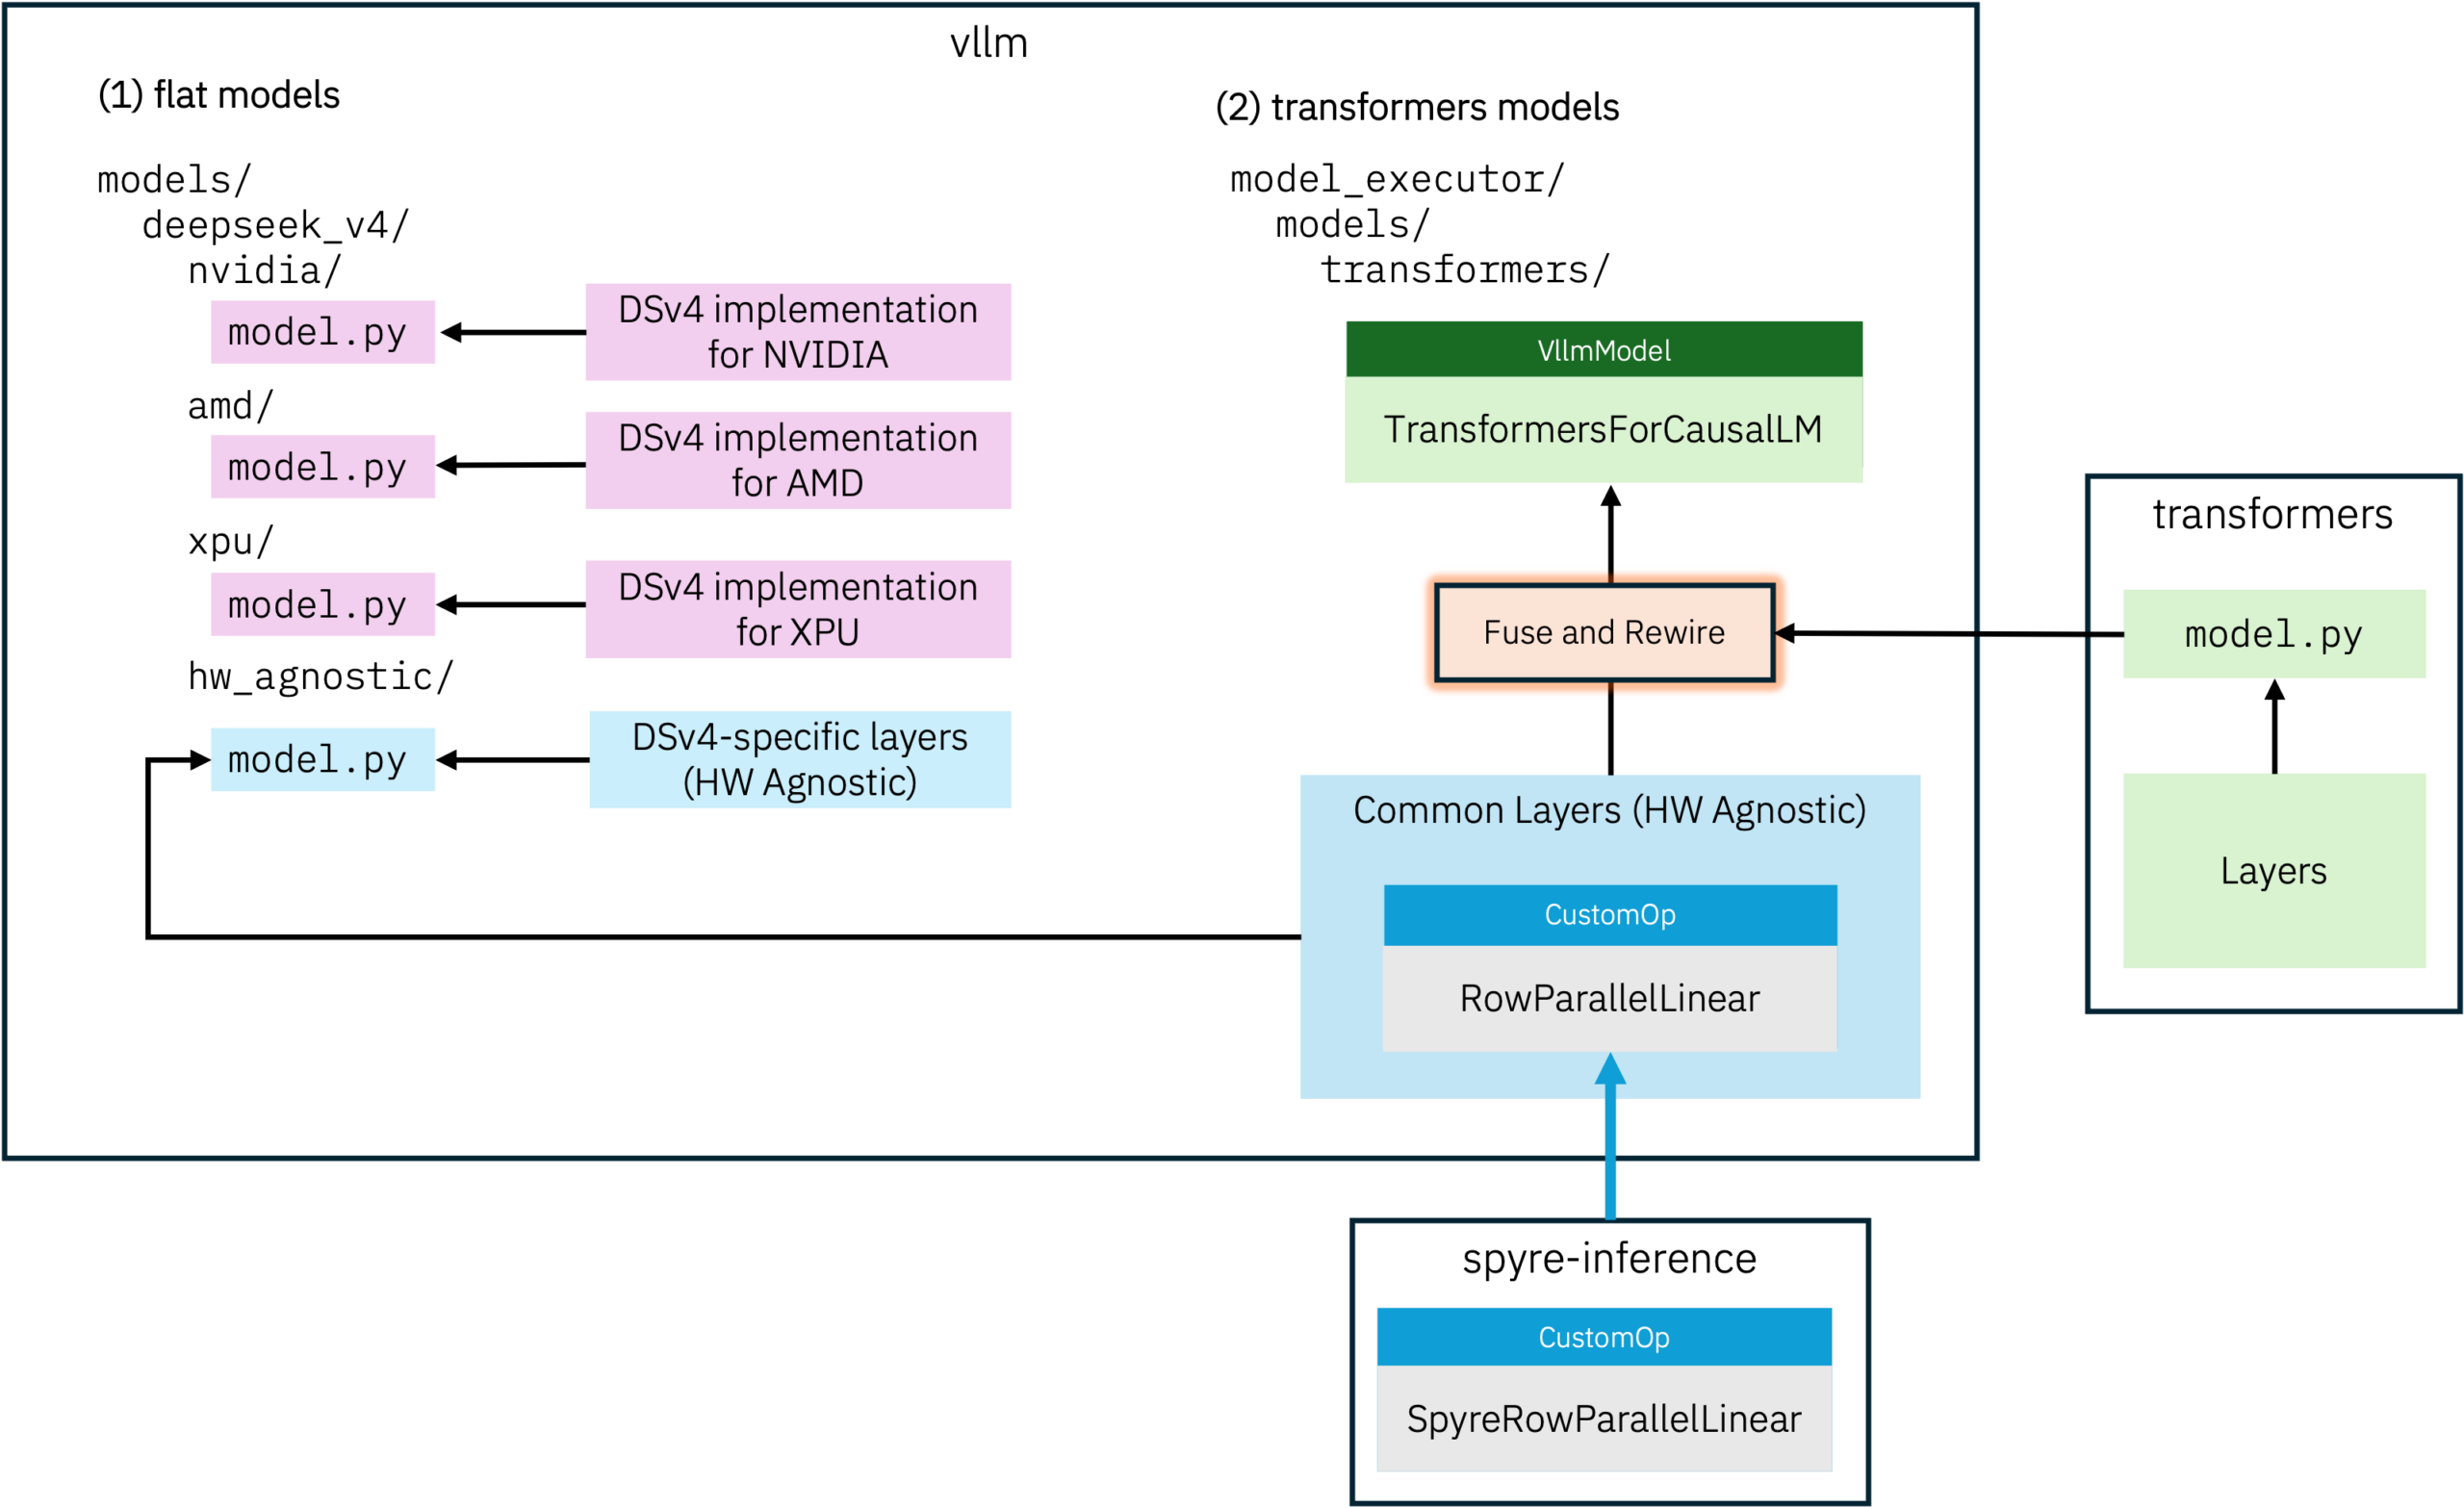
Runtime open source e tecniche di ottimizzazione rendono il deployment LLM locale più veloce ed economico. I boost CPU di llama.cpp, GGUF nativo in Transformers, i livelli hardware-agnostic di vLLM, OpenVINO, Vulkan/ZLUDA e l'attenzione/quantization sparse riducono il costo dell'inference self-hosted.

Detected: 2026-09-27 · Updated: 2026-09-27

Articoli Correlati

2026-09-27 • LocalLLaMA

llama.cpp accelera di 42 volte il prompt lookup drafting

Il runtime open source per l'inference locale dei LLM introduce un miglioramento che rende la fase di prompt lookup drafting 42 volte più veloce. Non si tratta dell'intera generazione, ma di un componente chiave della decodifica speculativa: un cambi...

#Hardware #LLM On-Premise #DevOps

2026-09-26 • LocalLLaMA

llama.cpp accelera il prefill su CPU con mul_mat a tessere per k-quants

Una pull request in llama.cpp introduce una moltiplicazione matrice-vettore a tessere per i formati k-quants. Secondo la segnalazione, l'uso delle istruzioni VNNI accelera il mul_mat su CPU di 3-7 volte con complessità aggiuntiva minima. Il guadagno ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-26 • LocalLLaMA

Oh My Pi apre ai modelli custom: vLLM, llama.cpp, SGLang

Una segnalazione su Oh My Pi indica supporto per modelli custom con vLLM, llama.cpp e SGLang. La fonte è scarna, ma il titolo basta per inquadrare un nodo: il serving self-hosted resta frammentato tra runtime con profili hardware diversi, e l'integra...

#Hardware #LLM On-Premise #DevOps
2026-09-25 • LocalLLaMA

Qwengram-0.8B: memoria n-gram esterna, perplexity giù del 5,05%

Un esperimento tiene congelato Qwen3.5-0.8B, aggiunge una memoria PLE da 51 miliardi di parametri e un reader R=1: la perplexity di validazione scende del 5,05%. L'autore avverte che non è un guadagno di accuratezza su benchmark e pubblica GGUF, runt...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-25 • LocalLLaMA

OpenVINO su Laya: 40 ms per domanda su CPU, 3,4 volte più veloce di PyTorch

Un contributo open source aggiunge il supporto a OpenVINO nel progetto Laya: il tempo di risposta scende a 40 millisecondi per domanda su CPU, con un guadagno di 3,4 volte rispetto a PyTorch. Il risultato mostra quanto l’ottimizzazione runtime possa ...

#Hardware #LLM On-Premise #DevOps
2026-09-23 • LocalLLaMA

GGUF nativi in Transformers: il punto per il deployment locale

Hugging Face ha aggiunto il supporto nativo ai file GGUF in Transformers. Basta indicare il percorso del file quantizzato per caricare il modello e usare le API standard. Su Apple Silicon vengono riutilizzati i kernel ggml, con benchmark su M2 Max vi...

#Hardware #LLM On-Premise #DevOps
2026-09-22 • Phoronix

ZLUDA estende il supporto CUDA su GPU AMD con le API cuFFT

Il progetto open source ZLUDA ha aggiunto il supporto ad alcune API cuFFT di NVIDIA appoggiandosi a hipFFT, il componente dello stack ROCm/HIP di AMD. La novità amplia il perimetro di compatibilità CUDA su GPU non NVIDIA come le Radeon e segnala un c...

#Hardware #LLM On-Premise #DevOps

2026-09-22 • ArXiv cs.LG

PRQuant: quantization low-bit con residui statici e layout contiguo

PRQuant combina riorganizzazione dei canali e compensazione residua statica per ridurre l'overhead di inference nella quantization low-bit. Il metodo è training-free, costruisce offline i blocchi contigui di coda ed evita la raccolta dinamica online,...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-21 • ArXiv cs.LG

Elastic Threshold Attention: sparsità appresa per il decoding long-context

Un’architettura addestrabile end-to-end sostituisce le euristiche rigide con soglie contestuali dinamiche, riducendo il traffico della KV cache senza perdere qualità. Il modello da 1,45 miliardi di parametri ottiene un decoding fino a 2,5 volte più v...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-21 • ArXiv cs.AI

RBS-Attention: sparse prefill senza addestramento per LLM a contesto lungo

Un metodo training-free riduce il costo del prefill nei LLM a contesto lungo affrontando la 'mean dilution', il rischio che un centroide nasconda token rilevanti. RBS-Attention combina un ramo basato sul centroide con un ramo rescue basato sul raggio...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic