Topic / Trend Rising

IA self-hosted: hardware locale e flussi agentici

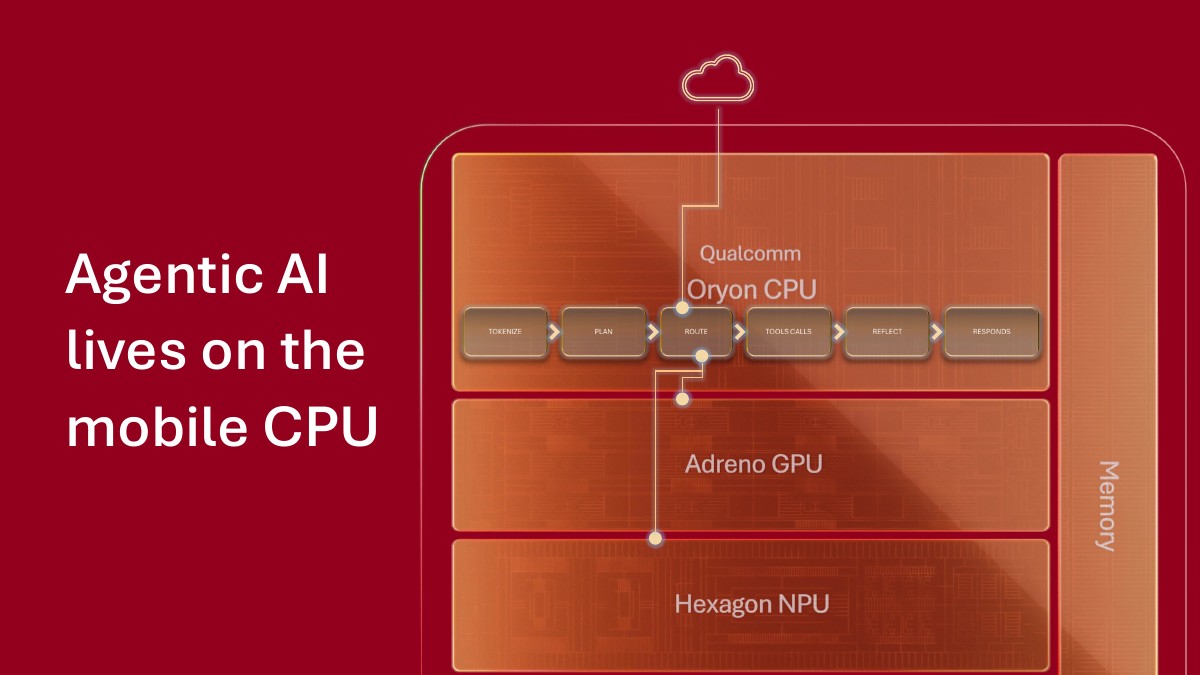
La spinta all'IA locale comprende nuovo silicio on-device, GPU modificate, desktop multi-GPU e strumenti self-hosted che usano MCP, llama.cpp e modelli locali per controllare CAD, scrivere driver o generare SVG. Il fattore comune è ridurre la dipendenza dal cloud mantenendo i flussi agentici su hardware locale.

Detected: 2026-09-14 · Updated: 2026-09-14

Articoli Correlati

2026-09-13 LocalLLaMA

Claude Code verso il self-hosted: serve un harness, non un miracolo

Un utente abituato a Claude Code chiede quale harness locale open source possa sostituirlo su una RTX 3090 da 24 GB di VRAM. Non cerca un LLM più potente, ma un ambiente agente che replichi il loop di modifica ed esecuzione. La richiesta anticipa tim...

#LLM On-Premise #DevOps
2026-09-13 LocalLLaMA

Qwen3.8 Flash Next genera SVG in locale: il rendering non è neutro

Un test self-hosted con Qwen3.8-Flash-Next-IQ4_XS su llama.cpp produce un SVG complesso da un prompt creativo. L'output convince, ma le anteprime divergono: palme e note musicali spariscono nel browser. Il caso mostra perché la generazione di codice ...

#Hardware #LLM On-Premise #DevOps
2026-09-12 Phoronix

Intel porta il driver Linux per NPU su Ubuntu 26.04 LTS

Venerdì Intel ha pubblicato il driver Linux NPU 1.38, aggiungendo il supporto ufficiale per Ubuntu 26.04 LTS. I componenti user-space open source lavorano con il driver kernel IVPU per sfruttare la NPU dei Core Ultra, un passo concreto per l’inferenc...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-09 Phoronix

System76 lancia Thelio Mira AI, desktop multi-GPU per training e inference

System76 ha presentato il Thelio Mira AI, un desktop pensato per carichi multi-GPU: training di modelli, fine-tuning, inference, computer vision e generazione di immagini. La macchina combina CPU AMD Ryzen 9000 con opzioni GPU NVIDIA o AMD e si prest...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-08 LocalLLaMA

GB per dollaro e bandwidth: la bussola per le GPU LLM locali

Una comparazione condivisa su Reddit usa VRAM per dollaro e bandwidth dichiarata per orientarsi tra le GPU più discusse nei canali LocalLLaMA. Prezzi raccolti con ChatGPT, nuovi o di seconda mano, senza garanzie. Un metodo grezzo ma utile per chi val...

#Hardware #LLM On-Premise #DevOps
2026-09-07 LocalLLaMA

Jenny, l'app desktop MIT per LLM locali nata da notti e weekend

Un developer rilascia Jenny, app Electron open source per eseguire LLM in locale con tool calling, rollback e IDE. Nessuna chiamata di rete oltre al runtime locale; sicurezza su comandi distruttivi e modifiche ai file. Windows first, con segnalazioni...

#Hardware #LLM On-Premise #DevOps
2026-09-07 LocalLLaMA

llama.cpp, MCP e FreeCAD: un LLM locale che progetta geometrie

Una guida mostra come collegare llama.cpp, il protocollo MCP e FreeCAD per generare solidi con un modello locale. Il flusso usa Qwen3.8-27B quantizzato Q4_K_M e un proiettore visivo mmproj-F16: il modello può avviare tool, leggere screenshot e verifi...

#Hardware #LLM On-Premise
← Torna ai Topic