Topic / Trend Rising

Data center sovrani e infrastruttura hardware per l'AI

La strategia data center-first di AMD, l'espansione delle TPU di Google, i controlli CUDA ed export di Nvidia e l'investimento europeo di Bull nei supercomputer segnano uno spostamento strutturale verso infrastrutture AI sovrane e su larga scala. L'allontanamento dalle GPU consumer economiche sta ridisegnando le opzioni cloud e on-prem.

Detected: 2026-11-11 · Updated: 2026-11-11

Articoli Correlati

2026-11-10 • DigiTimes

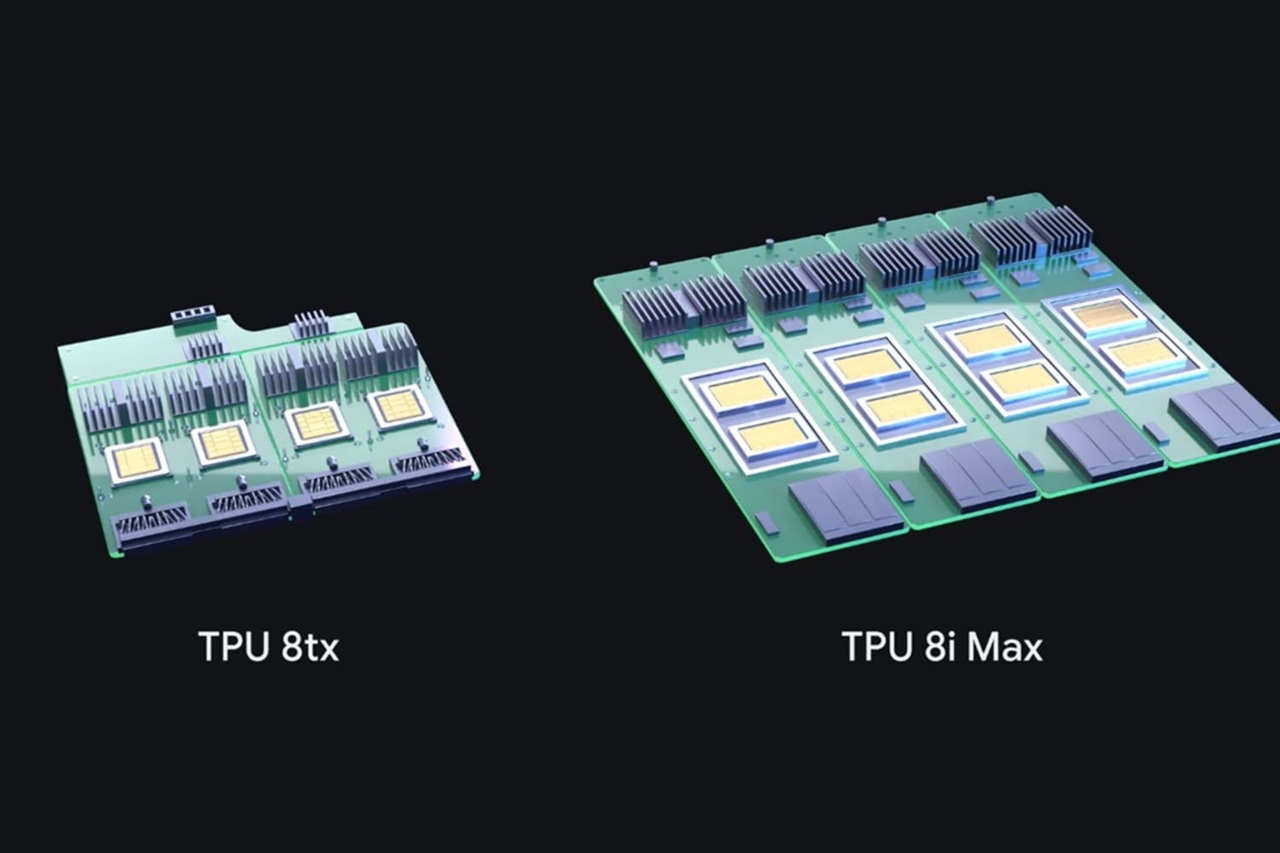
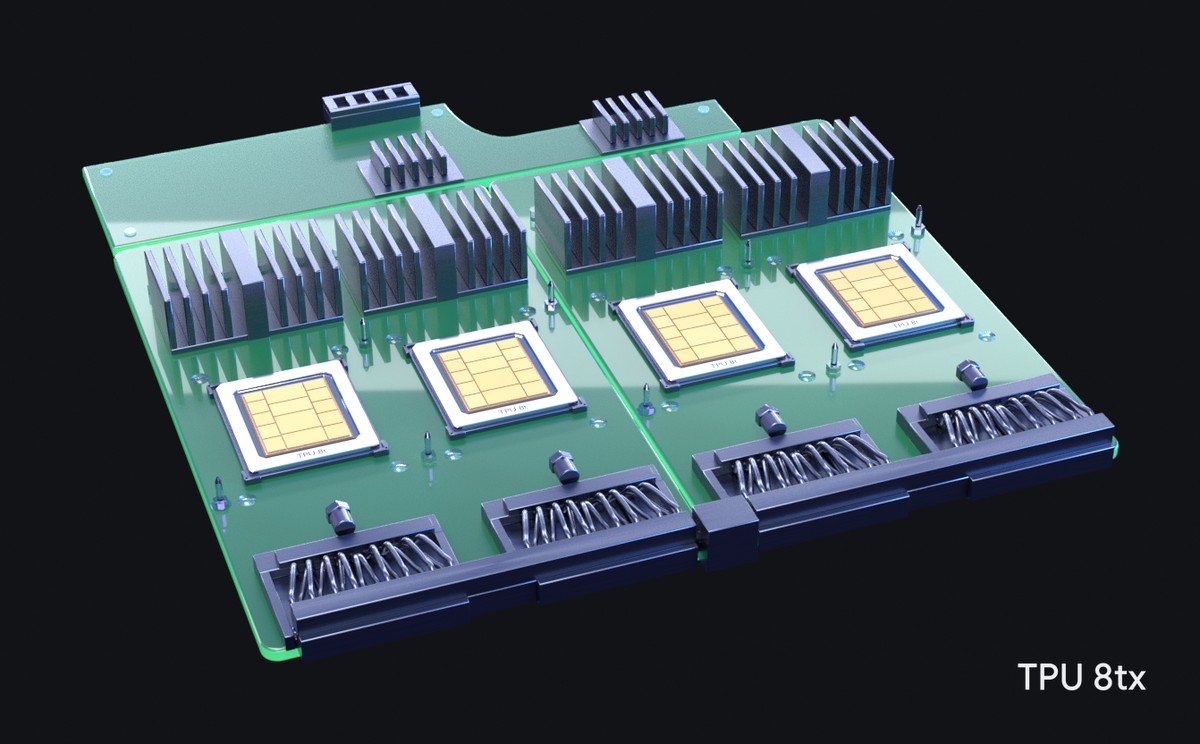
Google amplia l'ottava generazione di TPU per un'AI agentica sicura

Google allarga il portfolio di TPU di ottava generazione e punta su scenari di AI agentica con vincoli di sicurezza e contesti estesi. La mossa riflette una domanda crescente di hardware capace di gestire stato e memoria su orizzonti lunghi, non solo...

#Hardware #LLM On-Premise #DevOps
2026-11-09 • Tom's Hardware

Nvidia stringe la morsa sui noleggi cloud esteri di GPU AI per la Cina

Nvidia intensifica i controlli contro i provider cloud che affittano GPU AI a clienti cinesi aggirando le restrizioni all'export. L'analisi di AI-RADAR: l'effetto non è solo bloccare l'accesso, ma spingere le organizzazioni verso infrastrutture on-pr...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-09 • Tech.eu

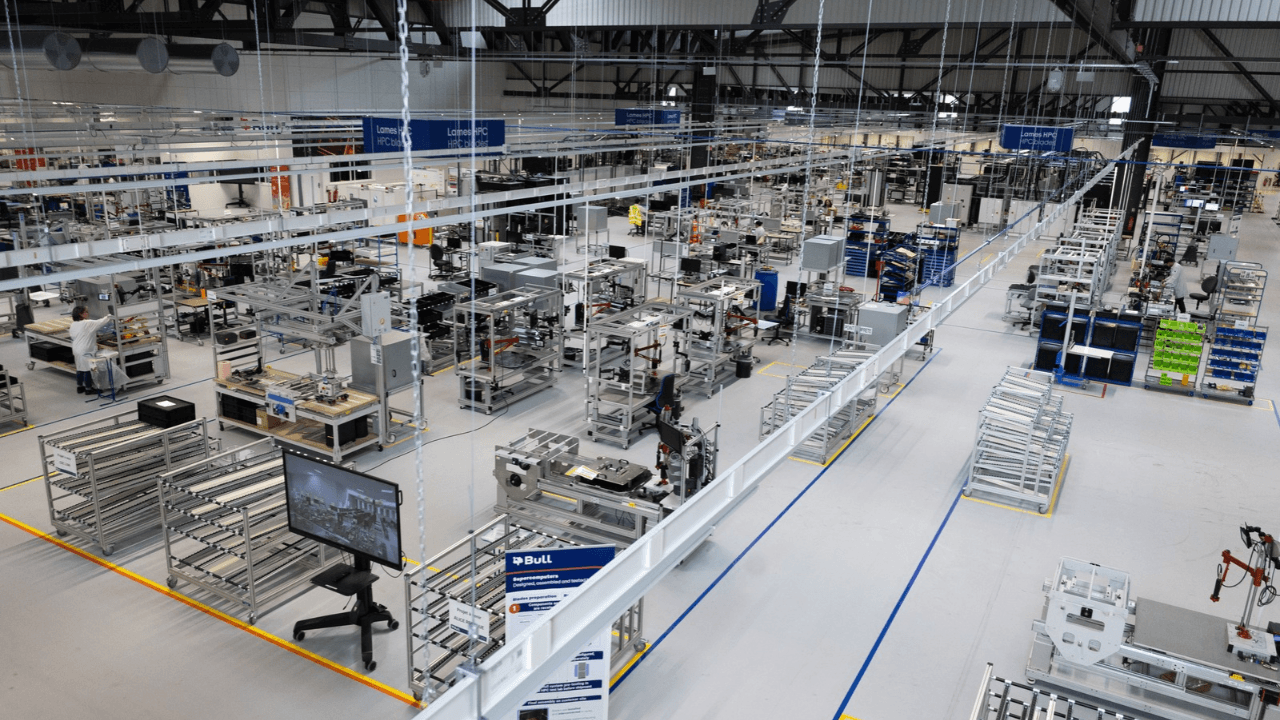
Bull investe 80 milioni per la sovranità europea dei supercomputer

Bull inaugura ad Angers un sito produttivo ampliato con 80 milioni di euro, portando la capacità a 12 rack a settimana e puntando su componenti europei al 70%. L'Open Factory apre l'infrastruttura alle startup, mentre il direct liquid cooling e l'int...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-07 • LocalLLaMA

GPU economiche addio: AMD è 'data center first', avverte il CEO

Il CEO di AMD ha definito l'azienda 'data center first', chiudendo di fatto l'era delle GPU consumer a basso costo come priorità strategica. Per chi pianifica inference LLM self-hosted, il segnale conta: l'offerta di silicio, packaging e VRAM si spos...

#Hardware #LLM On-Premise
2026-11-05 • PyTorch Blog

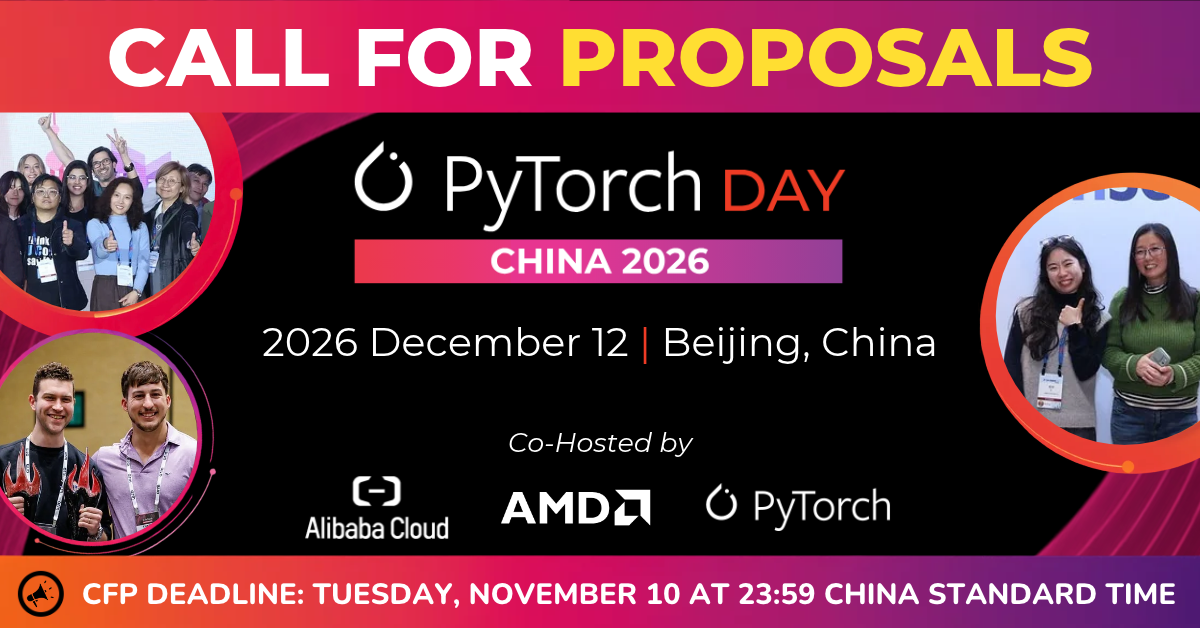
La call di PyTorch Day China 2026 mappa l’inference locale

La scadenza del 10 novembre per PyTorch Day China 2026 rivela un'agenda concentrata su training distribuito, inference efficiente, accelerazione hardware e AI fisica. L'analisi: le tracce scelte mostrano come il framework guardi sempre più ai vincoli...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-04 • Phoronix

CUDA 13.5 porta Vera Rubin nel ciclo di produzione

NVIDIA ha rilasciato CUDA 13.5 insieme al driver Linux 620.70.06. La novità centrale è il supporto in general availability per Vera Rubin, architettura GPU di NVIDIA. Per chi lavora su infrastrutture self-hosted e LLM, il toolchain diventa disponibil...

#Hardware #LLM On-Premise #Fine-Tuning
2026-11-04 • PyTorch Blog

PyTorch Day China 2026: la call svela la svolta verso inference e hardware

La Call for Proposals del PyTorch Day China 2026 chiude il 10 novembre. L'evento di Pechino del 12 dicembre mette al centro cinque aree tematiche, con un'enfasi inedita su inference efficiente, accelerazione hardware e physical AI. Per chi valuta sta...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic