Topic / Trend Rising

Vincoli di VRAM e diversificazione dell'hardware per l'IA locale

La crescente domanda di VRAM sta ridisegnando i prezzi delle GPU e spinge la sperimentazione con AMD, Intel, Apple e perfino console per l'inference locale. Le installazioni enterprise e homelab guardano sempre più a banda, capacità di memoria e alimentazione, non solo alla pura potenza di calcolo.

Detected: 2026-10-18 · Updated: 2026-10-18

Articoli Correlati

2026-10-18 • LocalLLaMA

Una Radeon da 16 GB esegue un LLM da 27B con 262k token: il segnale

Un homelab, non un vendor, ha documentato un LLM da 27 miliardi di parametri con 262.000 token di contesto su una singola Radeon RX 9060 XT da 16 GB di VRAM, usando quantization, streaming della cache KV e fix software. Il segnale: il costo d'ingress...

2026-10-15 • LocalLLaMA

RTX 5060 Ti a $1.292 in Giappone: il Black Friday delle GPU è già un test

La RTX 5060 Ti da 16 GB tocca 1.292 dollari in Giappone con aumenti fino al 144%; la RTX 5080 supera i 2.400. Più che un problema di gaming, è il segnale di una domanda di VRAM contesa con l’inference locale di LLM. I prezzi finali mettono in discuss...

#Hardware #LLM On-Premise #DevOps
2026-10-15 • LocalLLaMA

AMD W7900 e LFM2.5: il segnale di un on-premise sempre più concreto

La prova di un LLM da 24 miliardi di parametri su AMD W7900, con contesto da 128.000 token e circa 95 token al secondo, segnala che l'inference on-premise si consolida anche fuori dall'ecosistema NVIDIA. L'analisi di AI-Radar esplora trade-off, sovra...

2026-10-15 • LocalLLaMA

LiquidAI LFM2.5-24-A2B: performance robuste su AMD W7900 per LLM on-premise

Un utente ha condiviso un'esperienza positiva con il modello LiquidAI LFM2.5-24-A2B (24B parametri), evidenziando performance elevate (~95 tps) su GPU AMD W7900. Il modello, che richiede 30GB di VRAM per la quantization Q8 con un contesto di 128k tok...

#Hardware #LLM On-Premise #DevOps
2026-10-13 • LocalLLaMA

Una PS5 jailbroken esegue Qwen 27B a 20 token/s: segnale per il self-hosting

Una PS5 sbloccata esegue Qwen 27B a circa 20 token/s sulla GPU della console. L'esperimento, emerso su Reddit, mostra come hardware consumer con memoria unificata possa sostenere inference self-hosted su modelli da 27 miliardi di parametri, abbassand...

#Hardware #LLM On-Premise #DevOps
2026-10-12 • LocalLLaMA

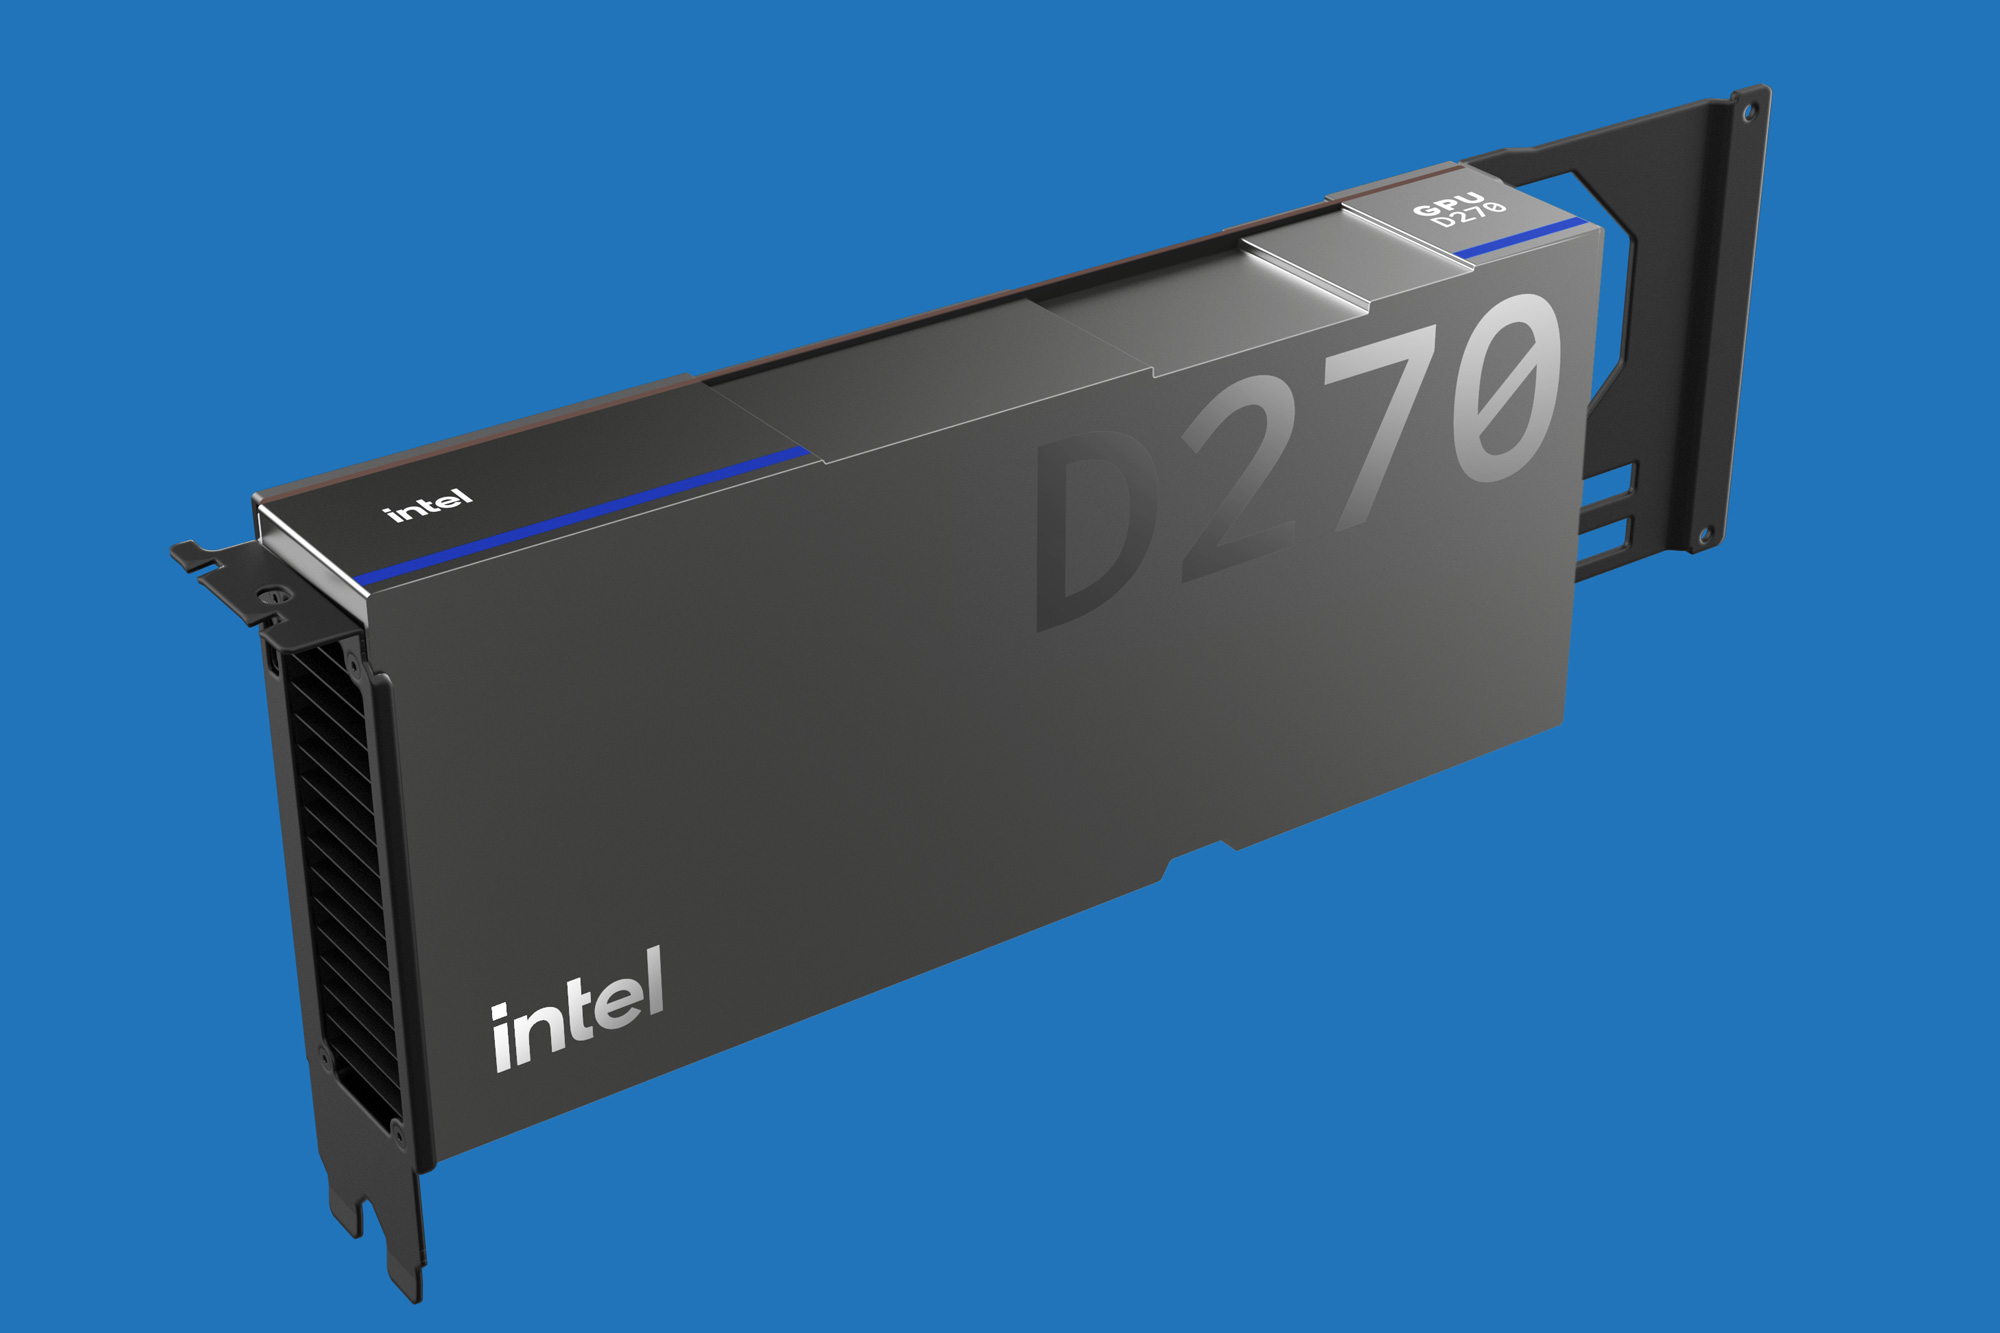
Intel Crescent Island diventa D-Series: fino a 480 GB di LPDDR5X

Intel ha trasformato Crescent Island in una linea commerciale: D-Series. La scheda D270 integra 32 core Xe3P, 256 XMX engine, fino a 480 GB di LPDDR5X e 1,5 TB/s di banda. Le prestazioni dichiarate arrivano a 1,3 PetaFLOPS FP8, con supporto da FP4 a ...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-12 • Phoronix

Da Crescent Island alla serie D: Intel punta sull’inference aziendale

Intel ha annunciato la serie GPU D, erede dei prodotti noti come Crescent Island e pensata per l’inference in ambito enterprise. L’annuncio non include specifiche su VRAM o prestazioni, ma il cambio di denominazione segnala un posizionamento più dire...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-12 • ServeTheHome

Intel D-Series: la D270 sceglie l’inference con FP8 e 1,5 TB/s

Intel svela nome e specifiche della scheda di inference per data center Crescent Island: D-Series e D270 con 1,3 PFLOPS FP8 denso e 1,5 TB/s di banda memoria. Un indizio per chi valuta hardware on-prem per LLM.

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-12 • LocalLLaMA

RTX 5080 da 24 GB: un rumor del 2027 che sposta gli equilibri on-premise

Un rumor da Reddit indica una RTX 5080 da 24 GB nel primo trimestre 2027, ma i partner non hanno ancora dettagli. Per chi fa inference locale di LLM, la VRAM è il vincolo chiave. Il silenzio informativo rallenta integratori e progettisti di macchine ...

#Hardware #LLM On-Premise #DevOps
2026-10-12 • Tom's Hardware

RTX 4090 'rotta' a 350 dollari: dentro una GPU falsa e memoria sostituita

Un acquirente ha pagato 350 dollari per una RTX 4090 rotta, ma il tecnico ha scoperto una GPU falsa e memorie sostituite. La truffa, documentata da un riparatore russo, usa PCB dummy sofisticati. Per chi costruisce infrastrutture LLM on-premise, l'ep...

#Hardware #LLM On-Premise #Fine-Tuning
2026-10-11 • LocalLLaMA

LLM locali su 10-16GB di VRAM: la classifica e i compromessi reali

Una classifica dal basso mette in fila i modelli eseguibili su GPU consumer con 10-16GB di VRAM e 26-32GB di RAM. L'attenzione è su velocità di almeno 10 token/s, coerenza, gestione di prompt complessi e presenza di pattern ripetitivi. Emergono vinco...

#Hardware #LLM On-Premise #DevOps
2026-10-11 • Tom's Hardware

Una GPU nel posto sbagliato? Hotspot più freddo di 19 gradi

Un modder registra una riduzione di 19 gradi sull'hotspot spostando la GPU in una posizione non convenzionale. Il dato, apparentemente minimo, riapre il confronto sulla progettazione termica dei sistemi locali per LLM: la scelta degli slot e dei flus...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic