AI-Radar - Osservatorio su LLM locali, hardware AI e trend

AI-Radar per LLM on-prem & AI in casa

Il radar quotidiano su modelli, framework e hardware per far girare l'AI in locale. LLM, LangChain, Chroma, mini-PC e tutto ciò che serve per un cervello distribuito "in-house".

⚙️ Stack: LLM locali · LangChain · Transformers · ChromaDB · MiniPC · AI boxes
🛰️ Ask Observatory (Q&A + RAG) già collegato all'archivio articoli.
👥 160+ membri · Iscriviti gratis →

⚡ In Tendenza

View All →

🛠️ Guide & Osservatorio On-Premise

🚀 Esegui i modelli in locale → Tutte le guide →

Riferimenti evergreen e pratici per far girare l'AI in locale — hardware, costi, privacy e stack completo.

🖥️ Osservatorio LLM On-Premise Hardware, stack, governance e architetture di riferimento per l'AI in locale. →

Ultime analisi & news dal radar

Articoli generati dall'AI sulla base dei feed, con spazio per layer editoriale umano sopra il contenuto grezzo.

Nvidia spinge i personal AI computer: l'on-premise diventa un formato
📁 OnPremise AI generated ✅ DigiTimes

Nvidia spinge i personal AI computer: l'on-premise diventa un formato

La spinta di Nvidia sui personal AI computer segnala un cambio di baricentro: l'inference LLM si avvicina al dispositivo locale. Non è solo hardware consumer, ma un nodo on-premise in miniatura che tocca VRAM, quantization, TCO e sovranità dei dati. Per i team IT si apre una terza via tra cloud e data center: occorre valutare carichi stabili, vincoli di memoria e complessità operativa.
2026-09-28 📰 Fonte
Snapdragon 8 Elite Gen 6: l'inference locale sposta il perimetro dei dati
📁 Hardware AI generated ✅ ServeTheHome

Snapdragon 8 Elite Gen 6: l'inference locale sposta il perimetro dei dati

Qualcomm presenta due system-on-chip con matrix core nella GPU e supporto LPDDR6. Non è una corsa ai benchmark: è un segnale sul confine della sovranità dei dati, che si sposta nel dispositivo. L'analisi AI-Radar sui vincoli di memoria, Quantization e TCO per chi valuta LLM locali.

2026-09-27 📰 Fonte
Qwengram-0.8B: memoria esterna e gate dinamica cambiano i conti del self-hosted
📁 OnPremise AI generated ℹ️ LocalLLaMA

Qwengram-0.8B: memoria esterna e gate dinamica cambiano i conti del self-hosted

Qwengram-0.8B congela Qwen3.5-0.8B e aggiunge una memoria n-gram da 51 miliardi di parametri fuori dal GGUF. La perplexity scende del 5,05%, ma il dato rilevante è l'architettura: iniezione tardiva governata da una gate per token, sidecar quantizzato Q8_0 e nessun fine-tuning del backbone. Per chi gestisce LLM locali, il segnale è la separazione tra pesi e conoscenza: aggiornare la memoria senza toccare il modello apre scenari nuovi, ma impone vincoli severi ai runtime.

2026-09-26 📰 Fonte
Sicurezza, ad hominem e controllo locale: il vero costo degli LLM addomesticati
📁 LLM AI generated 🏆 ArXiv cs.CL

Sicurezza, ad hominem e controllo locale: il vero costo degli LLM addomesticati

Il fine-tuning di sicurezza non è neutro: riduce lo spazio strategico degli LLM nei dibattiti reali. Per i deployment on-premise conta il controllo dei pesi, delle pipeline e del TCO. L'analisi AI-Radar mette a fuoco il trade-off tra modelli pronti via API e sistemi self-hosted capaci di ridefinire il comportamento conversazionale.

2026-09-25 📰 Fonte
AMD e GDDR7 su Linux: il segnale infrastrutturale per chi fa inference on-premise
📁 Hardware AI generated ℹ️ Tom's Hardware

AMD e GDDR7 su Linux: il segnale infrastrutturale per chi fa inference on-premise

L'avvio del supporto GDDR7 nei driver Linux di AMD segnala un cambiamento per chi gestisce infrastrutture AI on-premise. La notizia, apparentemente tecnica, anticipa l'importanza della banda di memoria per l'inference LLM e riduce l'attrito di integrazione per ambienti self-hosted. Un segnale da leggere in ottica TCO e sovranità dei dati, più che come annuncio di prodotto.

2026-09-24 📰 Fonte
AliceAI 80B: architettura custom e il nodo dei runtime
📁 LLM AI generated ℹ️ LocalLLaMA

AliceAI 80B: architettura custom e il nodo dei runtime

Yandex ha pubblicato un base model da 80 miliardi di parametri con architettura custom e componente attiva ridotta. Non è una fine-tune di Qwen3 e non ha supporto in Llama.cpp: un doppio segnale. AI-RADAR analizza le implicazioni per chi valuta deployment on-premise: maturità dell'ecosistema di inference, costo di porting, proliferazione di architetture. Non è un modello plug-and-play, ma un indicatore di direzione tecnica.

2026-09-22 📰 Fonte
BI-Bench e BI-Agent: il vero divario è nell'orchestrazione dei dati
📁 OnPremise AI generated 🏆 ArXiv cs.LG

BI-Bench e BI-Agent: il vero divario è nell'orchestrazione dei dati

La BI end-to-end rivela un limite strutturale dei LLM: sotto il 50% di accuratezza senza guida umana. Il guadagno vero arriva da architetture che orchestrano strumenti e da post-training su dati proprietari. Per chi valuta on-premise e self-hosted, il TCO si sposta verso GPU, metadati e pipeline, non verso il costo per token.

2026-09-21 📰 Fonte
Von, 395M parametri e solo CPU: cosa cambia per l'inference on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

Von, 395M parametri e solo CPU: cosa cambia per l'inference on-premise

Von, un LLM open source da 395 milioni di parametri, gira interamente su CPU con 1-2 GB di memoria e latenze dichiarate tra 25 e 300 ms. Presentato su Reddit come sostituto di JEV, senza ottimizzazione iniziale, riapre il confronto su deployment locali senza GPU. Per AI-RADAR il segnale non è il benchmark, ma il costo di verifica indipendente e la possibilità di self-hosted dentro il perimetro aziendale.

2026-09-20 📰 Fonte
Bonsai 2 Swift e il costo nascosto dei token nel self-hosted
📁 OnPremise AI generated ℹ️ LocalLLaMA

Bonsai 2 Swift e il costo nascosto dei token nel self-hosted

La domanda di UkisAI su Bonsai 2 Swift non riguarda un semplice aggiornamento. Mette in luce come il TCO degli LLM locali dipenda sempre più dal comportamento a runtime: token sprecati, loop di overthinking e scelte di quantization ridefiniscono l'efficienza on-premise.

2026-09-19 📰 Fonte
Il Transformer che amplifica il disaccordo cambia i conti dell'on-premise
📁 OnPremise AI generated 🏆 ArXiv cs.CL

Il Transformer che amplifica il disaccordo cambia i conti dell'on-premise

MDT trasforma la divergenza tra volto, voce e testo nel segnale centrale dell'analisi clinica, raggiungendo 0,7408 Macro F1 sul test BAH e addestrandosi in meno di venti minuti su singola GPU. Per AI-Radar il dato chiave è operativo: un modello che codifica il conflitto con token espliciti sposta l'attenzione su pipeline parallele, VRAM e TCO, rendendo più concreta l'elaborazione locale dei video sensibili.

2026-09-18 📰 Fonte
63 ore di inference autonoma su una RTX 3090: il vero carico è l'orchestrazione
📁 OnPremise AI generated ℹ️ LocalLLaMA

63 ore di inference autonoma su una RTX 3090: il vero carico è l'orchestrazione

Un esperimento con un LLM da 27 miliardi di parametri in quantization a 4 bit su una RTX 3090, per 63 ore, non risolve Riemann ma mostra la tenuta di pipeline agentiche self-hosted. Il valore non è il teorema: è la stabilità di processo, la gestione della memoria e l'ownership dei dati. AI-Radar analizza implicazioni per infrastruttura locale, valutazione e orchestrazione.

2026-09-17 📰 Fonte
Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise
📁 OnPremise AI generated ✅ DigiTimes

Cache KV: il nuovo fronte dell'infrastruttura LLM on-premise

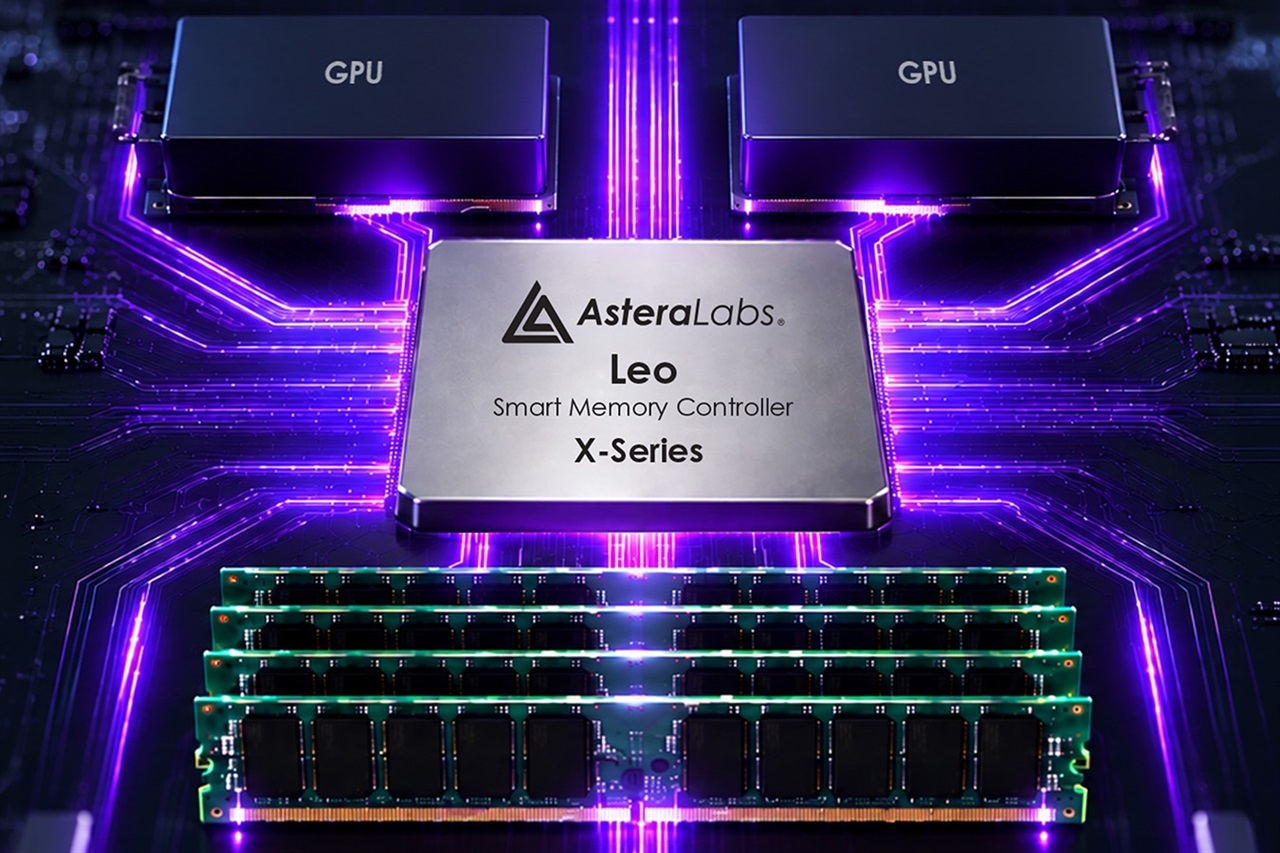
La mossa di Astera Labs sposta l'attenzione dal calcolo alla memoria. La cache KV, critica per i carichi agentici, diventa un vincolo fisico che incide su parallelismo, latenza e TCO. Per i deployment self-hosted e on-premise la gerarchia di memoria e il movimento dei dati diventano criteri di scelta non più secondari.

2026-09-16 📰 Fonte
Il diritto all'AI locale, la sicurezza e la spinta alla centralizzazione
📁 OnPremise AI generated ℹ️ LocalLLaMA

Il diritto all'AI locale, la sicurezza e la spinta alla centralizzazione

La rivendicazione del diritto di eseguire AI in locale, emersa in un dibattito sulla sicurezza, segnala una frattura profonda tra controllo distribuito e centralizzazione. Le restrizioni sui modelli aperti rischiano di colpire il self-hosted, la sovranità dei dati e l’hardware per l’inference on-premise, spostando il mercato verso API proprietarie e cloud. L’analisi esplora incentivi, effetti di secondo ordine e TCO, senza ridurre la sicurezza a un pretesto.

2026-09-14 📰 Fonte
Budget: un LLM denso da 9,4B su una scheda sposta il vincolo dalla GPU alla comunità
📁 OnPremise AI generated ℹ️ LocalLLaMA

Budget: un LLM denso da 9,4B su una scheda sposta il vincolo dalla GPU alla comunità

Un ricercatore indipendente ha preparato un modello denso da 9,4 miliardi di parametri per il training su una singola scheda, con distillazione da Llama 3 e semplificazioni architetturali. Non ci sono benchmark, ma il segnale per l'AI on-premise è chiaro: il collo di bottiglia non è più l'hardware, ma dati, iterazione e comunità. Il progetto Budget mostra che la barriera per l'addestramento locale è scesa.

2026-09-13 📰 Fonte
Personalità nel prompt, non nei pesi: il nuovo confine dell'on-premise
📁 LLM AI generated ℹ️ LocalLLaMA

Personalità nel prompt, non nei pesi: il nuovo confine dell'on-premise

Un metodo in tre passaggi mostra come ottenere chatbot 'umani' senza fine-tuning: biografia, voce, istruzioni operative. Per i deployment on-premise il segnale è duplice: meno pressione sul training, ma più fragilità e rischi di audit. Il costo si sposta dall'addestramento all'inference, mentre la governance del testo diventa parte dell'infrastruttura. La partita si gioca sempre più sulla scrittura dei prompt, non sui pesi.

2026-09-12 📰 Fonte
BabyLM 2026: perché l'efficienza dei dati è una leva per il TCO on-premise
📁 LLM AI generated 🏆 ArXiv cs.CL

BabyLM 2026: perché l'efficienza dei dati è una leva per il TCO on-premise

Nel BabyLM 2026 Strict-Small, Qiushi Engine ha guadagnato 0,23 punti Overall su nove metriche senza aumentare la scala, ma riorganizzando l'esperienza attorno alle dipendenze contestuali. Per chi valuta LLM self-hosted, il segnale è il principio di efficienza dei dati: sposta parte del costo da hardware e VRAM a progettazione del corpus e supervisione.

2026-09-11 📰 Fonte
Enflame e il completamento del framework GPU cinese: il capitale non basta
📁 Hardware AI generated ✅ DigiTimes

Enflame e il completamento del framework GPU cinese: il capitale non basta

La quotazione di Enflame chiude il ciclo delle quattro IPO dei produttori GPU cinesi. Il segnale finanziario è chiaro: Pechino considera i chip per AI una priorità strategica. Ma il capitale raccolto non sana da solo il divario di ecosistema software, VRAM, bandwidth e compatibilità con pipeline di fine-tuning e inference. Per infrastrutture self-hosted e on-premise, la vera partita si gioca su driver, strumenti e maturità operativa.
2026-09-10 📰 Fonte
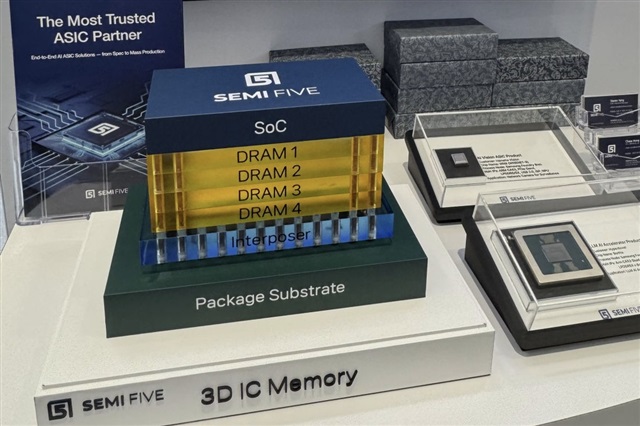
SEMIFIVE sul 4nm di Samsung: il primo stress test industriale degli ASIC per LLM
📁 Hardware AI generated ✅ DigiTimes

SEMIFIVE sul 4nm di Samsung: il primo stress test industriale degli ASIC per LLM

La produzione degli HyperAccel sul nodo a 4nm di Samsung segnala il passaggio degli acceleratori dedicati ai LLM da sperimentazione a logica industriale. La capacità limitata introduce pressioni su consegne e allocazione dei wafer. Per i deployment self-hosted, gli ASIC promettono TCO più basso su carichi stabili, ma vincolano l'hardware a modelli e schemi di quantization poco flessibili. Il trade-off va valutato oltre il costo di acquisto.

2026-09-09 📰 Fonte
Cambricon nella PyTorch Foundation: il software è la vera partita dell'hardware
📁 Hardware AI generated ✅ PyTorch Blog

Cambricon nella PyTorch Foundation: il software è la vera partita dell'hardware

L’ingresso di Cambricon come membro Platinum della PyTorch Foundation segnala un cambio di fase: controllare lo stack software open source conta quanto la potenza dei chip. Per chi valuta LLM self-hosted, il supporto nativo di backend diversi riduce dipendenza da CUDA, manutenzione e TCO. Restano da verificare continuità e maturità dei contributi upstream.

2026-09-08 📰 Fonte
Astra e LLM open source: il divario vero è nell’orchestrazione
📁 OnPremise AI generated ℹ️ LocalLLaMA

Astra e LLM open source: il divario vero è nell’orchestrazione

Un post su Reddit chiede quando i LLM open source raggiungeranno Astra. Il segnale non riguarda i pesi del modello, ma l'infrastruttura: pipeline multimodale, runtime di inference, memoria e orchestrazione. Per chi valuta stack on-premise, il divario si traduce in trade-off tra controllo, latenza e TCO. L'open source può competere su compiti specifici, ma l'esperienza integrata richiede investimenti coordinati. AI-Radar analizza le implicazioni per deployment locali e sovranità dei dati.

2026-09-07 📰 Fonte
Open source e laboratori di frontiera: quando la parità percepita sposta il mercato
📁 OnPremise AI generated ℹ️ LocalLLaMA

Open source e laboratori di frontiera: quando la parità percepita sposta il mercato

La percezione di parità tra modelli open source e laboratori di frontiera, emersa in un dominio critico, sposta la competizione dalla qualità tecnica a costi e governance. Chi gestisce dati sensibili guarda al self-hosted come opzione concreta: TCO, latenza e controllo superano il punteggio dei benchmark. Il segnale indica pressione sui token, domanda di hardware per inference locale e un premio fragile per le API chiuse.

2026-09-06 📰 Fonte
Tencent Hy4 su llama.cpp: il segnale per l'inference locale
📁 OnPremise AI generated ℹ️ LocalLLaMA

Tencent Hy4 su llama.cpp: il segnale per l'inference locale

La pull request #28127 per integrare Hy4-preview in llama.cpp non porta benchmark, ma segnala la convergenza dell'ecosistema self-hosted. Anche i vendor cloud mostrano attenzione alle pipeline on-premise. Restano da verificare stabilità, licenze e documentazione: il valore reale si misurerà su costi operativi, efficienza e vincoli di sovranità.

2026-09-05 📰 Fonte
Nvidia-Hugging Face: il controllo dell'AI passa da pagamenti e talenti
📁 OnPremise AI generated ✅ DigiTimes

Nvidia-Hugging Face: il controllo dell'AI passa da pagamenti e talenti

L'accordo tra Nvidia e Hugging Face segnala che il controllo dell'ecosistema LLM passa anche da clausole finanziarie. Pagare i concorrenti nel silicio e vincolare un miliardo di dollari al personale incide su neutralità delle piattaforme, costo del talento e dipendenze per chi valuta stack self-hosted e on-premise. Un segnale da monitorare accanto a VRAM, inference e TCO.

2026-09-04 📰 Fonte
Dai profili sintetici ai segnali reali: il fine-tuning cambia la personalizzazione degli LLM
📁 LLM AI generated 🏆 ArXiv cs.CL

Dai profili sintetici ai segnali reali: il fine-tuning cambia la personalizzazione degli LLM

La ricerca di ServiceNow mostra che i profili comportamentali estratti da interazioni reali offrono una personalizzazione più aderente rispetto alle personas sintetiche. Il metodo combina fine-tuning supervisionato e ragionamento multi-prospettiva, spostando l'attenzione dai template identitari ai segnali osservati. Per chi gestisce LLM self-hosted, il passaggio impone pipeline di pulizia, anonimizzazione e governance più articolate, con costi infrastrutturali ma anche un vantaggio competitivo legato alla sovranità dei dati.

2026-09-02 📰 Fonte
Quantization come superficie d'attacco: il vuoto tra validazione e deployment
📁 OnPremise AI generated 🏆 ArXiv cs.LG

Quantization come superficie d'attacco: il vuoto tra validazione e deployment

La compressione post-training non è una trasformazione neutra. Un paper mostra classi di equivalenza comportamentale che collassano parametri diversi e aprono backdoor attivate solo dopo quantization INT8 o 4 bit. I test su modelli multilingua segnalano fino all'85,02% di inversione friend-foe e ΔBias=0,33. Per deployment on-premise e air-gapped, l'audit del solo checkpoint sorgente non basta: va certificata ogni coppia modello-compressione e ogni percorso di produzione.

2026-08-31 📰 Fonte
La leva runtime che porta un LLM da 27B a 100k token su 16 GB
📁 Hardware AI generated ℹ️ LocalLLaMA

La leva runtime che porta un LLM da 27B a 100k token su 16 GB

Un setup su Reddit mostra un modello dense da 27 miliardi di parametri a 47-50 token/s con contesto da 100.000 token su una RTX 4070 Ti SUPER da 16 GB. Il segnale non è il modello, ma il controllo fine del runtime: cache KV asimmetrica kvarn5/kvarn4, coda di 1.024 token a piena precisione e decodifica speculativa. Sposta il vincolo dalla VRAM al software di serving, con implicazioni per TCO e sovranità dei dati.
2026-08-30 📰 Fonte
HP Z4 G6i: il prezzo è solo la superficie del segnale Linux-ready
📁 Hardware AI generated ✅ Phoronix

HP Z4 G6i: il prezzo è solo la superficie del segnale Linux-ready

La workstation HP Z4 G6i unisce Xeon serie 600, grafica RTX e supporto Linux dichiarato, ma la configurazione top supera i 41mila dollari. Il segnale per AI-Radar non è la potenza assoluta: è la legittimazione delle macchine da lavoro come nodi on-premise per LLM, inference locale e fine-tuning su dati sensibili. Restano da verificare GPU, VRAM e gestione operativa, variabili decisive per valutarne il TCO e l'uso reale.

2026-08-29 📰 Fonte
Nvidia-Hugging Face: il nodo dei modelli diventa un asset hardware
📁 OnPremise AI generated ✅ Ars Technica AI

Nvidia-Hugging Face: il nodo dei modelli diventa un asset hardware

L’eventuale acquisizione di Hugging Face da parte di Nvidia va letta come presa di controllo su un punto di passaggio per modelli, pesi e pipeline. Per i deployment on-premise e self-hosted cambia il piano di distribuzione: neutralità, accesso e sovranità tecnica diventano variabili industriali. AI-Radar analizza implicazioni e segnali da monitorare.

2026-08-28 📰 Fonte
GreenLeaf Law Embed Tiny, il retrieval giuridico si fa locale
📁 OnPremise AI generated 🏆 ArXiv cs.LG

GreenLeaf Law Embed Tiny, il retrieval giuridico si fa locale

Un embedding giuridico da 0,6 miliardi di parametri mostra che distillazione, hard negative mining e quantization binaria possono spostare il retrieval legale verso deployment self-hosted. Il dato strutturale non è solo il benchmark, ma la possibilità di servire ricerca giuridica su hardware locale con TCO ridotto, dati nel perimetro e dataset specializzato come vero fossato. Restano aperti i limiti per l'uso ad alto rischio.

2026-08-27 📰 Fonte
Qwen3.8-27B scende a 19,7 GB: cosa cambia per l'on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

Qwen3.8-27B scende a 19,7 GB: cosa cambia per l'on-premise

Un checkpoint Qwen3.8-27B in NVFP4 mostra che la quantization W4A4 guidata da distillation può portare un LLM da 27 miliardi di parametri sotto i 20 GB senza perdite rilevanti. L'analisi AI-Radar legge il risultato come un cambio di soglia per VRAM e TCO, ma anche come un vincolo hardware NVIDIA Blackwell e uno spostamento del costo di precisione verso il training.

2026-08-26 📰 Fonte
ToMoE e la sparsità dinamica: meno calcolo per gli LLM locali
📁 OnPremise AI generated ℹ️ LocalLLaMA

ToMoE e la sparsità dinamica: meno calcolo per gli LLM locali

ToMoE converte checkpoint densi in MoE senza fine-tuning, riducendo i parametri attivi per token ma non il footprint in memoria. Un cambio di logica per l'on-premise: meno calcolo, stesso modello. Restano aperti i nodi runtime, latenza e VRAM. Il segnale per chi gestisce LLM locali è la sparsità dinamica come leva di deployment.
2026-08-25 📰 Fonte
DeepSeek V4 Flash in cantina: la CPU ECC cambia i conti dell'on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

DeepSeek V4 Flash in cantina: la CPU ECC cambia i conti dell'on-premise

Un Epyc 7663, 256 GB di RAM ECC e una RTX 5090 portano un LLM MoE da 151 GB a 24 token/s in quantization Q8_K_XL. Il caso ribalta l'assunto che serva VRAM aggregata pari ai pesi: il bilanciamento tra CPU, banda di memoria e PCIe diventa il vero vincolo. Un segnale concreto per chi valuta TCO e sovranità dei dati.

2026-08-24 📰 Fonte
Dopo Qwen 3.8 27B: il silenzio che sposta il TCO verso il locale
📁 OnPremise AI generated ℹ️ LocalLLaMA

Dopo Qwen 3.8 27B: il silenzio che sposta il TCO verso il locale

Il silenzio dei vendor chiusi dopo Qwen 3.8 27B segnala un cambio di pressione competitiva: la retorica della sicurezza si affievolisce quando un LLM da 27B può girare in locale con 16 GB di VRAM. La barriera hardware scende, il TCO si sposta dal costo per token ai costi di gestione e l'on-premise diventa opzione di produzione. AI-RADAR analizza implicazioni per governance, hardware e regolamentazione.

2026-08-23 📰 Fonte
Depth pruning su Qwen3.8-27B: la leggerezza non è gratuita
📁 OnPremise AI generated ℹ️ LocalLLaMA

Depth pruning su Qwen3.8-27B: la leggerezza non è gratuita

Uno sviluppatore ha ridotto Qwen3.8-27B a 22,7 miliardi di parametri con pruning di profondità, senza fine-tuning. Distribuito solo in MLX per Apple Silicon, mostra trade-off: meno pressione su memoria e calcolo, ma perdite nei casi limite. Per l'on-premise il costo si sposta dalla produzione alla validazione.

2026-08-20 📰 Fonte
DFlash 2 via llama.cpp: la distribuzione dei quantizzati è il segnale
📁 OnPremise AI generated ℹ️ LocalLLaMA

DFlash 2 via llama.cpp: la distribuzione dei quantizzati è il segnale

La seconda versione di DFlash non arriva con un annuncio ma con la PR 27342 su llama.cpp e i quantizzati GGUF già pronti per Qwen 3.8 27B e Muse Glimmer. AI-Radar analizza il cambio di baricentro: il vero collo di bottiglia dell'on-premise non è il modello ma la disponibilità immediata di artefatti verificabili. Il trade-off tra sperimentazione rapida e governance del ciclo di vita software definisce il prossimo test di maturità per lo stack locale.

2026-08-19 📰 Fonte
FPO e il fine-tuning senza backward pass: l'adattamento locale cambia baricentro
📁 Frameworks AI generated 🏆 ArXiv cs.LG

FPO e il fine-tuning senza backward pass: l'adattamento locale cambia baricentro

FPO propone un fine-tuning dei LLM che non propaga errori tra i layer e non costruisce grafi autograd. Il metodo riduce il picco di memoria e accelera il throughput, ma concentra l'adattamento nei layer finali. Per chi gestisce modelli self-hosted, il guadagno operativo è reale: va però verificato con una diagnosi rapida, altrimenti il vantaggio si trasforma in un vincolo architetturale.

2026-08-18 📰 Fonte
Il benchmark come obiettivo: distorsione dei ranking e rischi per l'on-premise
📁 LLM AI generated 🏆 ArXiv cs.LG

Il benchmark come obiettivo: distorsione dei ranking e rischi per l'on-premise

Il fine-tuning su SWE-bench non trasferisce capacità a suite come Django o LiveCodeBench. Il benchmark diventa obiettivo di addestramento e smette di misurare capacità generale. Per chi gestisce LLM self-hosted, un punteggio gonfiato falsa il calcolo di VRAM, quantization e TCO. Serve una valutazione multi-task e una manutenzione continua dei benchmark, non un numero singolo.

2026-08-17 📰 Fonte
Qwen3.8-27B: la chiusura del loop visivo sposta il valore on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

Qwen3.8-27B: la chiusura del loop visivo sposta il valore on-premise

Un confronto amatoriale tra Qwen3.6-27B e Qwen3.8-27B su un ray tracer in BASIC mostra una differenza decisiva: la capacità di osservare il rendering e correggere il codice in autonomia. Con quantization spinta e hardware locale, il ciclo chiuso riduce la supervisione umana e sposta la valutazione dagli LLM one-shot agli agenti multi-turno.

2026-08-16 📰 Fonte
Lemonade 11.6: il segnale è nel runtime, non nel modello
📁 OnPremise AI generated ✅ Phoronix

Lemonade 11.6: il segnale è nel runtime, non nel modello

AMD aggiorna Lemonade SDK con Muse-Glimmer 30B e modulo sperimentale ROCm per generazione immagini. Più che una novità di benchmark, è un segnale per chi valuta LLM locali: il valore si sposta su ottimizzazione di CPU, GPU e NPU, prevedibilità dei costi e controllo dei dati. La release estende i carichi supportati su hardware AMD e abbassa la soglia per deployment self-hosted, pur lasciando aperti integrazione, driver e aggiornamenti.

2026-08-15 📰 Fonte
Doom dentro un LLM: il checkpoint che sposta il vincolo dal software alla VRAM
📁 OnPremise AI generated ℹ️ LocalLLaMA

Doom dentro un LLM: il checkpoint che sposta il vincolo dal software alla VRAM

L'esperimento di physicsrob compila l'algoritmo di rendering di Doom nei pesi di un trasformatore Phi-3. Nessun addestramento: ogni peso è calcolato. Il risultato è deterministico e verificabile, ma restano 34–86 GB in fp32, nessuna quantization e inferenze nell'ordine dei 40 minuti per frame su GPU B200. Per AI-Radar il segnale è soprattutto infrastrutturale: il checkpoint è auditabile, ma il requisito di VRAM ne limita il deployment on-premise reale.

2026-08-14 📰 Fonte
RTX PRO 6000 a 16.000 dollari: il calcolo on-premise non è più scontato
📁 Hardware AI generated ℹ️ LocalLLaMA

RTX PRO 6000 a 16.000 dollari: il calcolo on-premise non è più scontato

Il raddoppio del prezzo di listino della RTX PRO 6000 Blackwell, da meno di 8.000 a 16.000 dollari, segnala una domanda enterprise anelastica e un potere di prezzo che ridisegna i calcoli TCO per l'on-premise. La scheda da 96 GB di VRAM diventa un filtro: cloud, sovranità dei dati e accesso degli sviluppatori cambiano. Servono scenari, non budget basati sui vecchi listini.

2026-08-13 📰 Fonte
L'archivio batte la generazione: il segnale di LLM Agents Factory per l'inference on-premise
📁 Frameworks AI generated 🏆 ArXiv cs.CL

L'archivio batte la generazione: il segnale di LLM Agents Factory per l'inference on-premise

LLM Agents Factory offre una via pragmatica alla gestione degli agenti: invece di generarli a ogni richiesta, li recupera da un archivio strutturato. Questo riduce i costi di inference, la latenza e la pressione sulle GPU, con implicazioni dirette per chi sviluppa e mantiene stack on-premise. La stabilità e la prevedibilità dei profili agentivi diventano un vantaggio strategico, aprendo scenari di mercato per componenti standardizzati.

2026-08-12 📰 Fonte
200 dollari bastano per addestrare un LLM da 1B: la sovranità dei dati smette di essere un lusso
📁 LLM AI generated ℹ️ LocalLLaMA

200 dollari bastano per addestrare un LLM da 1B: la sovranità dei dati smette di essere un lusso

Un esperimento dimostra che con 200 dollari su GPU noleggiate si può addestrare un LLM da 1,1 miliardi di parametri e distribuirlo su CPU o persino smartwatch. Il costo irrisorio riscrive il calcolo del TCO per le aziende che valutano soluzioni self-hosted: la sovranità dei dati diventa una scelta progettuale concreta, non un lusso per pochi. Restano limiti di qualità e contesto, ma la commoditizzazione del training sposta il valore dalla potenza bruta alla capacità di orchestrare pipeline e deployment.

2026-08-11 📰 Fonte
DeepSeek genera il kernel che mancava: il Mac Studio come laboratorio di inference autonoma
📁 OnPremise AI generated ℹ️ LocalLLaMA

DeepSeek genera il kernel che mancava: il Mac Studio come laboratorio di inference autonoma

Un utente ha fatto generare a DeepSeek un kernel Metal per eseguire Kimi K2 quantizzato su Mac Studio, ottenendo modeste prestazioni ma dimostrando che gli LLM possono colmare lacune software per l’inference self-hosted su hardware non-Nvidia. Il caso ridefinisce il calcolo del TCO a favore dell’hardware esistente e solleva interrogativi sulla robustezza del codice autogenerato. È un segnale di autonomia computazionale che si autoalimenta, con rischi e opportunità per le aziende che puntano all’on-premise.

2026-08-09 📰 Fonte
Intel Battlemage e llama.cpp: una patch riscrive il TCO dell'inference on-premise
📁 Hardware AI generated ℹ️ LocalLLaMA

Intel Battlemage e llama.cpp: una patch riscrive il TCO dell'inference on-premise

Una manciata di righe di codice in llama.cpp moltiplica fino a 2,7 volte le prestazioni delle GPU Intel Battlemage su contesti di 118.000 token quando la cache KV è quantizzata. Il guadagno è talmente netto da trasformare una scheda da gaming in un’alternativa concreta per l’inference locale di modelli da 35 miliardi di parametri, abbattendo il costo totale di possesso e aprendo scenari inediti per chi gestisce dati sensibili on-premise.

2026-08-08 📰 Fonte
Stack vocale NVIDIA in locale: implicazioni per l'AI on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

Stack vocale NVIDIA in locale: implicazioni per l'AI on-premise

L'analisi esamina come il rilascio dello stack vocale NVIDIA (ASR, TTS, codec) ottimizzato per esecuzione locale tramite GGUF e NeMo-Speech.cpp ridefinisca il calcolo del TCO, la sovranità dei dati e le architetture on-premise. Il passaggio dal cloud al device sposta gli equilibri nel make-or-buy dei servizi vocali, abilita scenari regolamentati e prepara il terreno per agenti multimodali completamente locali.

2026-08-07 📰 Fonte
Quando il compositor diventa un alleato dell’AI locale: l’architettura di Denial e il nuovo ruolo delle UI on-premise
📁 OnPremise AI generated ✅ Phoronix

Quando il compositor diventa un alleato dell’AI locale: l’architettura di Denial e il nuovo ruolo delle UI on-premise

Denial integra Flutter direttamente in un compositor Rust per Wayland, riducendo latenza, carico di memoria e strati software. Per i carichi di lavoro on-premise che affiancano LLM self-hosted su dispositivi edge, questa co-ubicazione non è solo una curiosità ingegneristica, ma un segnale di come l’infrastruttura locale stia ripensando anche l’ultimo miglio dell’interfaccia utente, con ricadute concrete su TCO, sicurezza e sovranità dei dati.

2026-08-06 📰 Fonte
Maple-Preview e l’inference ternaria: la soglia on-premise si abbassa
📁 OnPremise AI generated ℹ️ LocalLLaMA

Maple-Preview e l’inference ternaria: la soglia on-premise si abbassa

Maple-Preview porta i pesi ternari su 20 miliardi di parametri, occupando solo 5 GB e attivando 1 miliardo di parametri per token con un design MoE-like. La preview apre a inference locale su GPU consumer, ma il supporto dei framework è ancora acerbo. AI-Radar analizza le implicazioni per il TCO, la sovranità dei dati e il deployment self-hosted, mettendo in guardia sul gap software e sui vincoli dei kernel ternari.

2026-08-05 📰 Fonte
RTX 5090 oltre 5.100 dollari: quanto costa davvero l’AI on-premise
📁 OnPremise AI generated ℹ️ Tom's Hardware

RTX 5090 oltre 5.100 dollari: quanto costa davvero l’AI on-premise

I prezzi della RTX 5090 salgono alle stelle e rimettono in discussione la sostenibilità del deployment on-premise. L’analisi di AI-RADAR esplora le ripercussioni sul TCO, la sovranità dei dati e l’intera catena di approvvigionamento, mostrando come l’aumento dei costi dell’hardware stia spingendo verso quantization aggressiva, modelli distilati e un possibile ritorno al cloud, con vincitori e vinti lungo il percorso.

2026-08-04 📰 Fonte
LLM per il preprocessing dei dati: perché l’on-premise diventa inevitabile
📁 OnPremise AI generated 🏆 ArXiv cs.CL

LLM per il preprocessing dei dati: perché l’on-premise diventa inevitabile

Una ricerca su GMM e LLM per il clustering su dati sbilanciati mostra che la generazione di documenti sintetici non è più solo per l’addestramento nel cloud. Quando i dati sono sensibili (sanità, finanza, legale), l’augmentation deve restare on-premise, spingendo la domanda di GPU locali per task batch e ridefinendo i confini tra modelli applicativi e pipeline del dato. Per i decisori, si aprono nuovi trade-off su TCO, sovranità e hardware.

2026-08-03 📰 Fonte
Quando il desktop plasma la GPU: Plasma 6.8 e il compositing multi-GPU riavvicinano interfaccia e AI locale
📁 OnPremise AI generated ✅ Phoronix

Quando il desktop plasma la GPU: Plasma 6.8 e il compositing multi-GPU riavvicinano interfaccia e AI locale

Le ottimizzazioni di KWin sulla gestione di più GPU in KDE Plasma 6.8 non sono una semplice miglioria grafica: abbattono la frizione tra rendering desktop e carichi di inference locali, rendendo le workstation Linux un ambiente più efficiente e diretto per chi sviluppa LLM on-premise. Il segnale è la convergenza tra il layer di interazione umana e l’infrastruttura di calcolo, con benefici concreti su TCO, latenza e utilizzo della VRAM.

2026-08-02 📰 Fonte
Unsloth porta Deepseek V4 in locale: il segnale che mancava per l’AI on-premise
📁 OnPremise AI generated ℹ️ LocalLLaMA

Unsloth porta Deepseek V4 in locale: il segnale che mancava per l’AI on-premise

Unsloth ha rilasciato i file GGUF per Deepseek V4, abilitando l’inference self-hosted su hardware consumer via llama.cpp e Ollama. La mossa ribalta il calcolo del TCO e la sovranità dei dati: l’AI on-premise diventa una scelta di design. AI-Radar analizza le implicazioni di sistema, dalla riduzione dei vincoli hardware alla frammentazione del cloud e i segnali per chi costruisce infrastrutture locali.

2026-08-01 📰 Fonte
Inkling-Small porta il contesto da 1 milione di token sulle GPU locali, ma il vero collo di bottiglia resta la memoria
📁 LLM AI generated ℹ️ LocalLLaMA

Inkling-Small porta il contesto da 1 milione di token sulle GPU locali, ma il vero collo di bottiglia resta la memoria

thinkingmachines ha rilasciato Inkling-Small, un LLM a mistura di esperti con 276 miliardi di parametri e soli 12 miliardi attivi, finestra di contesto da 1 milione di token e quantizzazioni NVFP4 e GGUF. L'analisi AI-RADAR mette a fuoco il nodo nascosto della KV cache e le implicazioni per deployment on-premise, TCO e sovranità dei dati.

2026-07-31 📰 Fonte
La fabbrica AI senza CUDA di AMD-Anthropic: cosa cambia per chi fa on-premise
📁 OnPremise AI generated ✅ DigiTimes

La fabbrica AI senza CUDA di AMD-Anthropic: cosa cambia per chi fa on-premise

AMD e Anthropic stanno costruendo una fabbrica AI su larga scala che rinuncia a CUDA. L’ecosistema ROCm diventa un’alternativa concreta per l’inference e il fine-tuning di modelli multi-trilione di parametri. Per le aziende che puntano al self-hosted degli LLM, questa mossa introduce un secondo fornitore credibile, riducendo la dipendenza da NVIDIA e potenzialmente il TCO. L’analisi approfondisce l’impatto su hardware, software, ricerca e strategie di deployment on-premise.

2026-07-30 📰 Fonte
Il pivot cinese sull’open source: un laboratorio per la sovranità on-premise
📁 OnPremise AI generated ✅ DigiTimes

Il pivot cinese sull’open source: un laboratorio per la sovranità on-premise

La virata della Cina verso ecosistemi open source per l’AI generativa è più di una scelta tecnica: è un adattamento forzato dai vincoli hardware e dalle dottrine di sicurezza, che trasforma il paese in un banco di prova avanzato per il deployment on-premise di LLM. L’analisi esplora perché questo passaggio ridisegna gli equilibri dell’infrastruttura AI globale e quali segnali offre a chi cerca sovranità sui dati e controllo del TCO.

2026-07-29 📰 Fonte
← Precedente Page 2 / 3 Successiva →
Vedi Archivio Completo 🗄️

AI-Radar is an independent observatory covering AI models, local LLMs, on-premise deployments, hardware, and emerging trends. We provide daily analysis and editorial coverage for developers, engineers, and organizations exploring local AI solutions.

AI-RADAR badge LaunchTry LAUNCHING SOON ON LaunchTry Fazier badge