Google ha annunciato Gemini 4 Argon, un modello di frontiera che riporta l'azienda nella competizione sui modelli di fascia alta dopo un'estate dedicata alle versioni Flash più leggere. La promessa è chiara: prestazioni di primo livello in coding, knowledge work e cybersecurity. Ma c'è un dettaglio che cambia la lettura della notizia: Argon non è ancora accessibile all'esterno. I tecnici di Google lo usano già in carichi reali, e i risultati interni raccontano una storia diversa da quella di un semplice lancio commerciale.
Secondo quanto riportato, Argon avrebbe sfruttato la telemetria dell'intera flotta per far risparmiare a Google 300 TiB di memoria nei data center. Gli agenti basati su Argon stanno inoltre migrando codebase C/C++ a Rust in tutta l'azienda: migliaia di righe nelle librerie re2 e libgav1, e più di 800.000 righe nel kernel Zircon di Fuchsia OS. Non si tratta di una demo: è un intervento su infrastruttura e sistemi operativi in produzione.
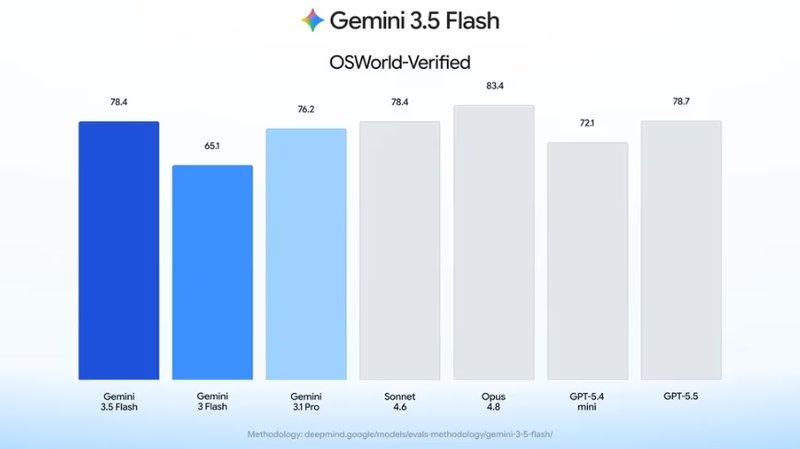
Sul fronte benchmark, Google porta DeepSWE v1.1 con il 77,9 per cento, superiore a GPT-6 Astra, Fable 5.1 e Opus 5.5. L'azienda rivendica risultati simili in task di lungo respiro e un punteggio di vertice nel Vals Index per l'analisi economica. Ma il punto non è solo la classifica.
La posta in gioco è asimmetrica. Google sta usando Argon per ottimizzare il proprio parco macchine e per migrare codice critico prima di concederlo ai clienti. Questo le dà un doppio vantaggio: riduce i costi operativi interni e accumula evidenze concrete sull'affidabilità del modello in contesti produttivi. Chi attende l'accesso pubblico, invece, si trova davanti a un benchmark senza possibilità di verifica indipendente. Il caso DeepSWE e la migrazione a Rust mostrano che i modelli di frontiera stanno diventando strumenti di gestione dell'infrastruttura, non solo assistenti per sviluppatori. La telemetria di flotta è un asset che pochi possono replicare: un'azienda con una flotta più piccola potrebbe ottenere risparmi di memoria inferiori o richiedere un tuning più mirato.
Per chi valuta deployment on-premise, il caso Argon solleva una questione concreta: workload come la migrazione di codebase legacy e l'ottimizzazione della memoria sono candidati naturali per un LLM self-hosted, ma dipendono fortemente dall'accesso ai dati operativi e dalla scala dell'infrastruttura. AI-RADAR raccoglie framework analitici su /llm-onpremise per chi deve valutare questi trade-off. Nel frattempo, resta il paradosso: il modello più promettente di Google è già al lavoro, ma il pubblico può solo leggerne i risultati.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!