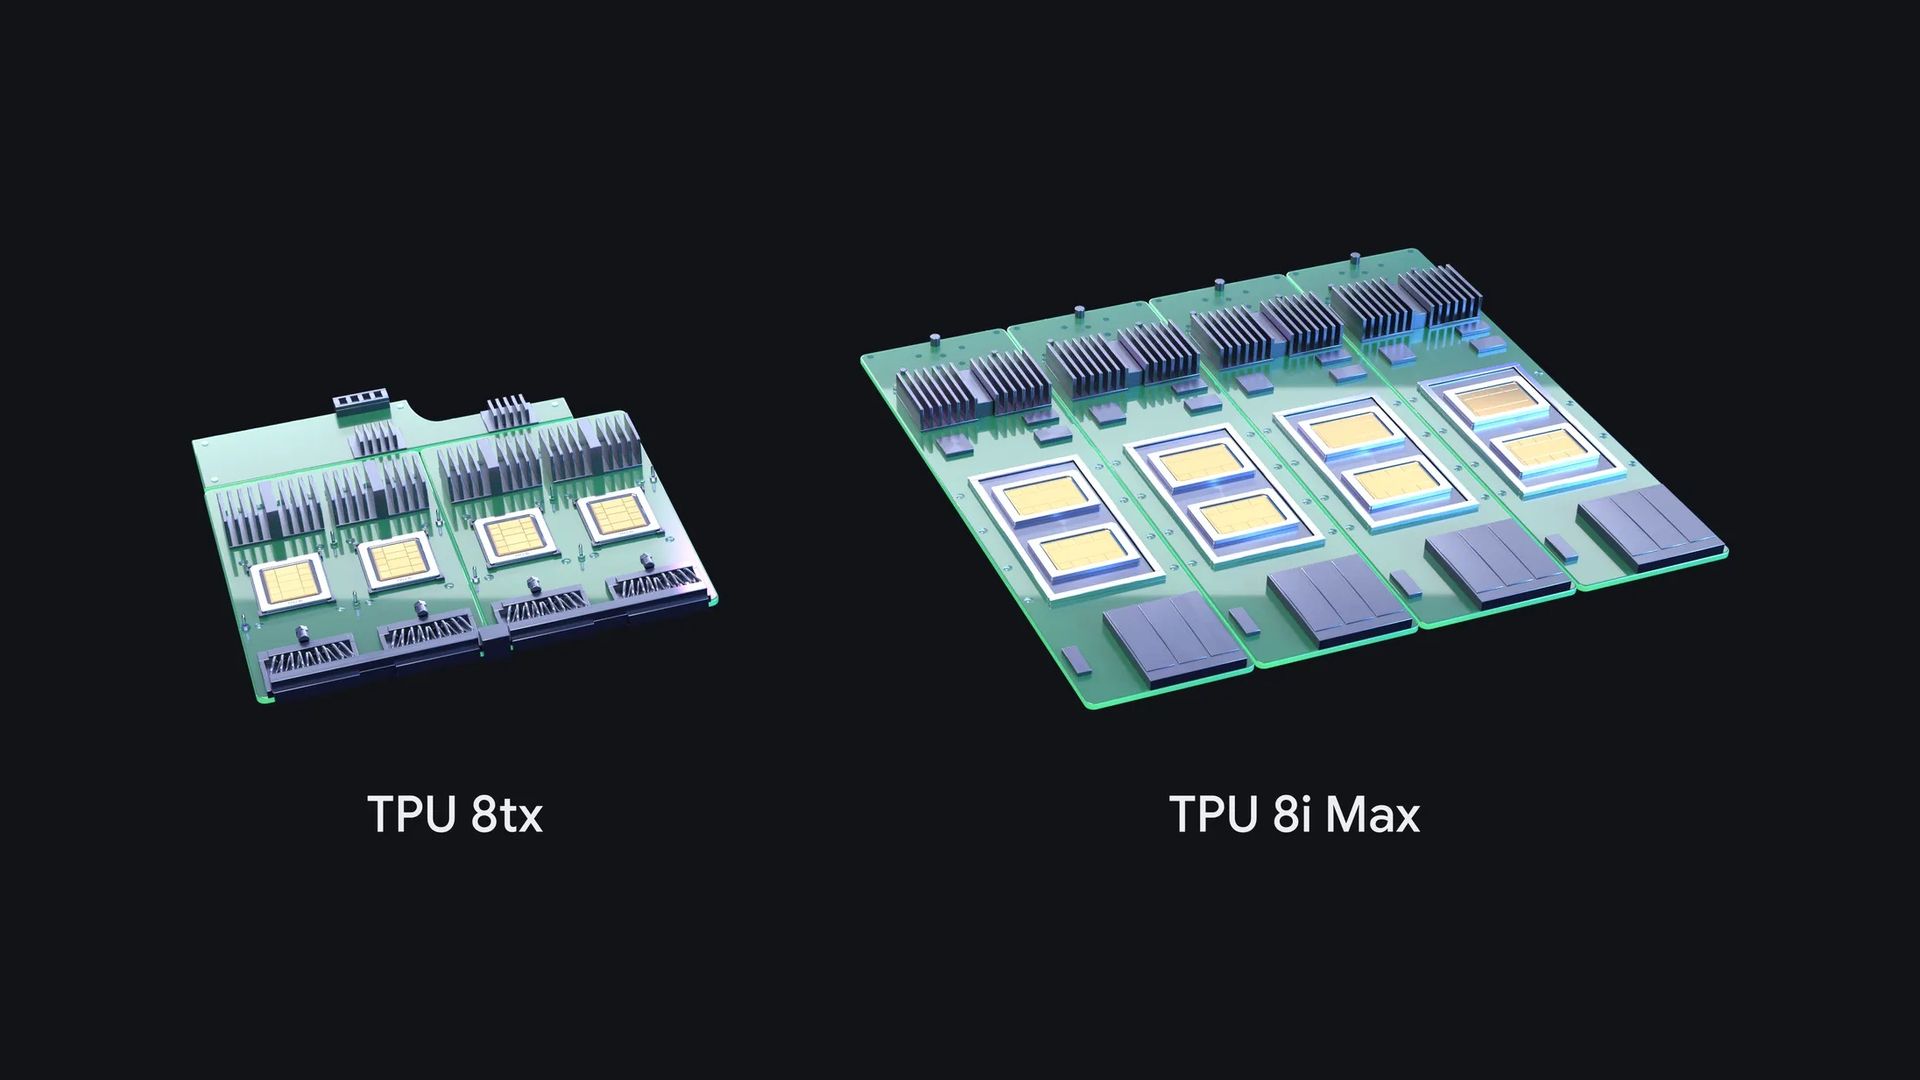
Quando un produttore di silicio decide di rielaborare i propri acceleratori in sistemi specializzati, non sta facendo un semplice refresh. Sta dicendo che il mercato non si accontenta più di un'unica architettura per training e inference. La notizia che Google stia riorientando i TPU verso due aree precise — agenti e sicurezza — va letta come una presa di posizione: la prossima fase dell'infrastruttura AI sarà dominata dalla specializzazione dei carichi di lavoro, non dalla sola potenza di calcolo.
Gli agenti autonomi, basati su LLM, hanno esigenze diverse dai modelli che rispondono a singole richieste. Devono mantenere contesto su orizzonti temporali lunghi, concatenare chiamate a strumenti esterni, gestire memoria e pianificazione. Un acceleratore pensato per massimizzare il throughput su batch omogenei può sprecare risorse quando il carico diventa irregolare e interattivo. La sicurezza, dal canto suo, richiede isolamento, attestazione e applicazione delle policy a bassa latenza: caratteristiche che spesso non emergono come priorità in un design general-purpose. Rielaborare il silicio per queste esigenze significa intervenire su gerarchie di memoria, scheduling e interconnessioni, non solo aumentare i FLOPS.
Il punto strutturale è che la specializzazione sposta il valore dall'hardware al software e al controllo della piattaforma. Chi possiede il silicio e il framework di orchestrazione può ottimizzare l'intero stack, ma rende anche più difficile per i clienti separare i componenti. Per un'azienda che valuta deployment on-premise o ibridi, questo solleva un interrogativo concreto: la specializzazione sarà disponibile anche fuori dai data center del vendor, o resterà un vantaggio esclusivo del cloud? La storia recente dell'infrastruttura AI mostra che le architetture proprietarie tendono a irrigidire le scelte di deployment, anche quando promettono efficienza.
Non è un caso che il tema della sicurezza compaia accanto agli agenti. Gli agenti autonomi agiscono su dati e sistemi aziendali; un errore di policy o una fuga di contesto ha conseguenze immediate. Chi progetta hardware dedicato alla sicurezza sta implicitamente riconoscendo che l'AI non è più solo un problema di prestazioni, ma di fiducia e confini. Questo rafforza la domanda di controlli locali, audit e isolamento dei dati, elementi che spesso spingono verso soluzioni self-hosted o ibride.
Per chi valuta questi trade-off, AI-RADAR offre framework analitici su /llm-onpremise per confrontare i vincoli di controllo, TCO e sovranità senza ridurre la scelta a una semplice questione di benchmark. La vera partita, nei prossimi mesi, sarà capire se la specializzazione dei TPU diventerà un mattone riutilizzabile anche fuori dall'ecosistema Google o resterà un'architettura chiusa. La risposta non determinerà solo il futuro dei data center, ma anche quali organizzazioni potranno davvero portare l'AI vicino ai propri dati. Il segnale è chiaro: l'hardware AI sta passando dalla corsa ai transistor alla corsa ai carichi di lavoro. E chi dovrà gestire agenti e sicurezza in casa propria avrà bisogno di risposte precise, non di promesse.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!