🏷️ Fine-Tuning
60 articoli con questo tag · tutti i tag

LLM
NVIDIA e il 4B BF16: il peso specifico dell'inference locale
2026-10-17

Hardware
ORL spinge i diffusion LLM a 2.788 token/s su una RTX 5090
2026-10-16
Hardware
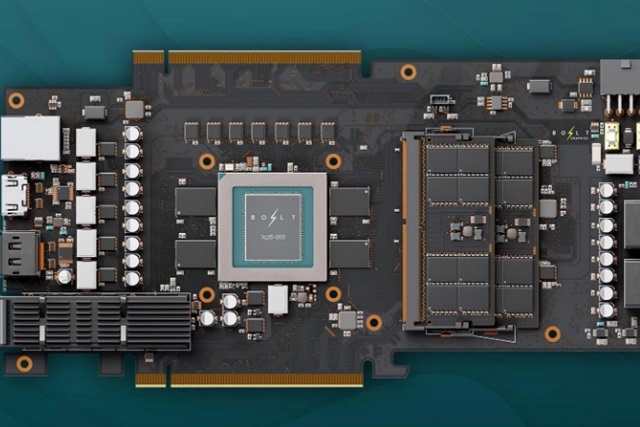
Bolt Graphics cerca 100 milioni di dollari per sfidare Nvidia e AMD con la GPU Zeus
2026-10-16

Frameworks
PRISM insegna ai sistemi multi-agente a scegliere la topologia giusta per ogni query
2026-10-16
Frameworks
DeepUnfolding Agent: il controllo adattivo diventa un servizio esterno
2026-10-16

LLM
Meta apre i pesi di Muse Spark Open: 816B parametri e contesto da 1M token
2026-10-15

LLM
Nemotron 3.5 Bolt: un VLM da 74B compresso in 24 GB per l'on-premise
2026-10-15

LLM
Mr.Chatterbox-2.7B-Chat: un LLM addestrato da zero sui testi vittoriani
2026-10-15

LLM
Il bengalese smonta le certezze dei benchmark LLM in inglese
2026-10-15
OnPremise
Voice agent e recupero crediti: la conformità diventa una specifica
2026-10-15
LLM
Modello inverso: addestrare LLM al ragionamento senza CoT
2026-10-15

LLM
Lotus: prevedere il futuro per comprendere le serie temporali
2026-10-15
LLM
Open-weight cinesi a 7 mesi dai modelli USA: la trasparenza dei dati conta più del gap
2026-10-14
Altro
Apple studia come trasformare i Mac inattivi in una cloud GPU virtuale con 'Minions'
2026-10-14
LLM
51 lab offline per imparare l'AI dai neuroni agli agenti
2026-10-14
Hardware
Reverse engineering CUDA, la sfida ironica di un utente AMD
2026-10-13

Hardware
Intel Crescent Island diventa D-Series: fino a 480 GB di LPDDR5X
2026-10-12
Hardware
Da Crescent Island alla serie D: Intel punta sull’inference aziendale
2026-10-12
Hardware
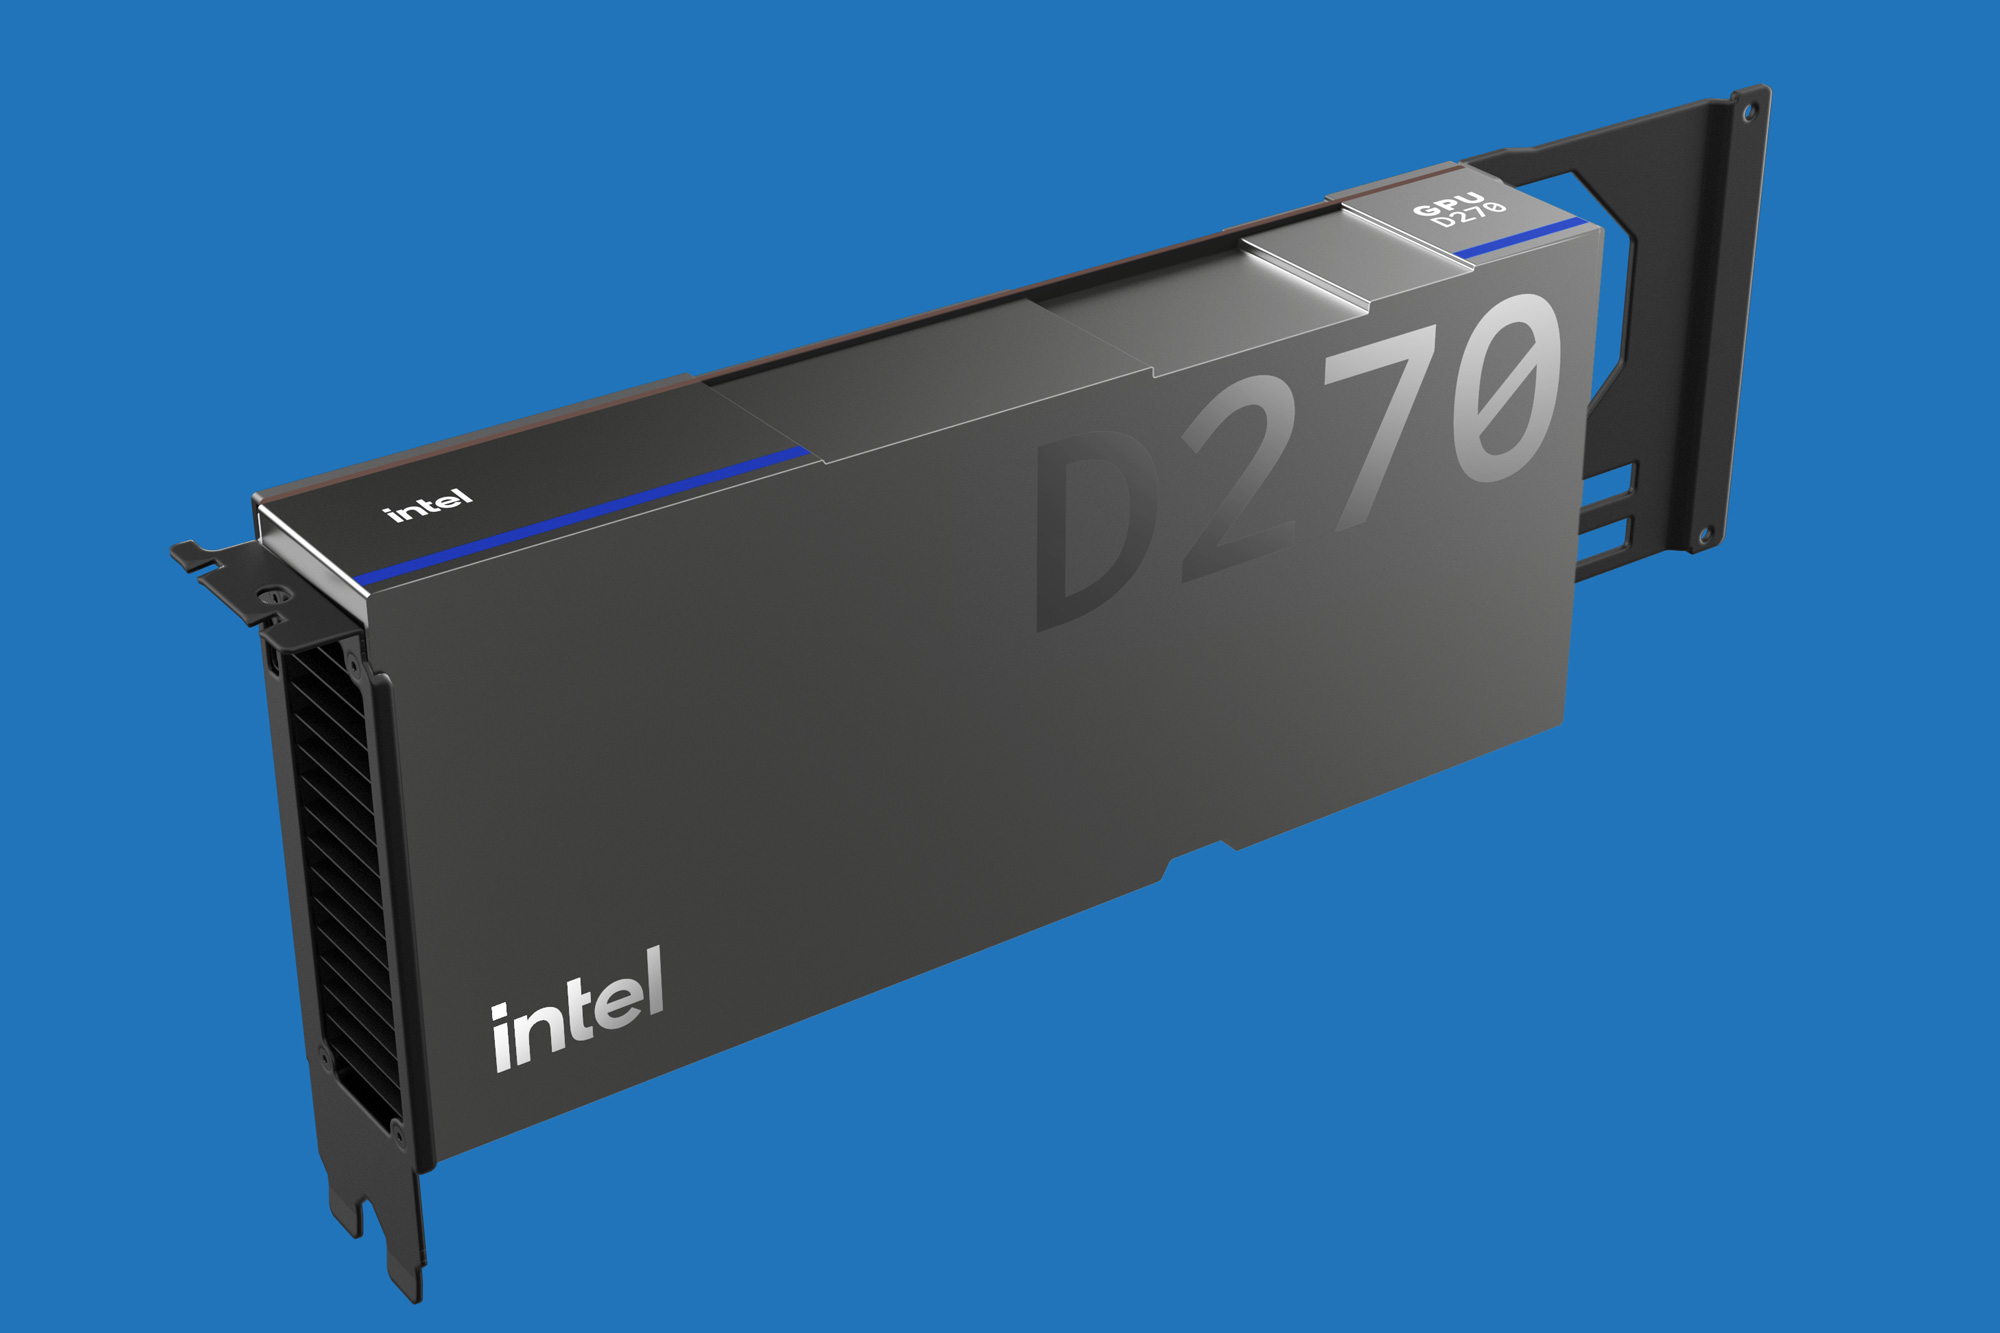
Intel D-Series: la D270 sceglie l’inference con FP8 e 1,5 TB/s
2026-10-12
LLM
MiniCPM-V 4.7: il primo MoE open source con inference fluida on-device
2026-10-12
Hardware
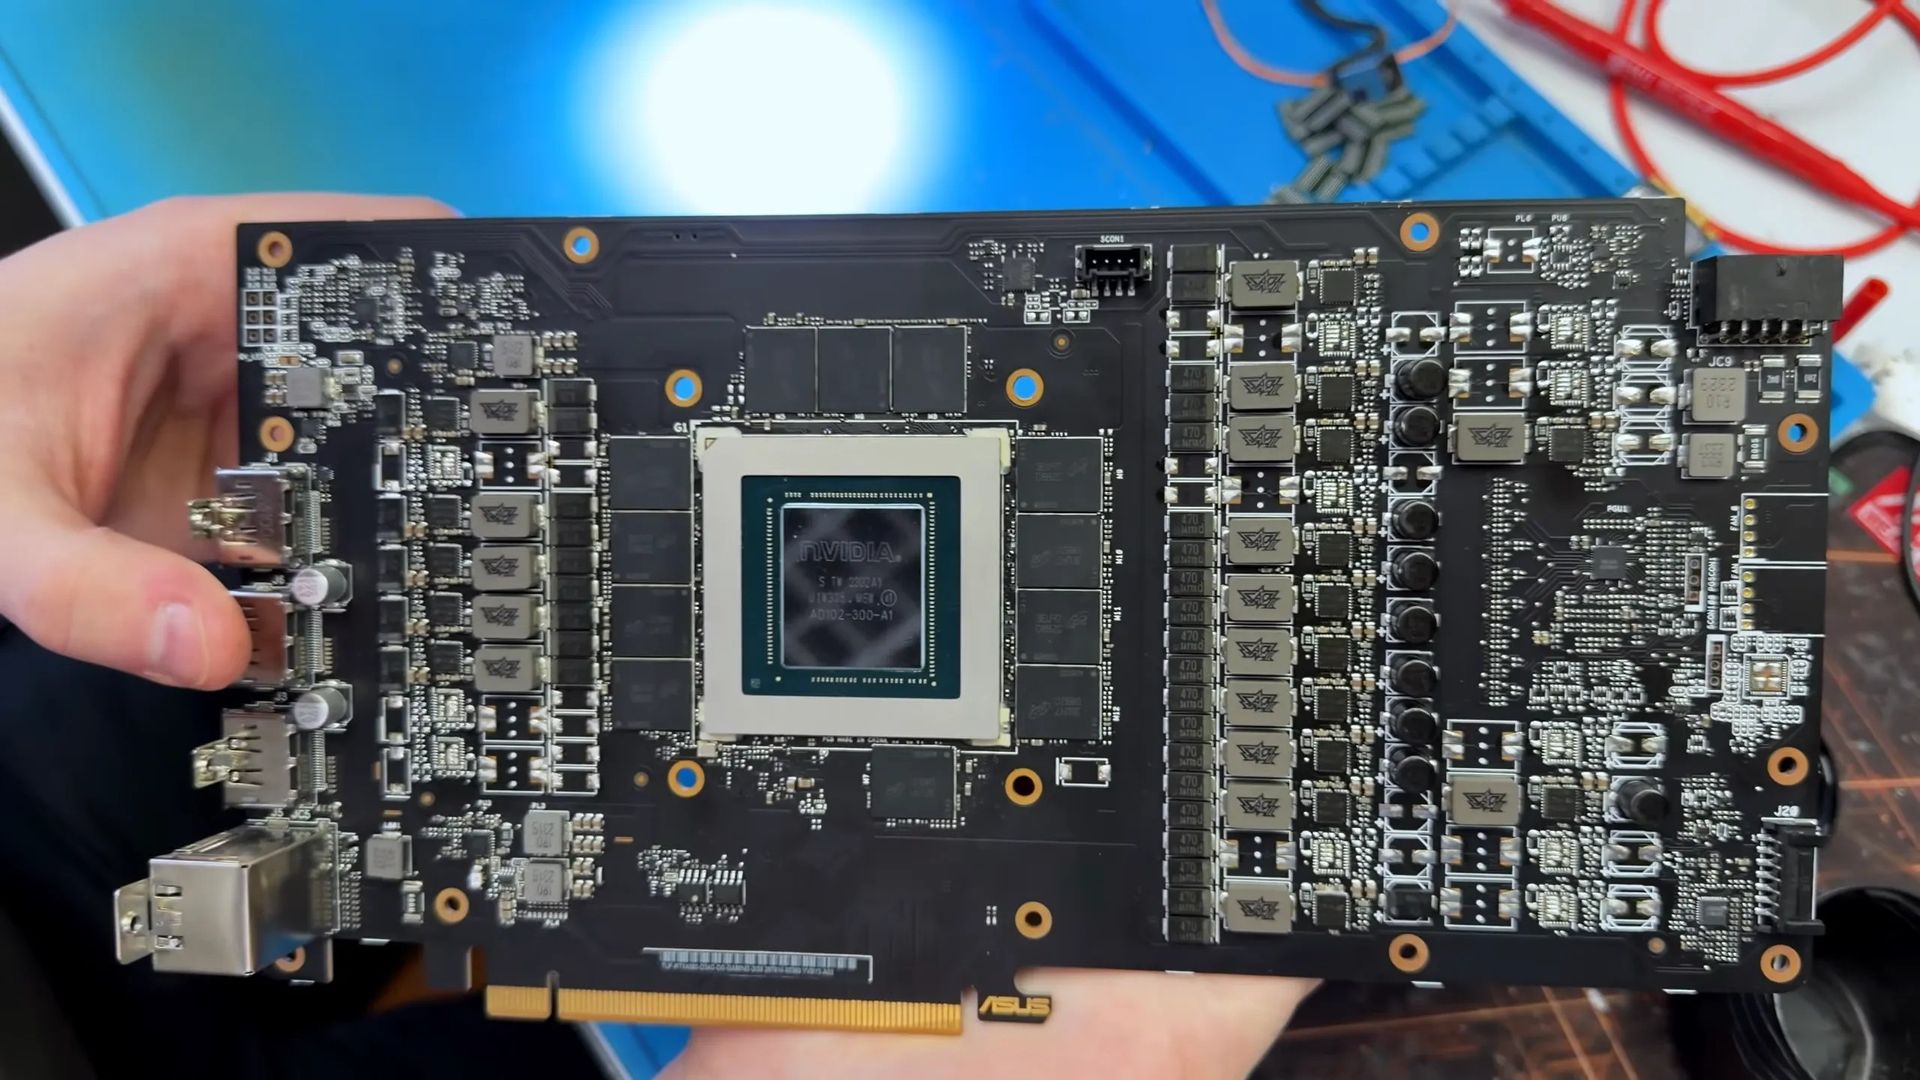
RTX 4090 'rotta' a 350 dollari: dentro una GPU falsa e memoria sostituita
2026-10-12
Altro
Strata: build from source e l'enigma della documentazione mancante
2026-10-12
Altro
La scansione scontrini diventa on-device: un modello 0,8B sul telefono
2026-10-12
LLM
AutoIndexer: quando il modello riscrive il proprio output come in un editor
2026-10-12
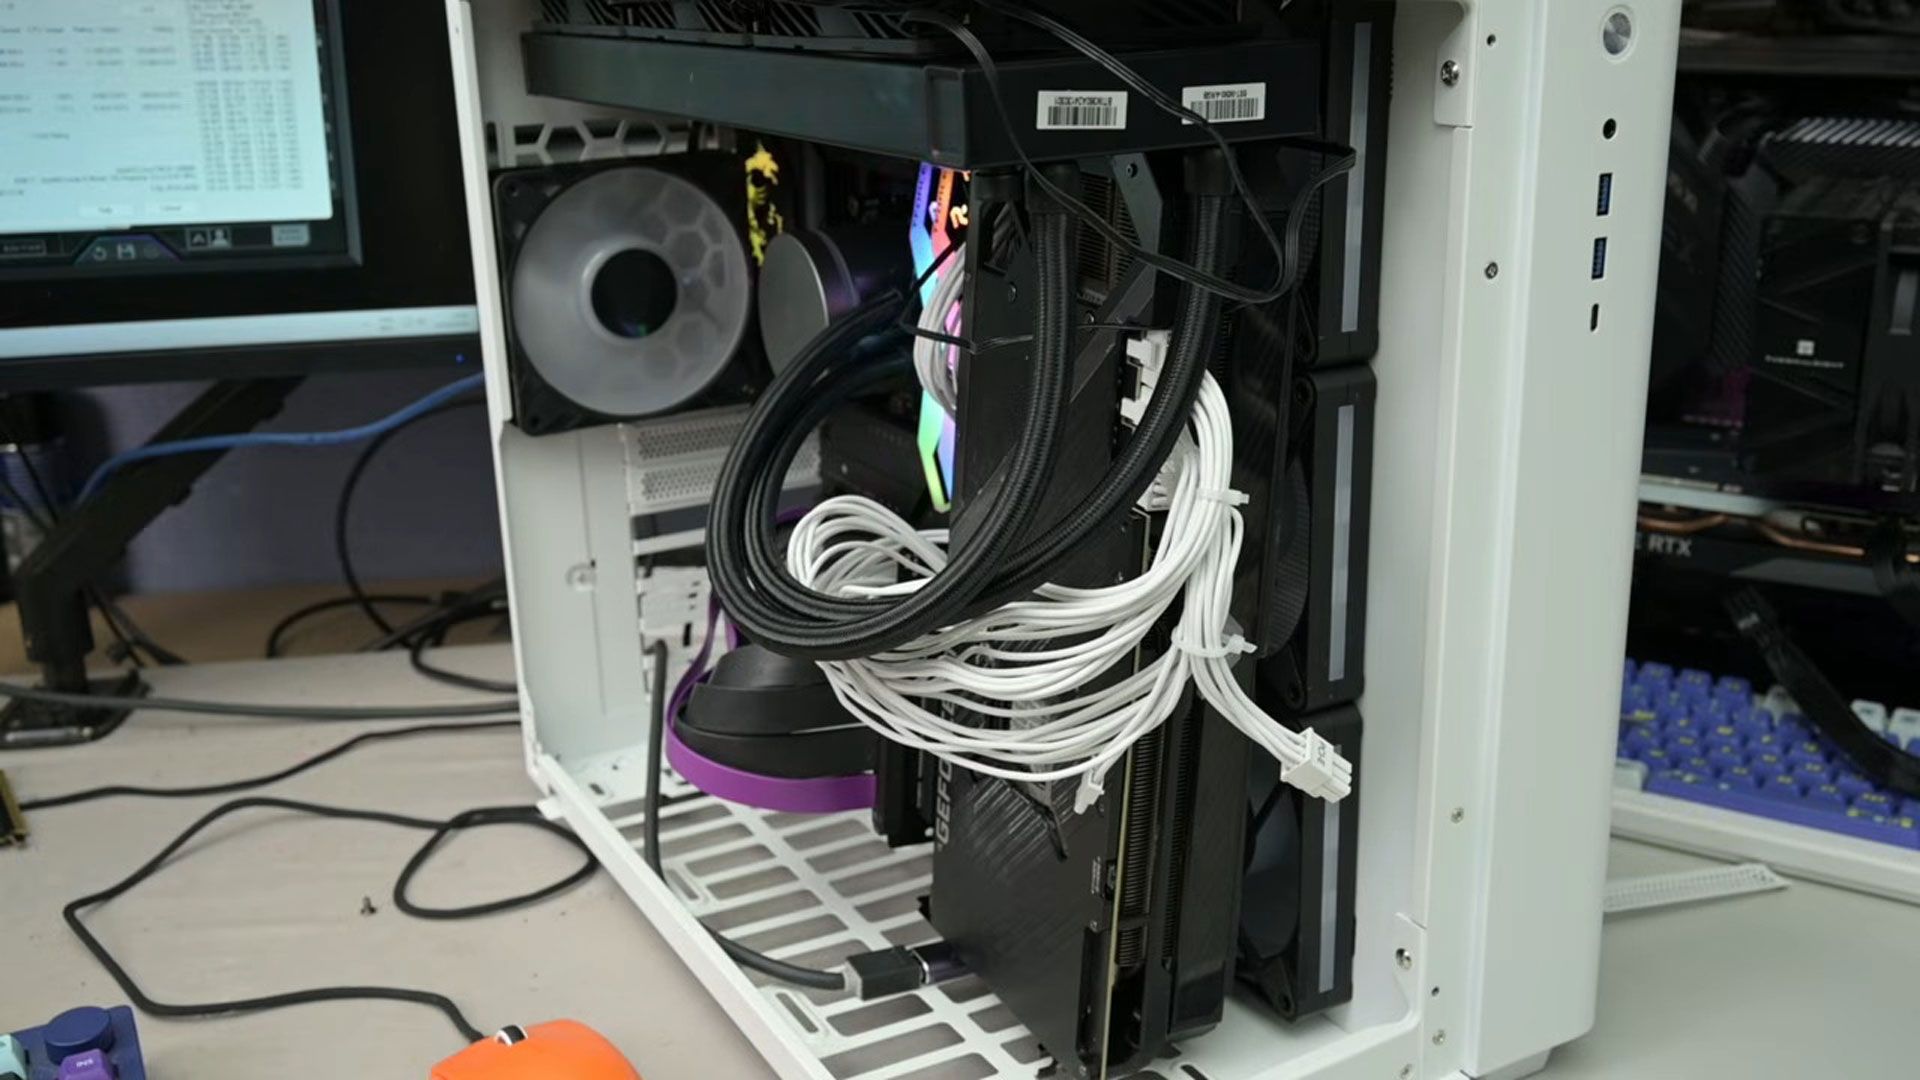
Hardware
Una GPU nel posto sbagliato? Hotspot più freddo di 19 gradi
2026-10-11

Hardware
RTX 4090 contraffatte: il rischio nascosto per l'inference on-premise
2026-10-11
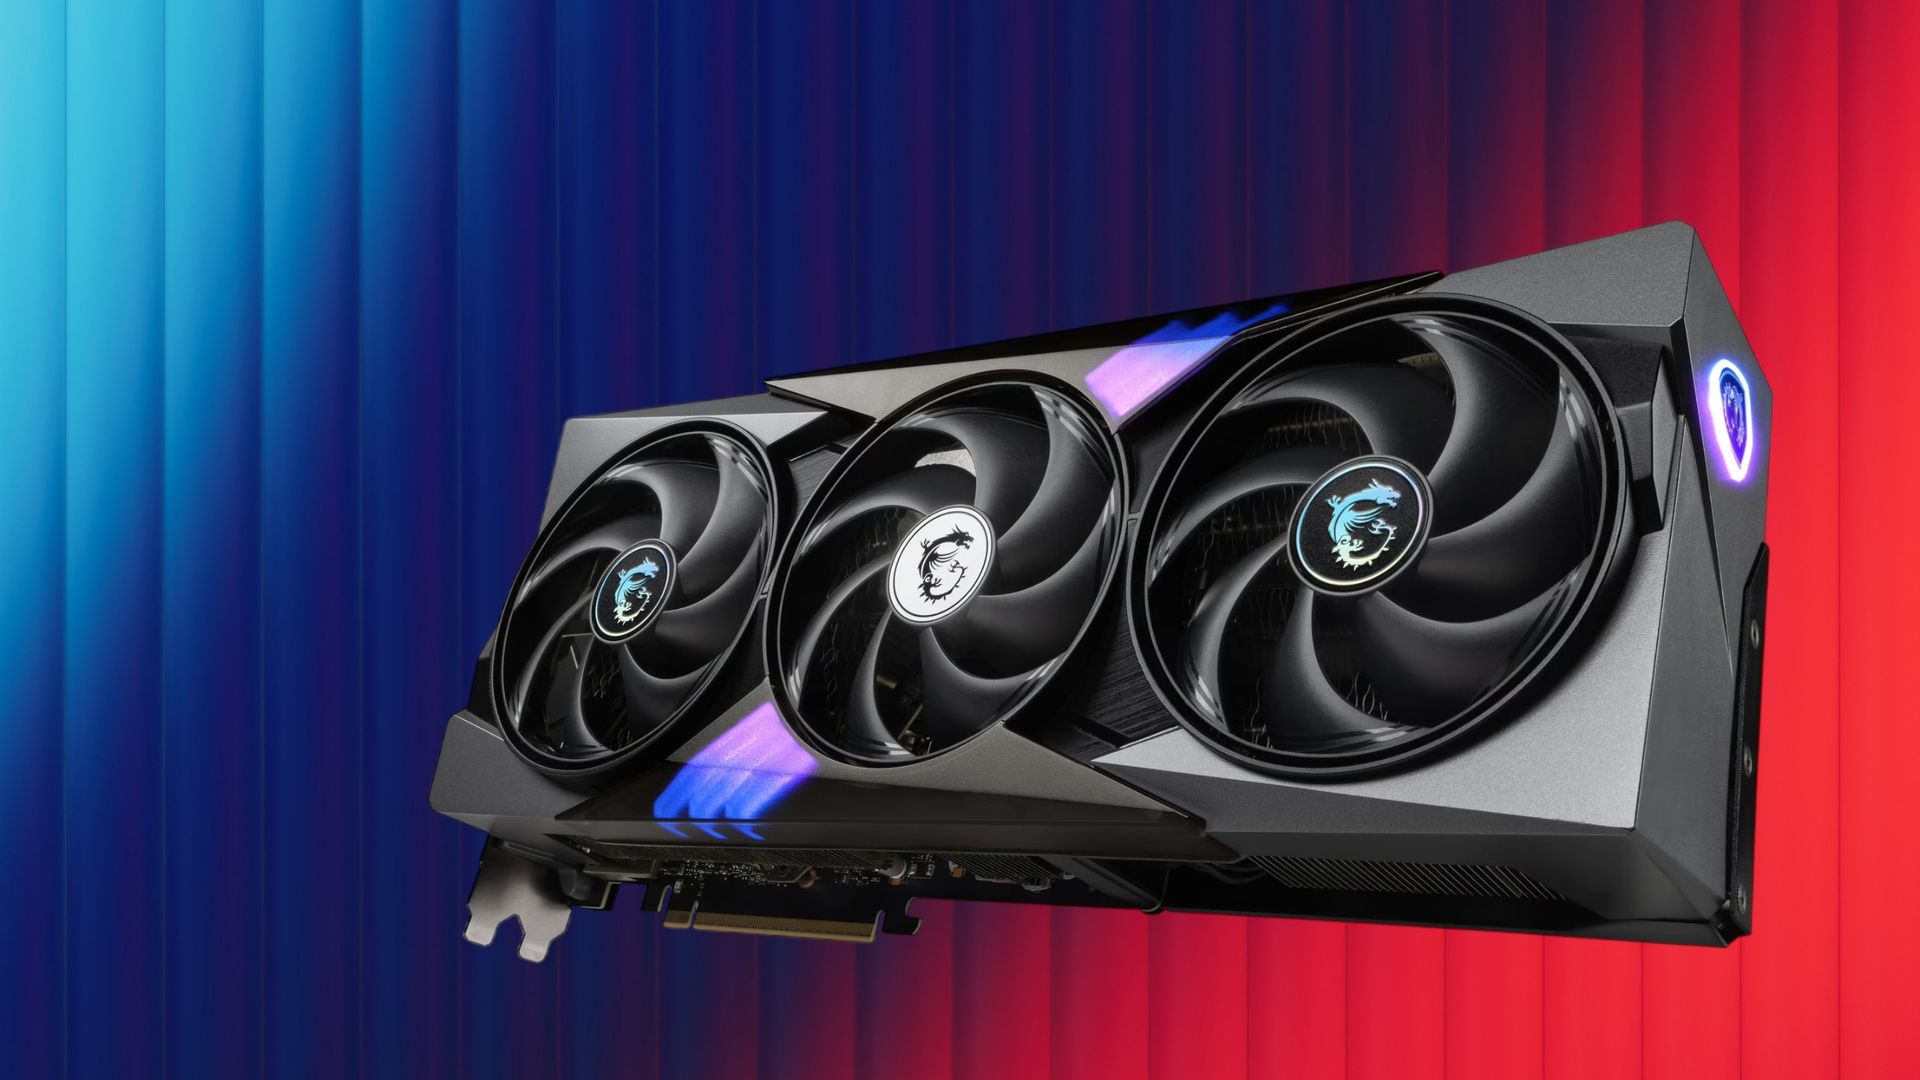
Hardware
Nvidia fermerebbe la RTX 5090 per dare priorità alle GPU AI
2026-10-10
Altro
KNOD: il kernel Linux scarica il packet processing sulle GPU AMD
2026-10-10
LLM
Vega, il modello decisionale open-source da 800M parametri con 73k token
2026-10-10
LLM
GLM 5.3 Flash open source davanti a Claude: l'AI aperta avanza
2026-10-09
Altro
Diffu-LoRA: il fine-tuning che decide dove allocare i parametri
2026-10-09
LLM
Freeze del decoder, healing dell'encoder: il tranello del learning rate condiviso
2026-10-09
Frameworks
Synthesis Through Simulation: il framework SAP per dati enterprise senza schema
2026-10-09
Frameworks
Modelli decisionali su RTX 4090: vince il runtime, non solo la dimensione
2026-10-08
Altro
COSMIC Epoch 1.10 porta il rendering GPU nel launcher: il peso del local-first
2026-10-08
LLM
LittleBit e la corsa alla quantization ultra-low-bit per modelli minuscoli
2026-10-08
LLM
Hirundo rimuove l'allineamento CCP da Qwen: censura al 2,8%
2026-10-08
LLM
ASR per bambini: adattare il modello senza dimenticare gli adulti
2026-10-08
Altro
llama.cpp sul palco: il self-hosted cambia fase
2026-10-07

Frameworks
Agent Lightning 1.0: addestrare agenti con l’harness reale, in 3.500 righe
2026-10-07
LLM
Perché la guida esterna nei LLM non è sempre un vantaggio: la teoria bias-varianza di GA-GRPO
2026-10-07
Altro
TEMPEST: embedding angolari per l'identificazione scalabile dei conducenti
2026-10-07
Altro
Ubuntu 27.04 userà ntpd-rs di default: la sincronizzazione passa a Rust
2026-10-06
Altro
Outlook blocca i pacchetti .msix: Microsoft alza l'asticella della sicurezza email
2026-10-06
Hardware
Vulkan e driver RADV: Valve allunga la vita delle GPU AMD Polaris su Linux
2026-10-06
Altro
Vates ottiene 30 milioni da IRIS e Bpifrance per l'espansione globale
2026-10-06
Frameworks
ROCm 10.1: il ciclo di sei settimane diventa la vera notizia
2026-10-05
Frameworks
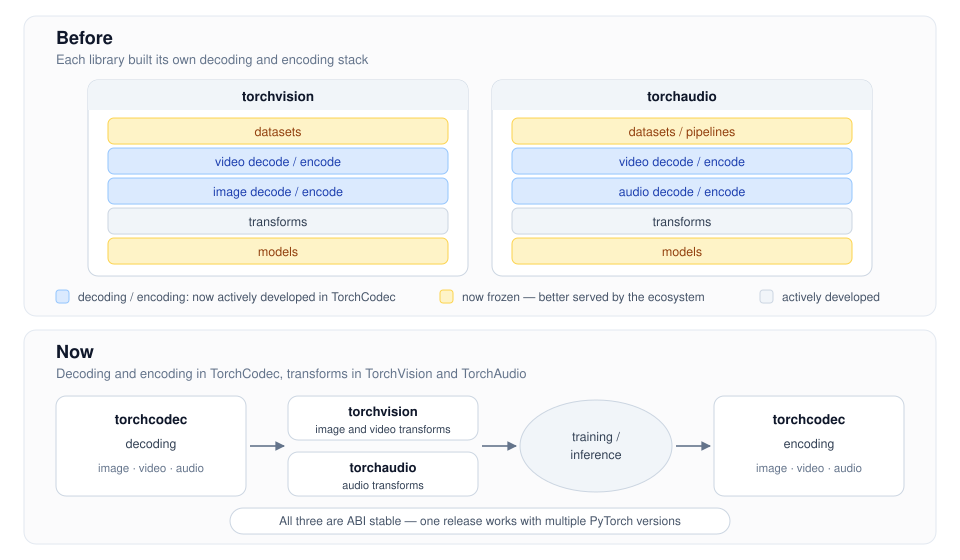
PyTorch mette ordine nello stack media: I/O in TorchCodec, il resto si specializza
2026-10-05
LLM
Agens Volundr 32B: architettura ibrida con KV cache solo su 18 dei 72 layer
2026-10-05
Frameworks
Raman e machine learning: il framework ibrido che identifica sei farmaci
2026-10-05
LLM
AliceAI-80B-A3B: il fine-tuning locale inciampa sui dati, non sulle V100
2026-10-04
LLM
Apex-2: un MoE da 3,87B addestrato da zero con 86,5 miliardi di token
2026-10-04
Hardware
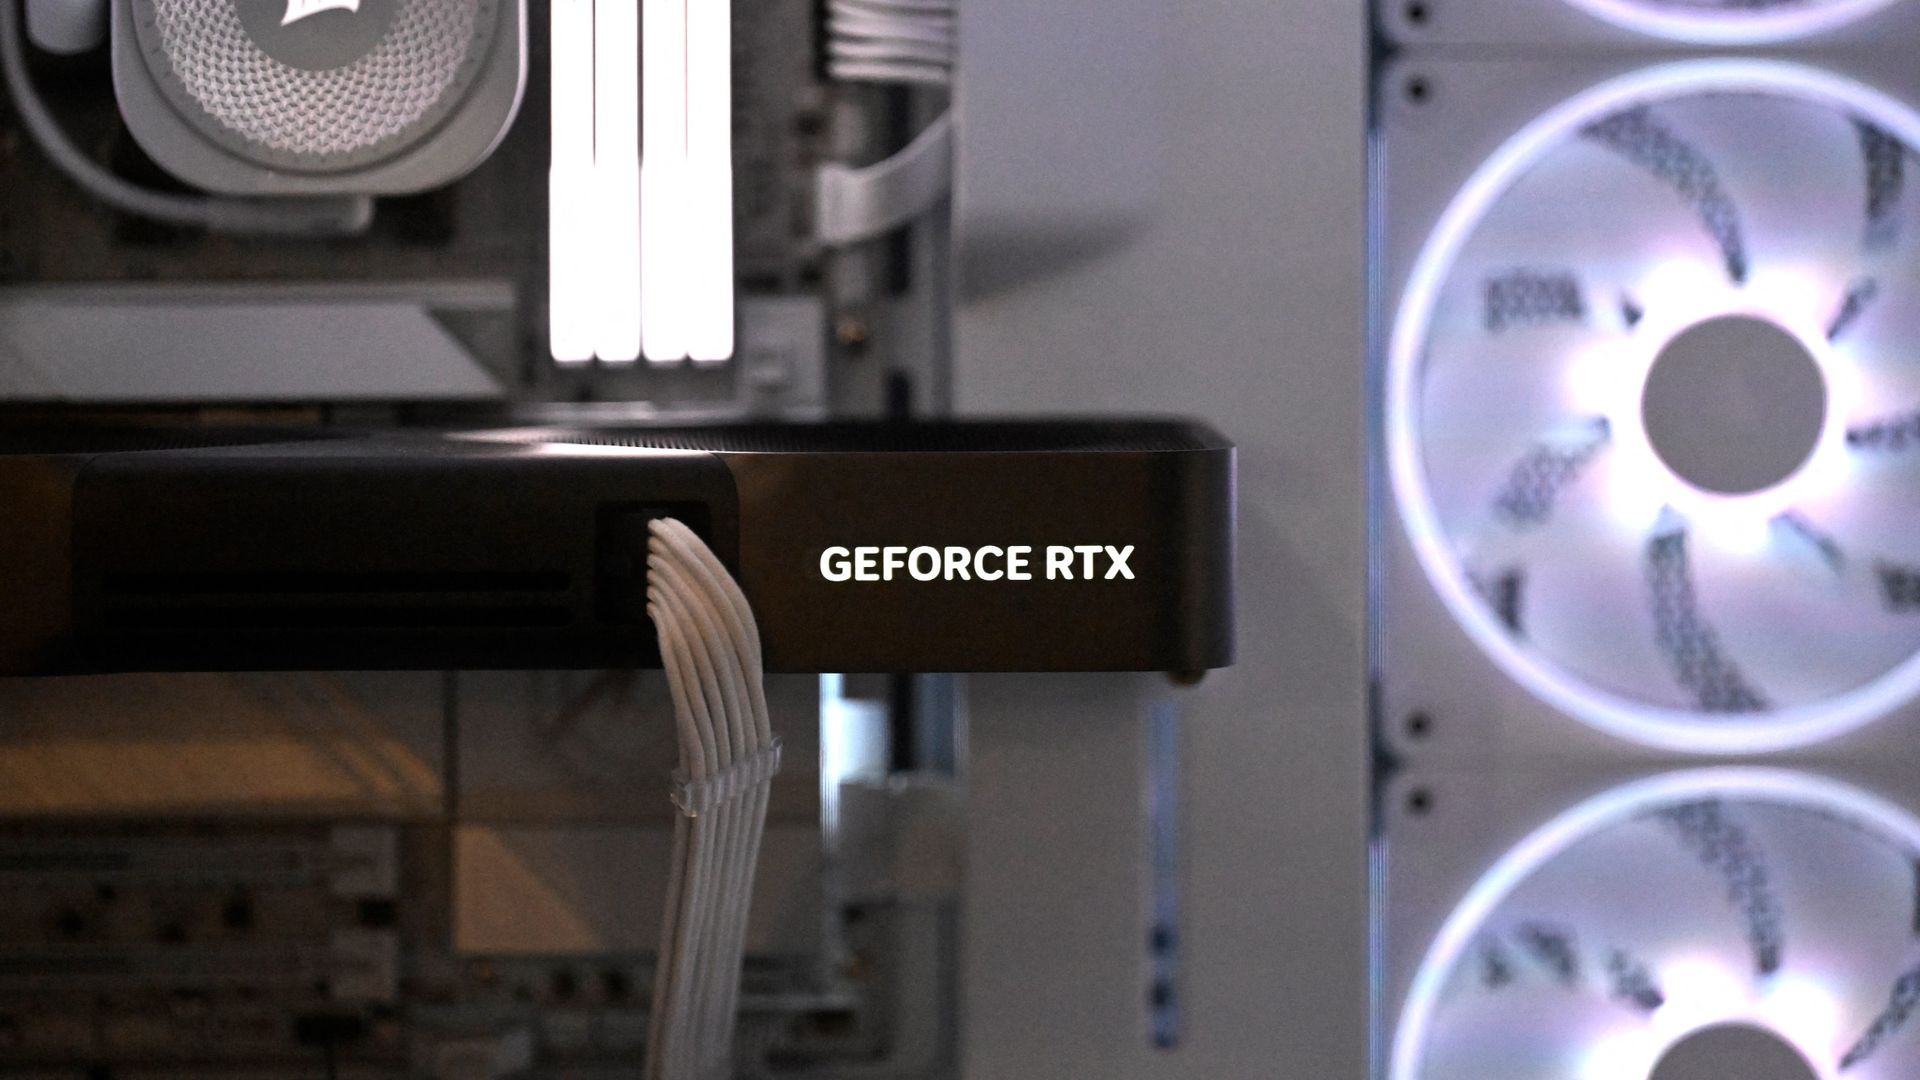
RTX 5090, il connettore che fonde e la soluzione custom di un modder
2026-10-04
Hardware
AMD porta su Linux 7.4 nuovi blocchi IP GPU e una raffica di bug fix
2026-10-04
LLM
Aleph Alpha porta Kolibri-1: 78B totali, 3,46B attivi, contesto da 1M token
2026-10-03
Hardware
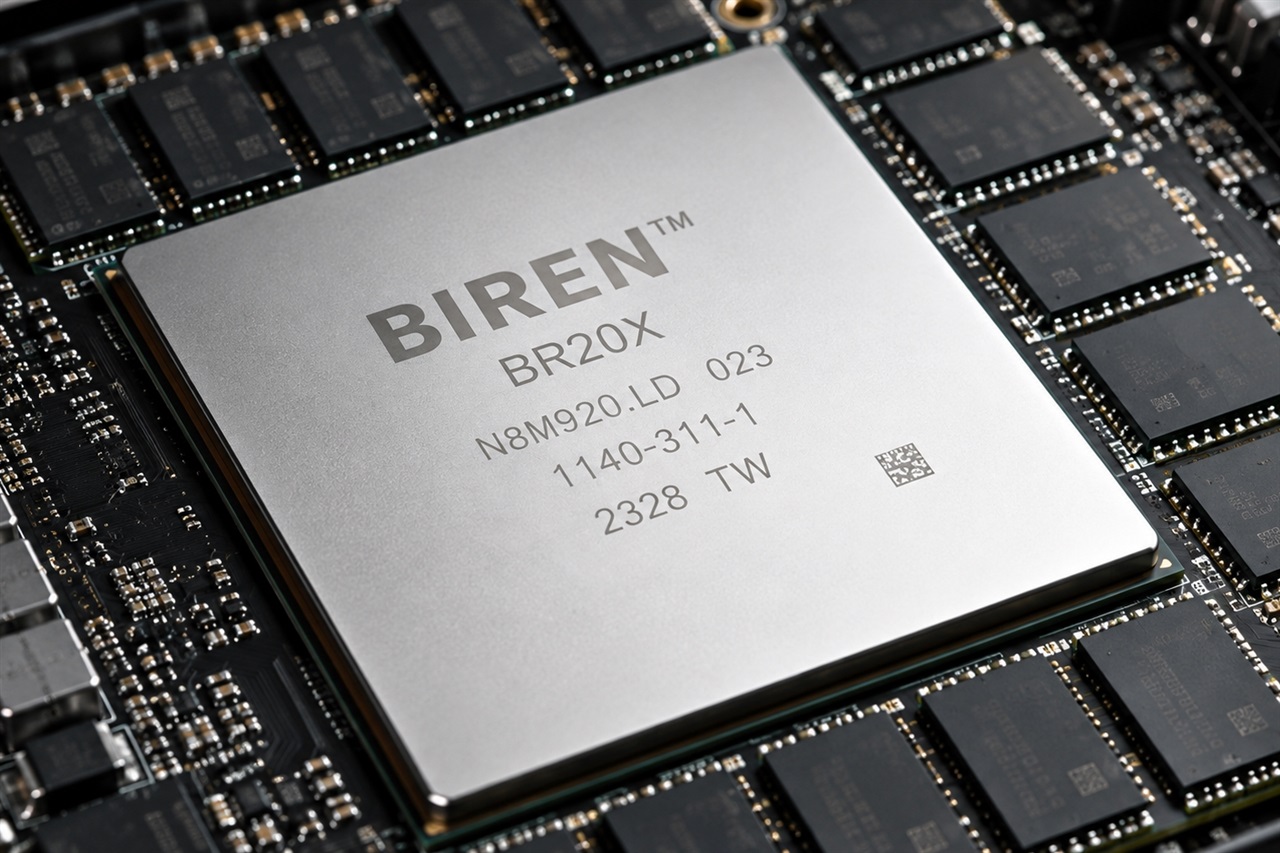
Biren prepara la BR20X e affila la sfida cinese a Nvidia
2026-10-03
Hardware
RTX 5090: Micro Center introduce dichiarazione di non esportazione
2026-10-02
Frameworks
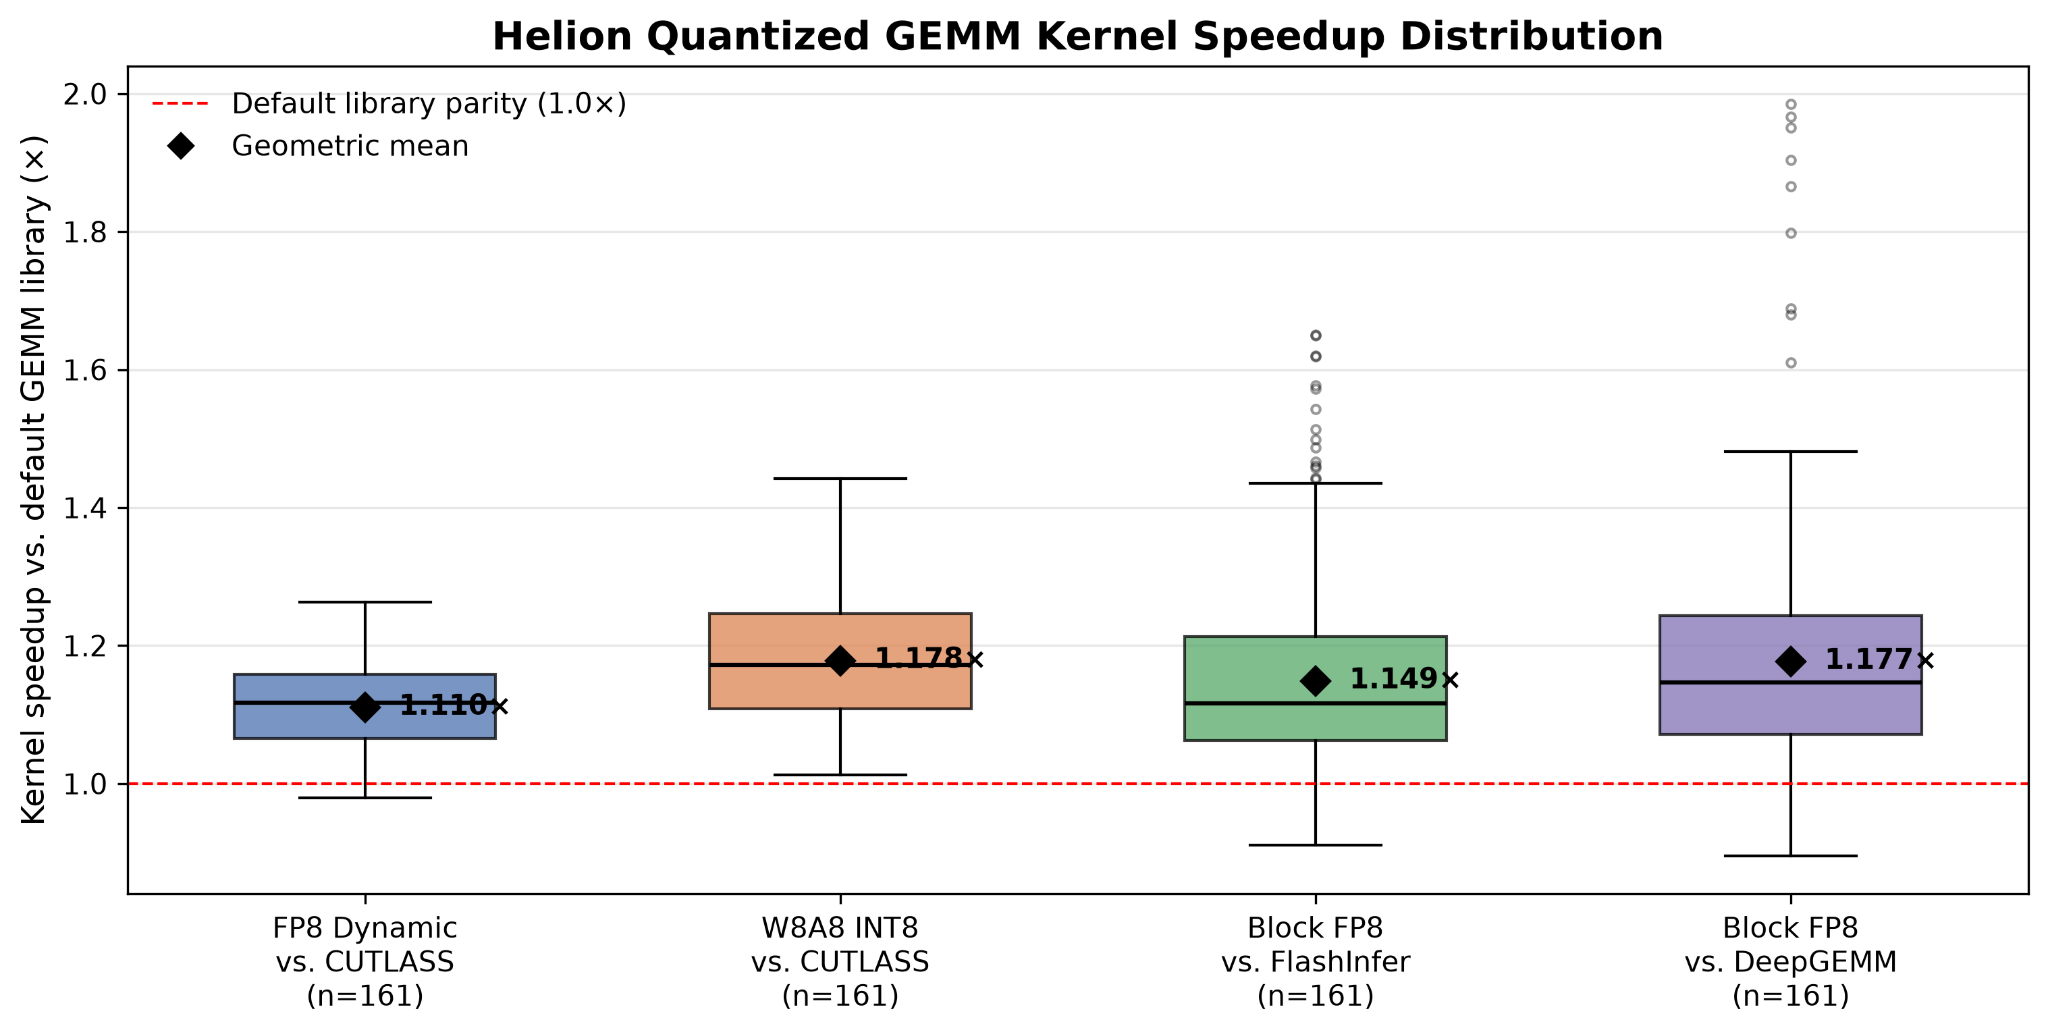
Helion nel backend vLLM: un solo GEMM, tuning per forma e guadagni fino al 10%
2026-10-02
Frameworks
La certificazione PyTorch diventa un percorso strutturato e operativo
2026-10-02
LLM
Qwen3.8-27B-Humanlike-Chat 2.0: il tono umano ora convive con tool call e istruzioni
2026-10-02