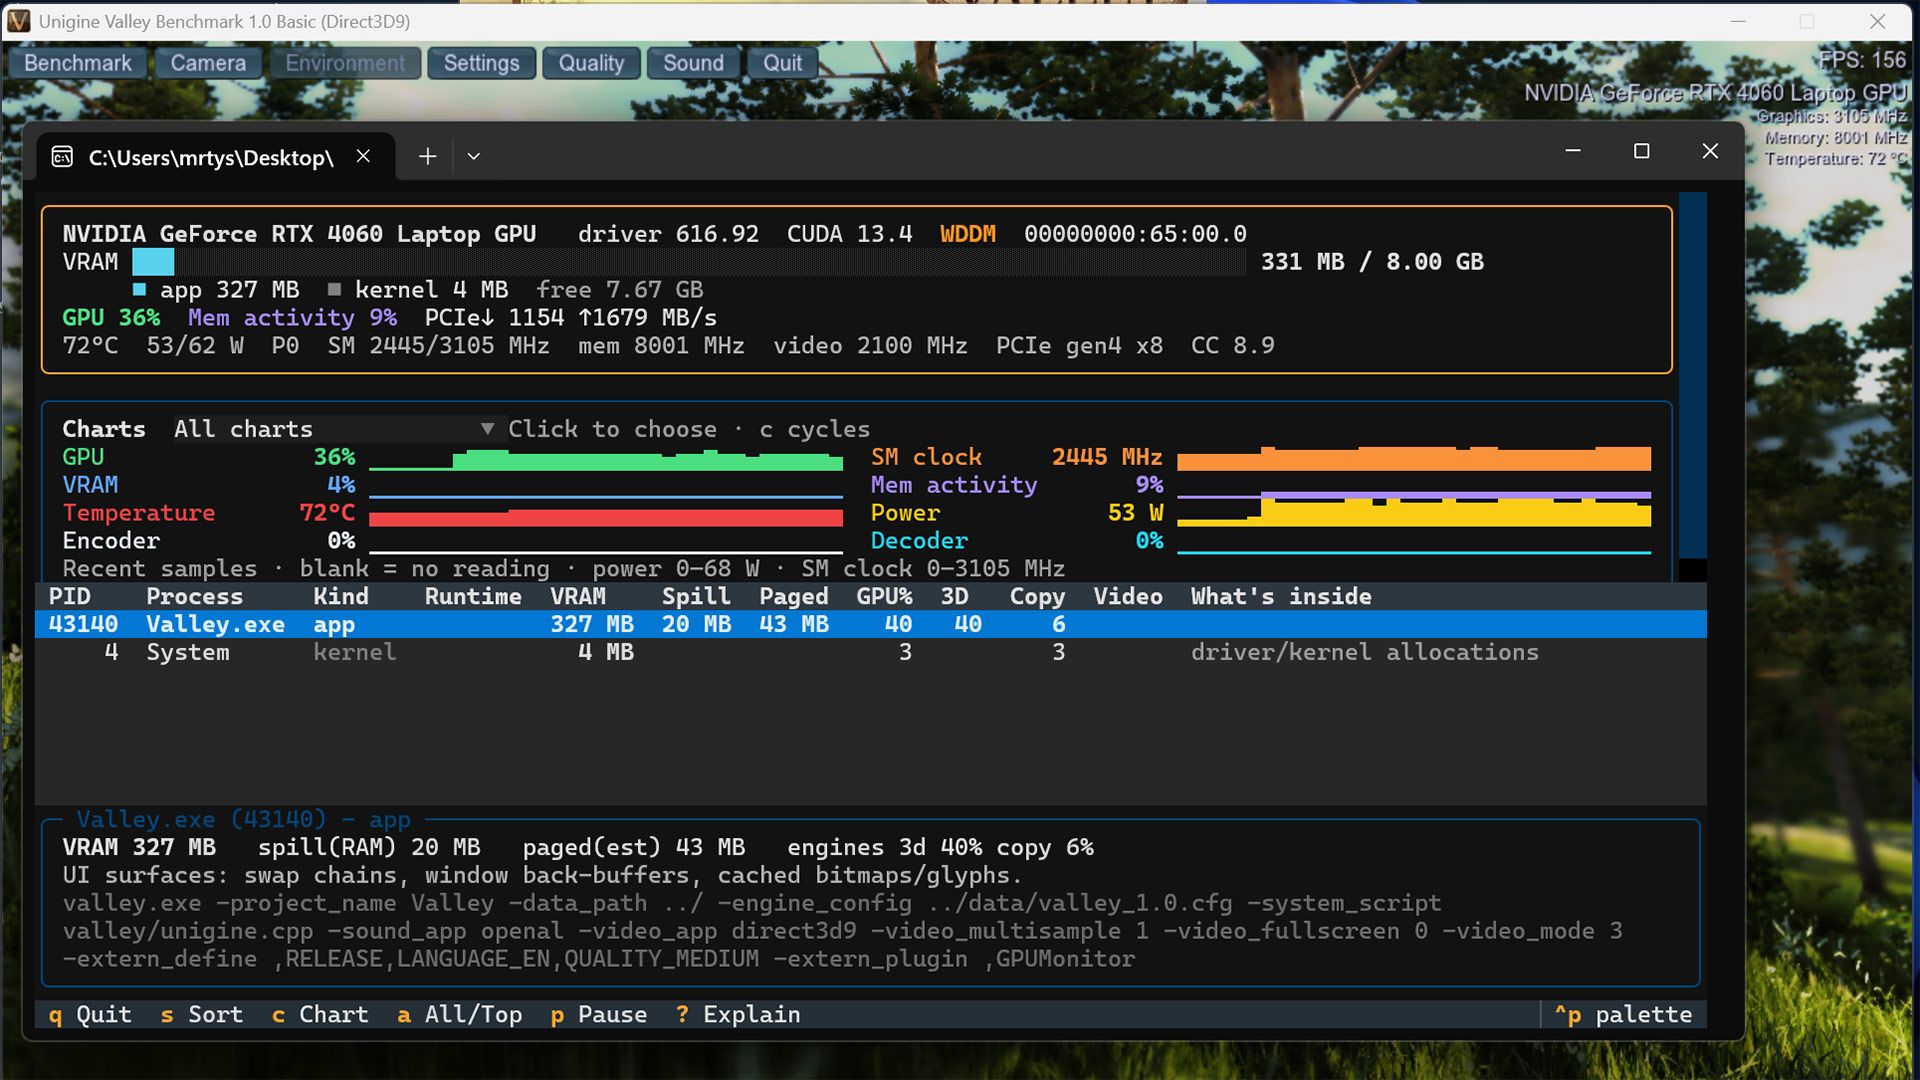
Nel lavoro quotidiano con le GPU, la VRAM è una risorsa contesa che si esaurisce in silenzio. Un LLM che non entra in memoria, un batch di inference che rallenta o un processo che trattiene allocazioni fantasma sono spesso sintomi di un consumo che resta invisibile. L'arrivo di un task manager GPU open source che mostra esattamente cosa occupa la VRAM cambia il punto di partenza: non si parte più da medie aggregate o dal classico output di nvidia-smi, ma da una mappa dei processi e delle loro richieste reali.
Oltre il debugging: la VRAM come risorsa da governare
Questa visibilità non serve solo a chi fa debugging. Per i team che gestiscono LLM on-premise o self-hosted, sapere quale componente consuma memoria è il prerequisito per decisioni di capacity planning e TCO. Senza una lettura chiara della VRAM, scegliere tra un modello più grande e una versione quantizzata diventa una scommessa. Con un monitoraggio preciso, invece, si può verificare se un determinato livello di quantization libera abbastanza spazio per allungare la context window o per ospitare più repliche del modello sulla stessa macchina.
Anche le pipeline di serving ne traggono vantaggio. Integrare un controllo granulare della VRAM nei framework di orchestrazione permette di attivare alert prima che la memoria si saturi, o di spostare il carico su un nodo con più margine. In un contesto di sovranità dei dati, questa capacità di osservazione resta sotto il controllo di chi gestisce l'infrastruttura, senza dipendere da dashboard di un cloud provider che aggregano i numeri in modo opaco.
Guardando alle implicazioni di secondo ordine, uno strumento del genere spinge i fornitori hardware e software a esporre telemetria più fine. Se la comunità open source può ispezionare e integrare il monitoraggio nei propri stack, chi vende GPU o piattaforme di inference non può più nascondere i colli di bottiglia dietro benchmark selezionati. Gli acquirenti di sistemi on-premise, dotati di dati reali sul consumo, possono negoziare configurazioni più aderenti ai carichi di lavoro effettivi invece di acquistare memoria in eccesso per sicurezza.
Nel medio termine, la diffusione di strumenti di osservabilità della VRAM segnala una maturazione dell'ecosistema locale. Non si tratta più solo di far girare un modello su una scheda, ma di gestire la GPU come una risorsa di produzione, con metriche affidabili e automazioni. Chi perde sono i fornitori che basavano il proprio valore sull'opacità delle metriche; chi guadagna sono i team che possono misurare, confrontare e ottimizzare senza dipendere da stime. La domanda che resta aperta è quanto a lungo le piattaforme cloud potranno mantenere contatori poco trasparenti quando l'alternativa open source mostra che la VRAM può essere raccontata per intero.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!