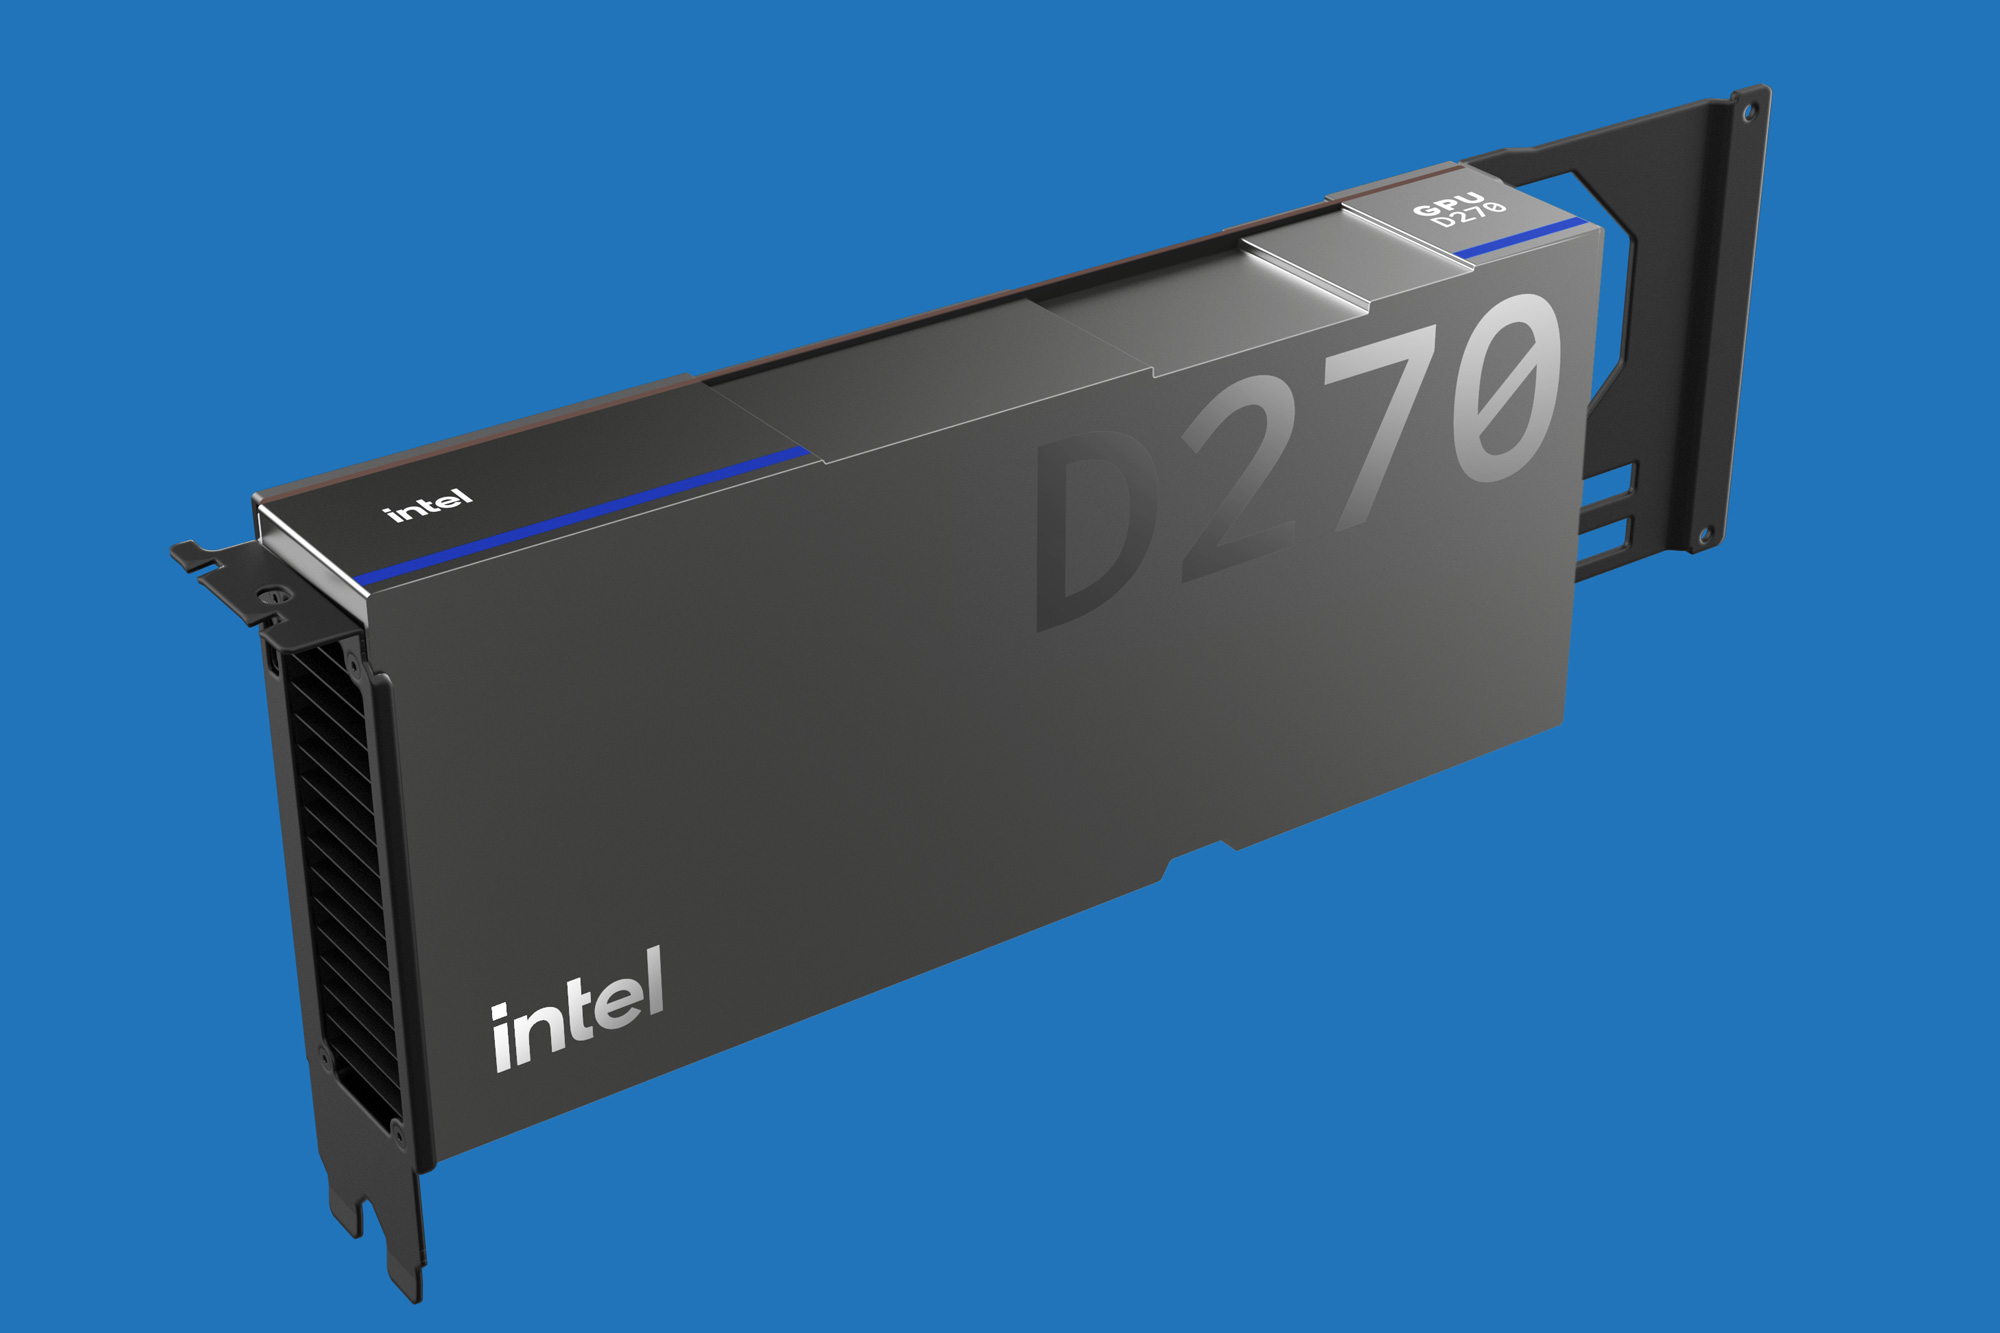
Intel ha tolto i veli alla scheda di inference AI per data center finora nota con il nome in codice Crescent Island. La nuova famiglia si chiama Intel GPU D-Series e il primo modello, D270, arriva con due numeri chiave: 1,3 PFLOPS di calcolo FP8 denso e 1,5 TB/s di banda di memoria. A prima vista sembrano specifiche da scheda come tante altre; in realtà raccontano una strategia precisa.
La scelta di mettere in evidenza il calcolo FP8 denso e la banda di memoria non è casuale. Nei carichi di inference dei Large Language Models, la generazione dei token è spesso limitata dalla capacità di spostare i pesi del modello dalla memoria ai core di calcolo. Avere 1,5 TB/s significa ridurre i tempi morti in cui i core aspettano dati: un vantaggio concreto quando si servono più richieste in parallelo. Il formato FP8, inoltre, consente di dimezzare l’ingombro dei pesi rispetto a FP16, mantenendo una qualità accettabile per molti modelli quantizzati. Per chi gestisce pipeline di LLM self-hosted, questo si traduce in un punto di partenza interessante per calcolare il costo per token, non solo la potenza assoluta.
La banda è il vero collo di bottiglia
Va letta qui la mossa di Intel. Il D270 non prova a competere frontalmente con le schede da training di fascia alta; punta al segmento dell’inference, dove il TCO non si misura in petaFLOPS grezzi ma in throughput sostenuto e consumi per richiesta. Un acceleratore con elevata banda di memoria e calcolo FP8 denso è pensato per quei deployment che devono gestire modelli già addestrati, magari quantizzati, e servire carichi continui senza colli di bottiglia.
La presenza di una terza via hardware, oltre ai dominatori del settore, amplia lo spazio di negoziazione e sposta l’attenzione dai benchmark di picco ai costi operativi reali. In ambienti con vincoli di sovranità dei dati, dove i modelli devono girare su infrastruttura locale, l’arrivo di schede ottimizzate per l’inference può cambiare i calcoli di convenienza tra cloud e on-premise. Non perché si tratti automaticamente dell’opzione migliore, ma perché allarga il perimetro delle scelte possibili. Per chi valuta deployment on-premise, AI-RADAR offre framework analitici su /llm-onpremise per soppesare questi trade-off.
Il software resta l’incognita
La vera incognita, a questo punto, è il software. Una scheda di inference non vive solo di silicio: conta la maturità di driver, runtime e supporto nei framework. Intel ha investito molto in questo campo, ma il percorso per convincere chi già gestisce pipeline consolidate non passa soltanto dalla scheda tecnica. Il D270, con il nome ufficiale e le specifiche dichiarate, è comunque un segnale: l’inference sta diventando un mercato con esigenze hardware distinte da quelle del training, e i fornitori cominciano a rispondere con prodotti dedicati.







💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!