Per anni, chi doveva eseguire codice OpenCL su una GPU NVIDIA aveva poche alternative all'implementazione fornita dal produttore. Il progetto Mesa sta cambiando questo framework: da circa un anno un'implementazione Gallium3D gira sopra l'API driver CUDA di NVIDIA. Prima nota come CLUDA, ora si chiama NOCL e, abbinata a Rusticl, funziona bene come nuova opzione di calcolo OpenCL sul driver proprietario NVIDIA.
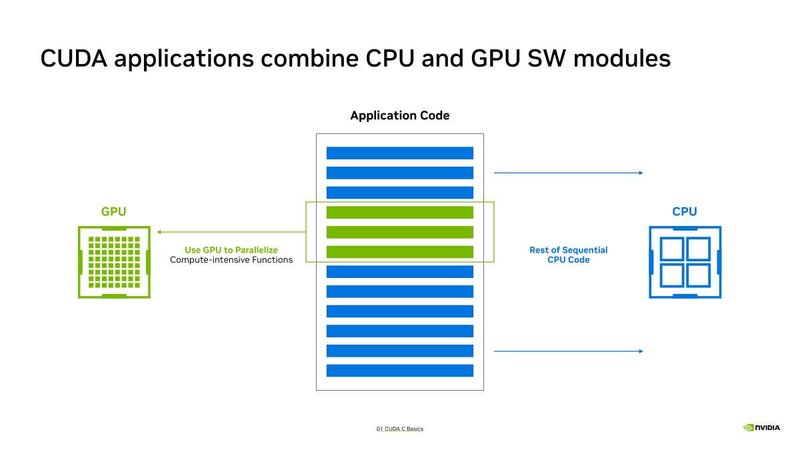
Il punto tecnico è semplice ma carico di conseguenze. Gallium3D è il framework dei driver all'interno di Mesa, usato per esporre API grafiche e di calcolo su hardware diversi. Rusticl è l'implementazione OpenCL di Mesa costruita su Gallium3D. NOCL fa da ponte: traduce le chiamate Gallium3D verso l'API driver CUDA. In questo modo il carico OpenCL non passa dall'implementazione OpenCL del vendor né dal toolchain CUDA completo, ma sfrutta solo lo strato più basso del driver NVIDIA.
La tesi da tenere d'occhio non è che CUDA venga sostituito. CUDA resta il substrato: NOCL continua a dipendere dal driver proprietario NVIDIA. La novità è che il punto di controllo si sposta più in alto. Un'organizzazione che ha standardizzato il proprio stack di calcolo su OpenCL può ora considerare le GPU NVIDIA senza adottare l'ecosistema CUDA a livello di linguaggio e runtime. Questo è rilevante per chi gestisce flotte miste di acceleratori, per centri di calcolo self-hosted e per software industriale e scientifico che parla OpenCL.
C'è un secondo effetto, meno visibile: NOCL rende Rusticl più interessante come collante aperto per il calcolo su GPU. Fino a oggi, chi voleva un runtime OpenCL open source su hardware NVIDIA doveva spesso accontentarsi di supporto incompleto o percorsi non ufficiali. Con NOCL, la comunità Mesa ha un percorso più coerente per portare workload OpenCL sul driver NVIDIA senza dipendere dalle scelte del vendor in fatto di supporto OpenCL. Non elimina il vincolo hardware: serve comunque una GPU NVIDIA e il suo driver chiuso. Ma sposta la dipendenza dal livello software a quello fisico, ed è una differenza sostanziale per chi progetta infrastrutture a lungo termine.
Per i deployment on-prem e self-hosted, il progetto offre uno spunto concreto. Chi valuta accelerazione locale per inference o per carichi HPC deve spesso scegliere tra stack aperti che funzionano bene su alcune GPU e stack proprietari che legano a un solo fornitore. AI-RADAR offre framework analitici su /llm-onpremise per valutare questi trade-off. In questo contesto, NOCL segnala che i layer di compatibilità open source possono convivere con driver proprietari, riducendo il costo di uscita da un ecosistema software senza richiedere hardware alternativo.
Naturalmente, restano interrogativi aperti su prestazioni, completezza delle funzionalità e stabilità. La fonte non riporta benchmark, e sarebbe un errore dedurre che un percorso Gallium3D sopra CUDA sia già competitivo con l'implementazione OpenCL nativa di NVIDIA. Ma il valore strutturale non sta nei numeri: sta nell'architettura di compatibilità che Mesa sta costruendo. Se NOCL matura, la scelta del runtime di calcolo diventa meno vincolata alla scelta del toolkit del produttore, e più orientata alle esigenze reali di chi gestisce l'infrastruttura.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!