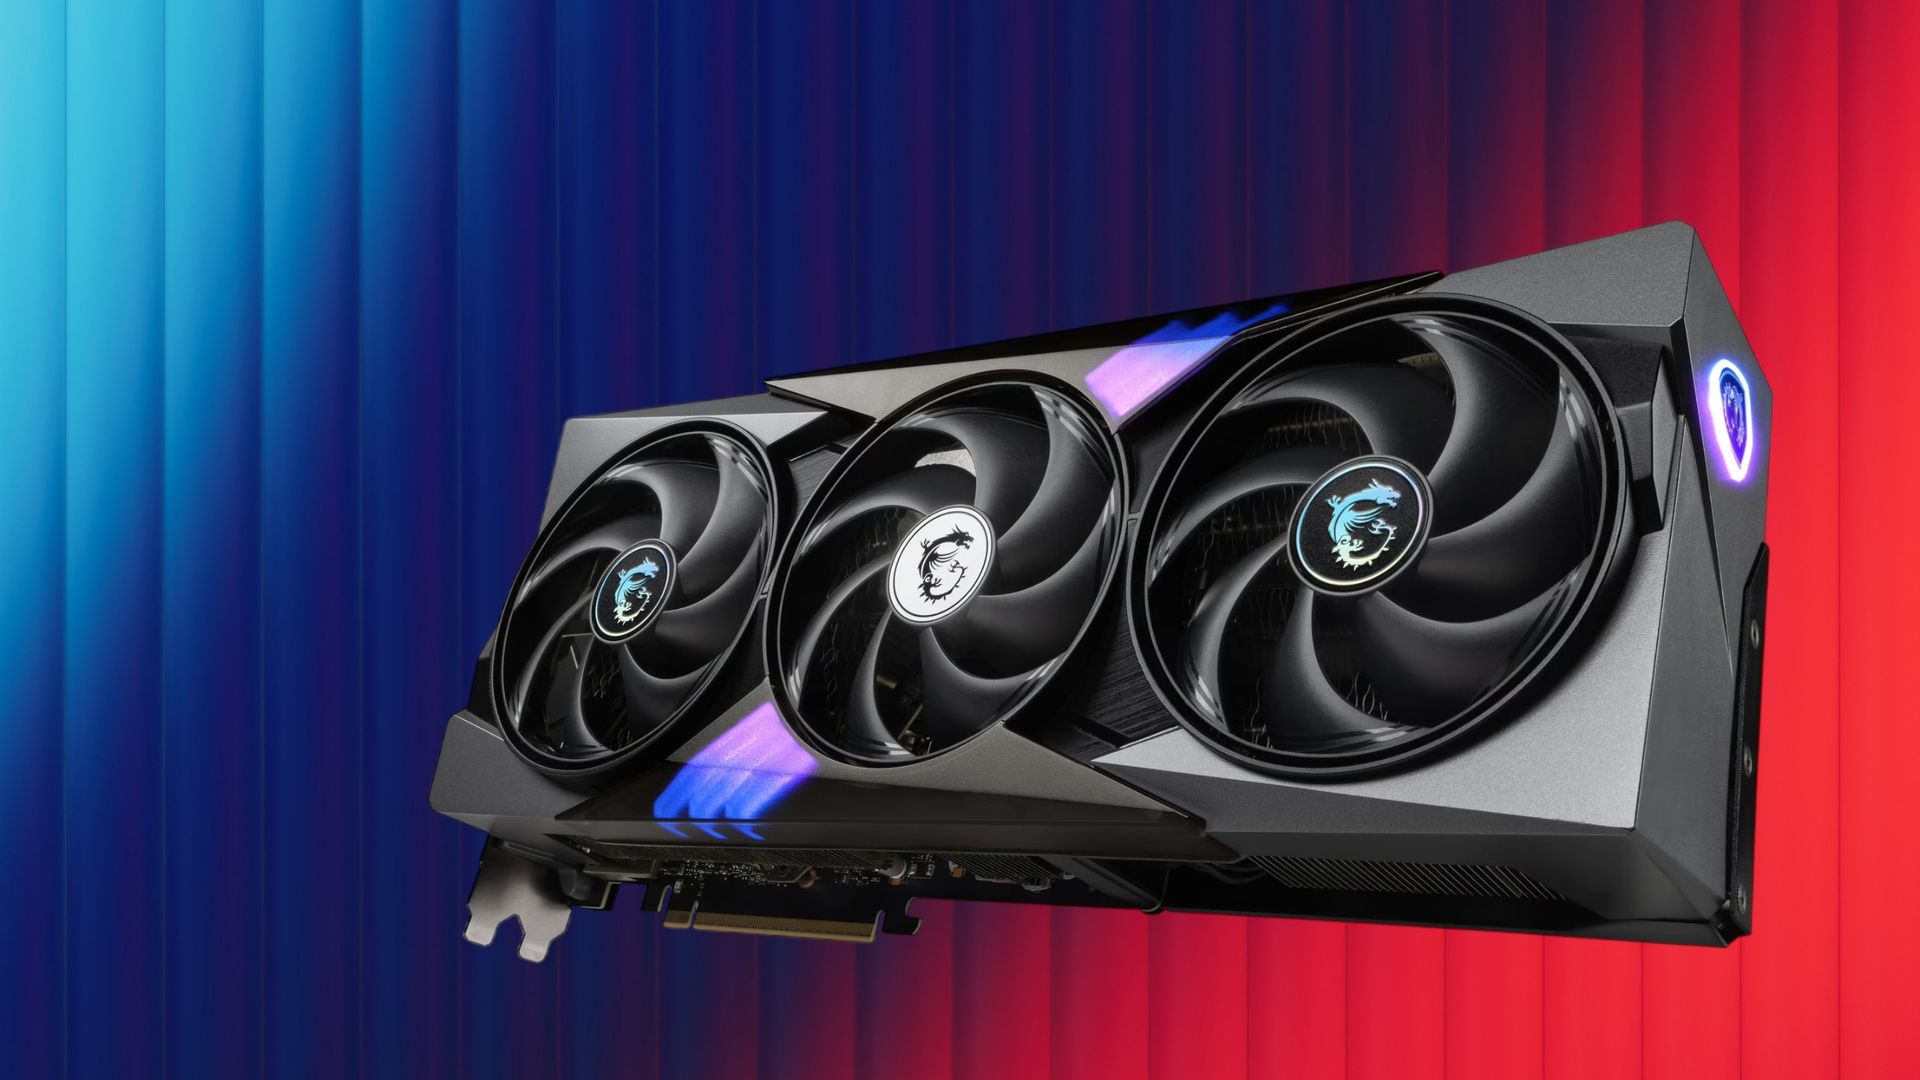
La notizia arriva come un fulmine a ciel sereno per il mercato consumer. Secondo quanto riportato, Nvidia avrebbe sospeso la produzione della GeForce RTX 5090 per indirizzare la capacità produttiva verso le GPU destinate ai data center AI e alle workstation professionali. Se confermata, non è una semplice decisione di gamma: è la fotografia di un'azienda che sposta il proprio baricentro verso il calcolo accelerato ad alto margine.
Il motore economico è difficile da ignorare. Le GPU per data center generano ricavi unitari molto superiori rispetto alle schede consumer. Con la domanda di acceleratori AI che continua a crescere, ogni wafer lavorato ha più valore se destinato a un prodotto enterprise piuttosto che a una GeForce. Non serve conoscere i numeri interni di Nvidia per capire che, in una fase di capacità produttiva limitata, la priorità va ai segmenti che pagano di più.
Il primo effetto visibile è sulla disponibilità della RTX 5090. I canali retail potrebbero vedere scorte ridotte e prezzi in salita. Per i videogiocatori e per i creatori di contenuti che usano le GeForce per rendering o post-produzione, questo si traduce in tempi di attesa più lunghi o in costi superiori. Ma c'è un effetto meno visibile e più rilevante per chi costruisce stack locali.
Le GeForce di fascia alta sono state a lungo una porta d'ingresso economica per l'inference LLM self-hosted. Offrono quantità di VRAM considerevoli a un prezzo molto più basso delle GPU professionali o data center. Se la produzione si concentra su parti enterprise, quel segmento perde una delle sue opzioni più accessibili. Non è solo una questione di gaming: si restringe l'offerta di hardware consumer con VRAM sufficiente per modelli di grandi dimensioni in quantization spinta o per fine-tuning leggero.
Questo fenomeno segnala una separazione più netta tra due mercati. Da un lato ci sono le schede consumer, progettate per il gaming e limitate nei driver e nelle garanzie per carichi lunghi e continuativi. Dall'altro ci sono le GPU professionali e data center, pensate per operare 24 ore su 24, con memoria ECC e supporto a carichi virtualizzati. La separazione non è nuova, ma la pressione della domanda AI la rende strutturale. Chi valuta deployment on-premise deve considerare che l'offerta spinge verso l'alto il costo di ingresso: le GPU consumer diventano meno affidabili come alternativa economica, mentre quelle enterprise restano allocate in volumi consistenti ai grandi fornitori cloud.
Per chi valuta deployment on-premise, i trade-off tra GPU consumer, professionali e data center non si limitano al prezzo di listino. Includono TCO, durata operativa, vincoli di licenza e disponibilità reale. Su AI-RADAR, la sezione /llm-onpremise raccoglie framework analitici per valutare questi aspetti senza ridurli a un confronto di specifiche.
La mossa attribuita a Nvidia, se confermata, consolida un trend in cui l'hardware AI è il baricentro dell'azienda, mentre la gamma GeForce diventa un segmento satellite. Non è una notizia isolata: è un indicatore di come la domanda di calcolo per l'AI stia ridisegnando le priorità produttive dell'intera filiera dei semiconduttori.






💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!