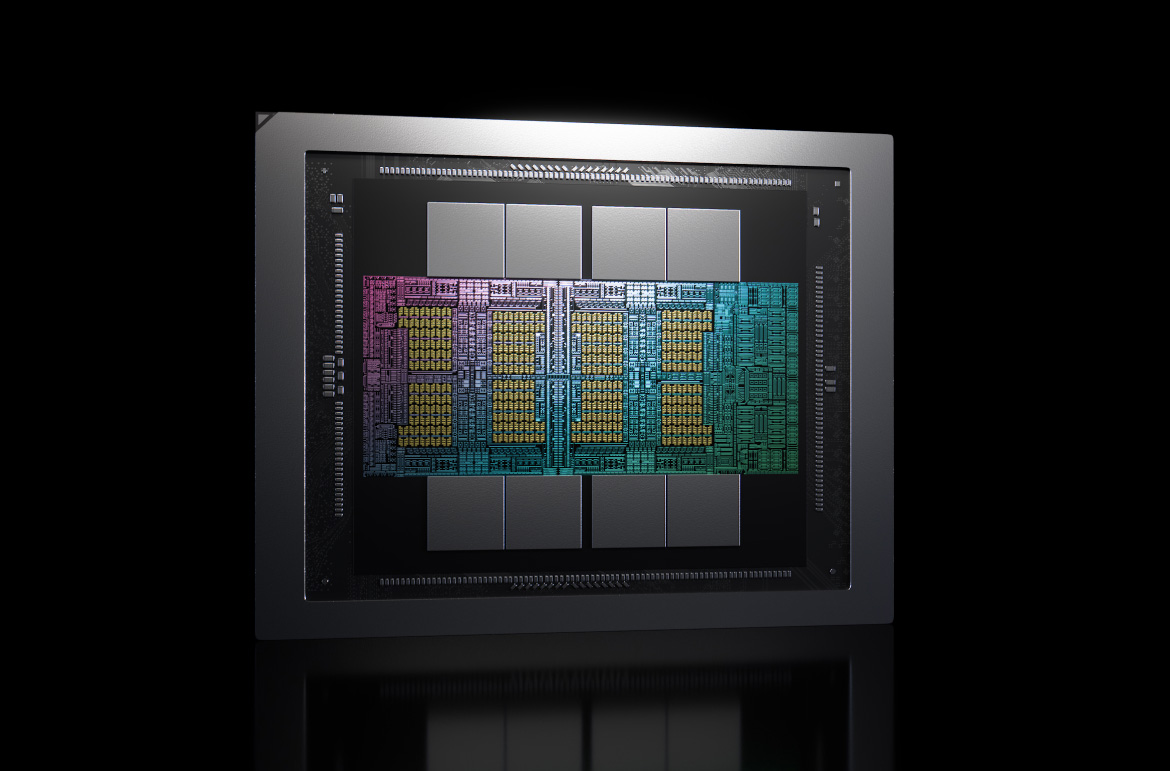
NVIDIA ha scelto il palcoscenico di SC26 per annunciare un ritorno esplicito al calcolo ad alte prestazioni. La GPU server Rubin HPC, attesa per il 2028, porta con sé oltre 50.000 CUDA core e un posizionamento dedicato ai carichi scientifici e di ingegneria. Non si tratta di una semplice estensione della linea Rubin destinata ai data center AI: il nome e il target dichiarato indicano una separazione di prodotto che merita attenzione.
La prima lettura è tecnica. Un numero elevato di CUDA core è un segnale di ampiezza del chip, ma nei carichi HPC il collo di bottiglia è spesso altrove: precisione in virgola mobile, bandwidth della memoria, capacità di muovere dati tra nodi. La fonte non entra in questi dettagli, e proprio questa assenza va tenuta presente: per valutare una GPU scientifica non basta guardare il conteggio dei core. Contano i pattern di accesso alla memoria, i layout dei dati e la capacità di sostenere simulazioni lunghe senza degrado.
La seconda lettura è di ecosistema. L'HPC è un mercato storicamente legato alle infrastrutture on-premise. Centri di ricerca, università e divisioni industriali tendono a costruire e gestire i propri cluster, per ragioni di controllo, sicurezza e prevedibilità dei costi. In questo contesto, l'annuncio di NVIDIA ha un valore diverso da quello di una GPU cloud: entra in cicli di procurement pluriennali, si confronta con vincoli di spazio, alimentazione e raffreddamento nei data center locali e viene valutata anche in termini di TCO. Non è un dettaglio minore per chi deve decidere se aggiornare un parco macchine o migrare parte dei carichi all'esterno.
Il ritorno di NVIDIA nell'HPC arriva in un momento in cui l'industria degli acceleratori è dominata dalla domanda per training e inference di LLM. La scelta di dedicare una variante specifica alla scienza e all'ingegneria segnala che i compromessi di progettazione richiesti da questi due mondi non sono identici. Un acceleratore pensato per il training di reti neurali può non essere la risposta ottimale per una simulazione di fluidodinamica o per un calcolo di chimica computazionale. NVIDIA, separando le linee, sembra riconoscere che l'HPC non è un sottoprodotto dell'AI, ma un mercato con esigenze proprie.
Per chi osserva il deployment locale, il messaggio è chiaro: le piattaforme HPC continueranno ad avere hardware dedicato, e la roadmap arriva fino al 2028. Questo riduce l'incertezza per i laboratori che stanno pianificando investimenti a lungo termine, ma introduce anche una complessità nuova: mantenere competenze per due ecosistemi, gestire stack software differenti e valutare se i carichi possano convivere sulla stessa infrastruttura o richiedano silos separati. La convenienza dipenderà dai vincoli specifici, non da un confronto generico di specifiche.
AI-RADAR segue proprio questo tipo di trade-off: per chi valuta deployment on-premise, esistono framework analitici su /llm-onpremise che aiutano a mettere in fila i vincoli reali di un'infrastruttura locale. Nel caso di Rubin HPC, la variabile da osservare sarà la capacità del software scientifico di sfruttare la nuova architettura: senza un ecosistema maturo di librerie e compilatori, nemmeno il silicio più capiente si traduce in risultati utili.
L'arrivo di Rubin HPC nel 2028 lascia una domanda aperta: quanto della potenza aggiuntiva andrà a beneficio dei carichi scientifici tradizionali e quanto, invece, verrà assorbita da pipeline ibride che mescolano simulazione e AI? La separazione di prodotto è un segnale, ma la risposta arriverà solo quando si vedranno i carichi reali sui primi cluster.






💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!