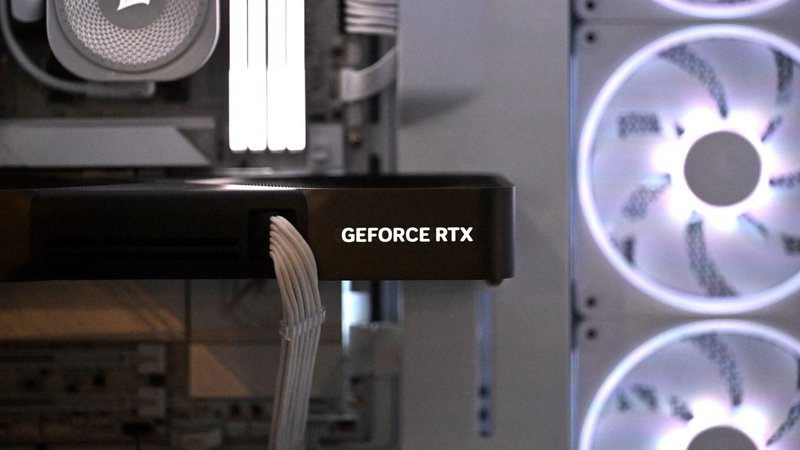
Un centro di riparazione ha ricevuto in due giorni otto schede GeForce RTX 5090 e RTX 4090 con connettori a 16 pin fusi. Non è una statistica isolata: vede due generazioni successive nello stesso lotto di guasti, e questo rende il difetto più interessante per chi considera queste schede non come hardware da gaming, ma come motori per carichi di inference locale.
Il connettore a 16 pin è diventato il collo di bottiglia termico e meccanico delle schede di fascia alta. Quando l'assorbimento di corrente è elevato e la superficie di contatto è piccola, un connettore non perfettamente inserito, piegato o sottoposto a stress laterale fa aumentare la resistenza elettrica e accumulare calore. Il risultato è la fusione. In una workstation lasciata accesa per fine-tuning o per inference continua, i cicli termici possono amplificare i micro-movimenti e trasformare un contatto marginale in un guasto.
Per chi valuta il deployment on-premise, la questione non è estetica ma di TCO. Un sistema self-hosted basato su GPU consumer sembra spesso più economico di acceleratori da datacenter, ma se la catena di alimentazione cede dopo mesi di esercizio il costo reale include downtime, resi, potenziali danni all'alimentatore e lavoro manuale per smontare il nodo. Un connettore fuso non è solo un difetto visivo: può danneggiare la scheda, l'alimentatore e creare un rischio incendio in un rack o in un armadio. In contesti on-premise il rischio cresce perché la macchina può restare accesa senza supervisione.
La vicenda segnala che le schede consumer di fascia alta vengono spinte oltre i margini di sicurezza del loro connettore. I produttori potrebbero rispondere con connettori più robusti, meccanismi di blocco o monitoraggio della corrente per pin, ma queste modifiche richiedono tempo. Nell'immediato, i beneficiari sono i fornitori di cavi e alimentatori di qualità superiore, mentre i centri di riparazione diventano il primo aggregatore di dati sui guasti sul campo, un ruolo che nei datacenter è svolto dai team di manutenzione. Chi ci perde è il singolo team o professionista che ha comprato una RTX 5090 per carichi AI e si ritrova con tempi di fermo più lunghi del previsto.
A livello strutturale, il caso evidenzia la distanza tra GPU consumer e acceleratori da datacenter nella progettazione della power delivery. Le schede da datacenter sono pensate per carichi sostenuti e stadi di alimentazione più tolleranti; le schede consumer no. Questa differenza pesa quando i team AI evitano il cloud e costruiscono macchine locali. Il difetto del connettore non riporterà automaticamente tutti al cloud, ma alza il costo nascosto del percorso on-premise fai-da-te.
Il fatto che otto schede siano arrivate a un solo centro riparazioni in due giorni suggerisce che non si tratti di un raro difetto di fabbricazione, ma di una modalità di guasto legata al carico che emerge sotto carichi reali. Per chi valuta hardware LLM locale, il connettore di alimentazione merita la stessa attenzione della VRAM o della potenza di calcolo.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!