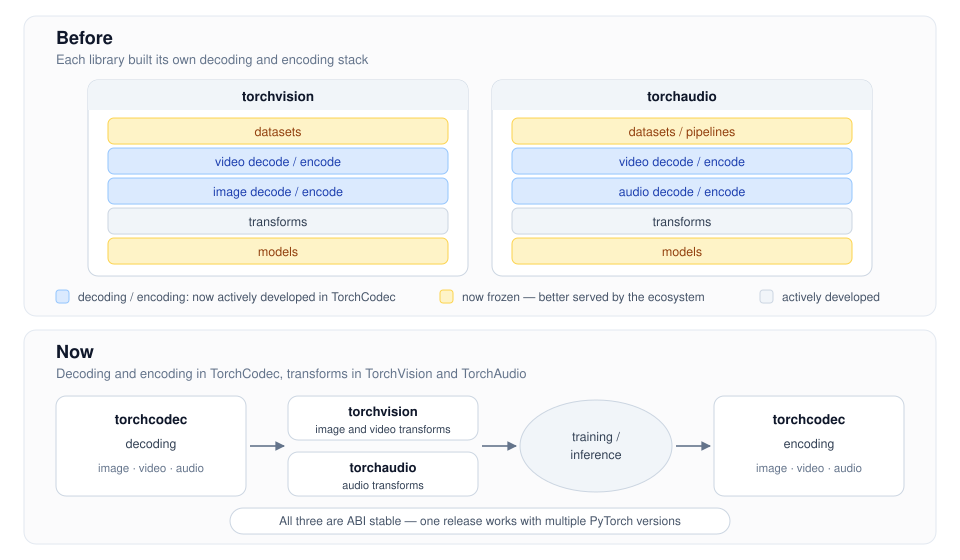
C'era un tempo in cui leggere un video dentro PyTorch poteva significare scegliere tra tre backend, ognuno con vincoli diversi: PyAV disponibile subito, backend C++ FFmpeg e CUDA/NVCUVID da compilare a mano e legati a versioni specifiche. Lo stesso valeva per l'audio, diviso tra StreamReader, StreamWriter e utility con più dipendenze. Il team di PyTorch ha scelto di chiudere questa stagione: da oggi, decodifica e codifica di immagini, video e audio passano da TorchCodec, su CPU e CUDA. TorchVision e TorchAudio non spariscono, ma si restringono alle trasformazioni sui tensori. Modelli, dataset e pipeline non sono più sotto sviluppo attivo: il team indica nelle librerie Hugging Face l'alternativa naturale per quella parte.
La fonte è un post del team PyTorch, non un annuncio commerciale, e va letta come una presa di posizione architetturale. Dietro la razionalizzazione c'è un problema molto concreto di manutenzione: l'I/O multimediale trascina con sé sei versioni maggiori di FFmpeg, l'SDK codec NVIDIA per la decodifica GPU e una libreria per ogni formato immagine, tutte in C/C++, nessuna pura Python. Non è una questione teorica: è build, CI e rilasci che diventano pesanti, errori di packaging e difficoltà nel distribuire wheel. Concentrare tutto in TorchCodec significa isolare questa complessità in un punto solo e permettere a TorchVision e TorchAudio di avere un ciclo di sviluppo più snello.
Per chi fa deployment locale o self-hosted di modelli che vedono o ascoltano, il vantaggio non sta tanto nel nome della libreria, quanto nella prevedibilità. Prima serviva capire quale API offrisse il decoder giusto e quale backend fosse compilato nella distribuzione. Ora la scelta è una sola. Non è un dettaglio: in ambienti air-gapped o con controllo rigoroso delle dipendenze, ogni libreria C/C++ in meno riduce superficie di attacco e tempi di validazione. TorchCodec punta inoltre a prestazioni migliori, in particolare per la decodifica video CUDA. Ciò ha implicazioni per le pipeline di addestramento di modelli multimodali o generativi, dove la normalizzazione dei dati può diventare il collo di bottiglia prima ancora della GPU.
Perché l'ABI stability sposta gli incentivi
La nota sulle API ABI stabili è forse il segnale più interessante. TorchCodec, TorchVision e TorchAudio non sono più vincolati a una singola versione di PyTorch: una versione continua a funzionare con le release successive del framework. Per un team che mantiene un parco macchine on-premise, questo riduce la pressione a riallineare tutto lo stack a ogni aggiornamento di PyTorch. È un cambiamento che allenta il lock-in tra librerie e runtime, spostando il costo di migrazione su chi oggi usa ancora le API di I/O deprecate in TorchVision e TorchAudio. La guida alla migrazione serve proprio a questo: limitare l'attrito, ma non azzera la necessità di toccare il codice, soprattutto in TorchAudio, dove diverse API sono state rimosse dopo una revisione con la comunità.
La riorganizzazione ha anche un effetto competitivo. Le funzioni di trasformazione restano presidiate da PyTorch, mentre la gestione dei modelli e dei dataset si sposta di fatto verso Hugging Face. Non è una resa, ma una divisione del lavoro coerente con l'evoluzione dell'ecosistema: il framework non può più essere l'unico fornitore di tutti gli strati. Resta da seguire con attenzione il follow-up promesso sulle novità delle singole librerie e su come ottenere il massimo delle prestazioni da una pipeline completa di decoding e transform. Per ora, il messaggio operativo è chiaro: chi lavora con media in PyTorch deve pianificare il passaggio a TorchCodec, non solo per convenienza ma perché il vecchio percorso è destinato a restare senza sviluppo attivo.




💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!