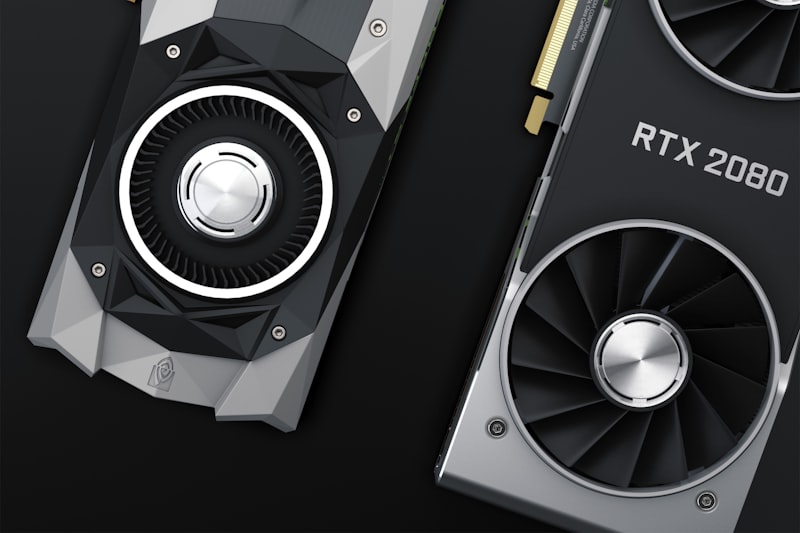
Una GPU che non arriva può dire più di molte schede che escono. Le voci raccolte in queste ore indicano che NVIDIA avrebbe cancellato la variante GeForce RTX 5080 con 24 GB di VRAM, lasciando in listino il solo taglio da 16 GB. La notizia circola a partire da un post su Reddit dell'utente chemist_slime, con link e commenti come base: va trattata come indiscrezione, non come annuncio ufficiale.
Una scelta di segmentazione
Se confermata, la decisione non riguarda solo una sigla di prodotto. La quantità di memoria è uno degli strumenti con cui NVIDIA separa i segmenti di mercato. Una RTX 5080 da 24 GB avrebbe creato un pericoloso cortocircuito con schede di fascia più alta o con le linee professionali, spingendo parte della domanda verso un prodotto consumer capace di gestire modelli locali più grandi. Tenere la 5080 a 16 GB, invece, mantiene un gradino netto: chi vuole più VRAM deve salire di prezzo o guardare altrove.
Il vincolo della VRAM per chi resta locale
Questo ha effetti diretti sul deployment on-premise di LLM. La VRAM è il collo di bottiglia principale per l'inference locale: determina quali modelli entrano in memoria senza ricorrere a quantization aggressiva o all'offloading su CPU. Un taglio da 16 GB restringe il perimetro di ciò che si può eseguire in modo fluido su singola scheda, soprattutto quando si lavora con architetture più grandi o con contesti estesi. Per i team che valutavano la 5080 come opzione economica per self-hosted, la cancellazione del modello da 24 GB sposta il calcolo del TCO: o si accetta il vincolo dei 16 GB, oppure si sale verso GPU con più memoria, aumentando il CapEx.
Ma c'è un secondo effetto, meno visibile. Le GPU consumer con molta VRAM sono state storicamente una via d'accesso per sperimentatori, laboratori universitari e piccole aziende che non possono permettersi acceleratori da data center. Se NVIDIA toglie il gradino intermedio, spinge questi utenti verso tre strade: acquistare schede della generazione precedente ancora dotate di 24 GB, ripiegare su configurazioni multi-GPU con costi di alimentazione e raffreddamento più alti, oppure spostare parte del carico verso il cloud, rinunciando al controllo diretto dei dati. Ognuna di queste scelte cambia gli incentivi: il mercato dell'usato può surriscaldarsi, le soluzioni cloud guadagnano terreno per i carichi sporadici, e chi sviluppa motori di inference per hardware consumer deve ottimizzare per un tetto di memoria più basso.
Per chi valuta il deployment on-premise, questi trade-off non sono astratti: la VRAM disponibile condiziona la fattibilità di modelli locali, le strategie di quantization e le architetture di serving. Su /llm-onpremise AI-RADAR raccoglie analisi e framework per confrontare i vincoli reali.
In definitiva, la presunta cancellazione della RTX 5080 da 24 GB non è una notizia tecnica marginale: è un segnale di come il controllo della memoria resti la leva con cui separare il gaming dal calcolo locale per l'AI. Finché la VRAM resterà scarsa sui prodotti consumer, la sovranità dei dati per chi vuole modelli on-premise avrà un costo hardware più alto.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!