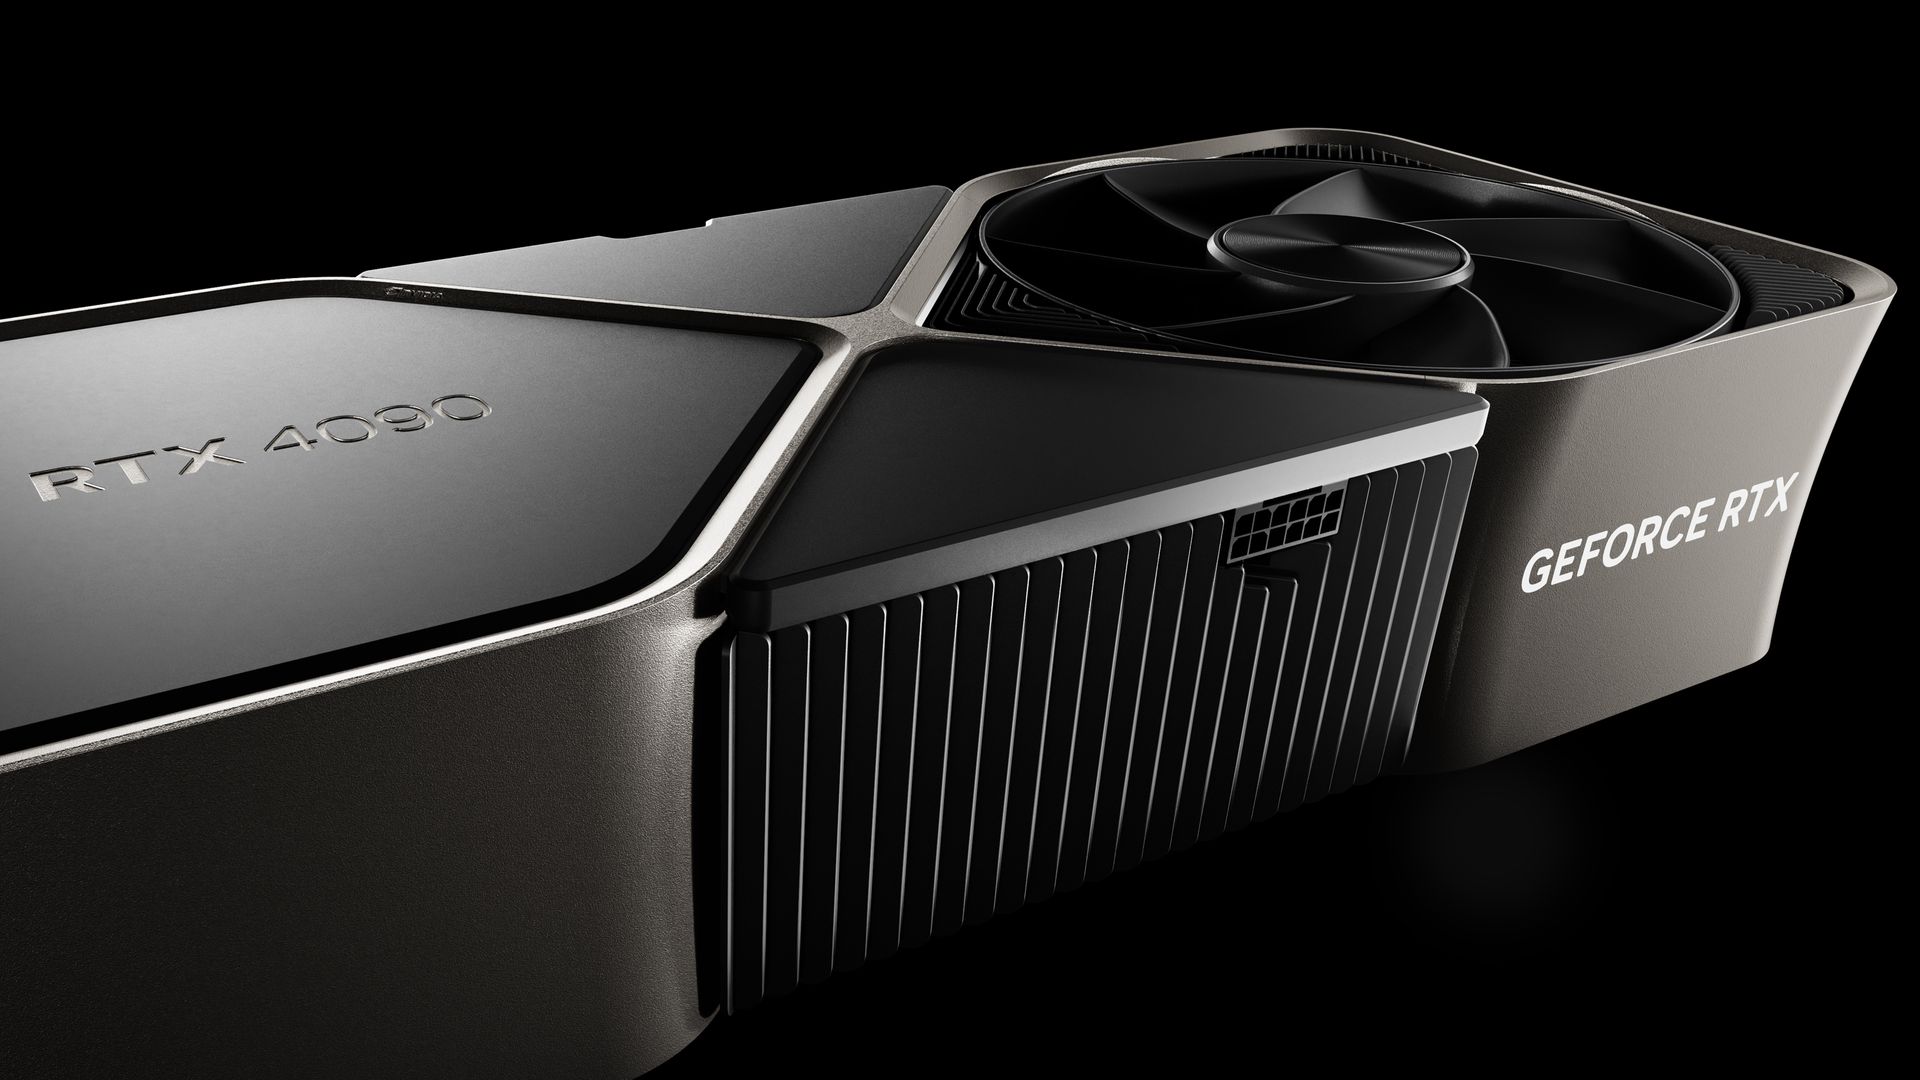
La notizia è tanto semplice quanto potenzialmente dirompente: sulle schede Nvidia delle serie RTX 20, 30 e 40 è stata applicata una modifica che elimina un freno capace di ridurre della metà la velocità nei carichi di intelligenza artificiale. Non si tratta di un overclock spinto, ma della rimozione di un vincolo che, di fatto, riporta l'hardware consumer a competere più da vicino con le proposte professionali.
Il contesto è noto a chi lavora con LLM e inference. Le GPU consumer di Nvidia hanno da sempre convissuto con limitazioni di tipo driver o firmware che ne riducono la resa in operazioni tipiche dell'AI, come i calcoli a precisione ridotta o l'uso dei tensor core. Un dimezzamento della velocità in questi carichi non è un dettaglio da poco: si traduce in meno token generati al secondo, latenza più alta e un costo per token che sale, soprattutto quando si cerca di mantenere tutto in locale.
Per chi valuta deployment self-hosted o edge, la prospettiva cambia. Il costo complessivo di una piccola macchina per inference basata su GPU consumer è storicamente molto più basso rispetto alle controparti data center, ma spesso frenato proprio da queste limitazioni. Se il freno viene rimosso in modo stabile, il TCO di un nodo locale può scendere in misura sensibile, avvicinando soluzioni che prima erano considerate solo da sperimentazione.
Le implicazioni di secondo ordine sono altrettanto significative. Nvidia ha costruito una segmentazione di mercato precisa: schede consumer per gaming, schede professionali e acceleratori data center per carichi AI. Una modifica che rende le RTX consumer più competitive erode parte di questa distinzione. Chi ne beneficia sono gli appassionati, i piccoli team e le realtà che vogliono mantenere il controllo dei dati senza investire in hardware professionale. Chi ne esce penalizzata è la stessa Nvidia, almeno nel breve periodo, perché il canale professionale perde parte del suo differenziale prestazionale.
C'è poi un segnale strutturale: la domanda di calcolo AI locale a basso costo è così forte da spingere la comunità a cercare soluzioni al di fuori dei percorsi ufficiali. Non è una novità assoluta, ma il fatto che coinvolga tre generazioni di GPU indica una pressione costante. Per chi segue il panorama AI-RADAR, casi come questo mostrano quanto la scelta dell'hardware on-premise non sia solo una questione di compatibilità, ma anche di vincoli imposti a monte. Esistono framework analitici su /llm-onpremise per valutare i trade-off tra GPU consumer e soluzioni professionali, ma qui la variabile è un'altra: la volontà del vendor di mantenere artificialmente una distanza prestazionale.
La vicenda resta aperta. Non ci sono dettagli ufficiali su stabilità, supporto driver o implicazioni di garanzia. Tuttavia, il semplice fatto che se ne parli dimostra che l'inference locale su hardware consumer è ormai un terreno di confronto strategico, non un ripiego.



💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!