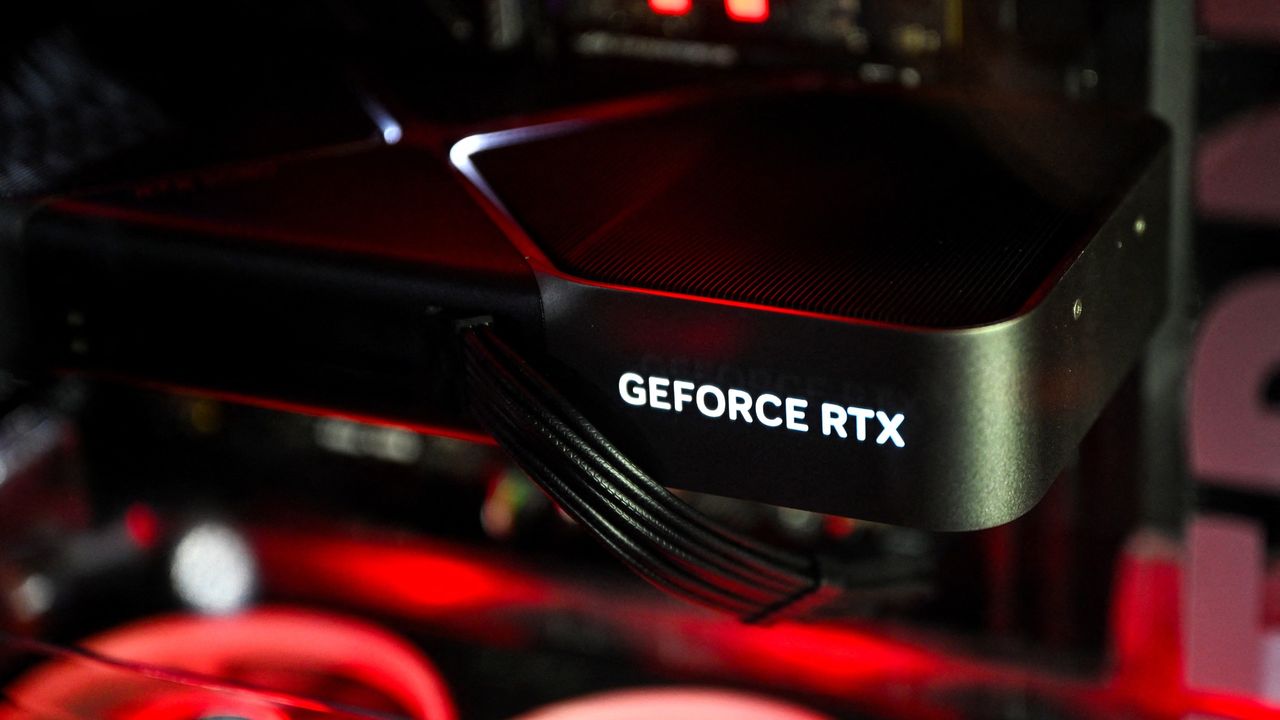
La RTX 5090 è sparita dai listini dei negozi online statunitensi. Quando compare, è solo attraverso venditori terzi che chiedono fino a 9.500 dollari per quella che Nvidia presenta come la sua GPU più veloce. Non è una crisi di domanda debole: è l'esatto contrario. La scheda è diventata introvabile e il mercato secondario ha trasformato la scarsità in un meccanismo di prezzo, con quotazioni che escludono di fatto la maggior parte degli acquirenti.
Per chi si occupa di infrastrutture locali per LLM, questa dinamica non è una curiosità da appassionati di gaming. Le GPU di fascia alta sono sempre più utilizzate per l'inference self-hosted: offrono un compromesso tra costo d'ingresso, disponibilità di VRAM e possibilità di mantenere i dati all'interno dei propri sistemi. Quando l'offerta retail si prosciuga, però, quel compromesso salta. Il costo effettivo di una GPU per un piccolo laboratorio o un team che vuole sperimentare modelli locali non è più il prezzo di listino, ma il prezzo imposto dai rivenditori secondari. E quest'ultimo è volatile, opaco e raramente compatibile con una pianificazione di CapEx seria.
Oltre il gaming: la corsa alla VRAM
Il fenomeno produce implicazioni di secondo ordine. Prima di tutto, spinge chi ha bisogno di calcolo locale verso canali enterprise o verso soluzioni cloud, anche quando la scelta on-premise sarebbe preferibile per sovranità dei dati o prevedibilità dei costi. In secondo luogo, seleziona gli acquirenti: non vince chi ha il progetto più interessante, ma chi è disposto a pagare il sovrapprezzo. Questo rischia di rallentare l'adozione di LLM self-hosted proprio tra i soggetti che ne trarrebbero maggiore beneficio in termini di controllo e riservatezza.
A livello strutturale, la scomparsa della RTX 5090 dai canali ufficiali è un indicatore anticipatore: la domanda di calcolo locale non si esaurisce nel gaming, ma assorbe la stessa capacità produttiva che serve al mercato consumer. Se questa tendenza si consolida, le GPU di punta smetteranno di essere un bene d'acquisto programmabile e diventeranno un asset soggetto a picchi speculativi, con effetti a catena su chi costruisce infrastrutture on-premise.
Per chi valuta deployment on-premise, esistono trade-off tra disponibilità, costo e controllo che non possono essere ignorati; AI-RADAR dedica a questi confronti una sezione su /llm-onpremise. Intanto, nei listini ufficiali americani, la scheda non c'è più.





💬 Commenti (0)
🔒 Accedi o registrati per commentare gli articoli.
Nessun commento ancora. Sii il primo a commentare!