Digest Settimanale Questa settimana

📖 AI-Radar · 2026-W46

09 November – 15 November 2026  ·  5 articoli pubblicati

📁 LLM 2

LongCat-2.5: 1,6 trilioni di parametri e il conto con l'hardware on-prem

LongCat-2.5: 1,6 trilioni di parametri e il conto con l'hardware on-prem

Su Hugging Face compare LongCat-2.5, un modello multimodale da 1,6 trilioni di parametri. La scheda tecnica è essenziale, ma la dimensione impone riflessioni su VRAM, quantization e requisiti per l'inference self-hosted. L'articolo analizza cosa significa per chi valuta deployment locale e quali trade-off emergono quando la frontiera dei modelli disponibili pubblicamente si scontra con i vincoli di memoria e TCO.

09 Nov #Hardware #LLM On-Premise #Fine-Tuning
Gemma 5 e l'inference self-hosted: il caso di una startup europea

Gemma 5 e l'inference self-hosted: il caso di una startup europea

Una startup europea chiede informazioni sui prossimi modelli Gemma e descrive un deployment reale: Gemma 4 31B con quantization NVFP4 su tre RTX Pro 6000, usato per ragionamento linguistico in tedesco e inglese. Il punto non è il coding ma la qualità di comprensione e la velocità in token al secondo. L'attesa di Gemma 5 rivela la pressione su LLM self-hosted e hardware locale per carichi multilingue.

09 Nov #Hardware #LLM On-Premise #DevOps

📁 Hardware 1

Bull investe 80 milioni per la sovranità europea dei supercomputer

Bull investe 80 milioni per la sovranità europea dei supercomputer

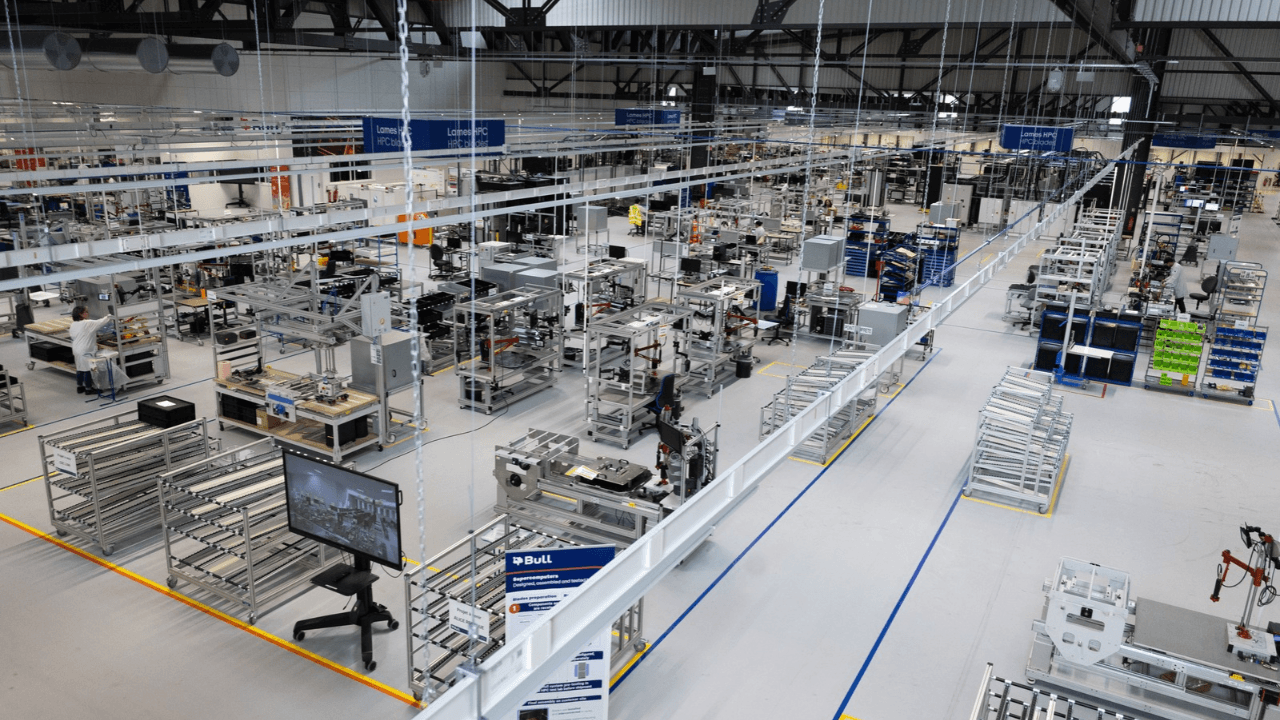
Bull inaugura ad Angers un sito produttivo ampliato con 80 milioni di euro, portando la capacità a 12 rack a settimana e puntando su componenti europei al 70%. L'Open Factory apre l'infrastruttura alle startup, mentre il direct liquid cooling e l'interconnessione BXI rafforzano il controllo sulla supply chain. Una mossa che cambia gli incentivi per chi valuta deployment on-premise e sovranità dei dati.

09 Nov #Hardware #LLM On-Premise #Fine-Tuning

📁 OnPremise 1

La Modularità degli LLM: Un Segnale di Svolta per l'Framework On-Premise

La Modularità degli LLM: Un Segnale di Svolta per l'Framework On-Premise

La proposta di distribuire adattatori LoRA anziché intere copie di LLM modificati segnala un cambiamento epocale verso la modularità nell'ecosistema dell'intelligenza artificiale. Per le organizzazioni che gestiscono infrastrutture self-hosted, questa evoluzione promette una significativa riduzione del TCO, ottimizzando storage, banda e manutenzione. Al contempo, offre un controllo senza precedenti sulla governance dei modelli e sulla sovranità dei dati, pur introducendo nuove sfide legate alla sicurezza e alla provenienza degli adattatori. AI-RADAR analizza le implicazioni di questa transizione per i decision-maker tecnici.

09 Nov

📁 Frameworks 1

FinEvolveKG: evoluzione controllata dei prompt per knowledge graph finanziari

FinEvolveKG: evoluzione controllata dei prompt per knowledge graph finanziari

FinEvolveKG separa regole generali e policy persona, confina l’ottimizzatore riflessivo GEPA a blocchi specifici, mantenendo byte-stable il blocco approvato. Un doppio obiettivo bilancia qualità temporale e fatti persona. Nei test su 10-K ticker-disjoint, il workflow completo v4 supera il prompt congelato del 19,4–30,9% e l'ottimizzazione non vincolata v5 del 2,2–6,4%, con migliori prestazioni OOD e audit SME favorevole.

09 Nov #LLM On-Premise #Fine-Tuning #DevOps
← 2026-W45 Tutte le notizie