Topic / Trend Rising

Agenti AI: orchestrazione e affidabilità

L'AI agentica sta entrando nei loop di produzione, nell'orchestrazione BI e nel coordinamento CPU-GPU. Il collo di bottiglia principale sono i guasti silenziosi dei tool e l'affidabilità degli harness di esecuzione, non la qualità di generazione grezza.

Detected: 2026-09-24 · Updated: 2026-09-24

Articoli Correlati

2026-09-24 • DigiTimes

Intel: il coordinamento CPU-GPU al centro dell'AI agentica

Intel sposta il focus sull'AI agentica: il coordinamento tra CPU e GPU diventa il fulcro. La mossa segnala una rilettura dell'hardware per workload che non si esauriscono in una singola inference, ma concatenano ragionamento, tool calling e memoria. ...

#Hardware #LLM On-Premise #DevOps
2026-09-22 • PyTorch Blog

Shopify ha chiuso il loop: gli errori di produzione diventano pesi del modello

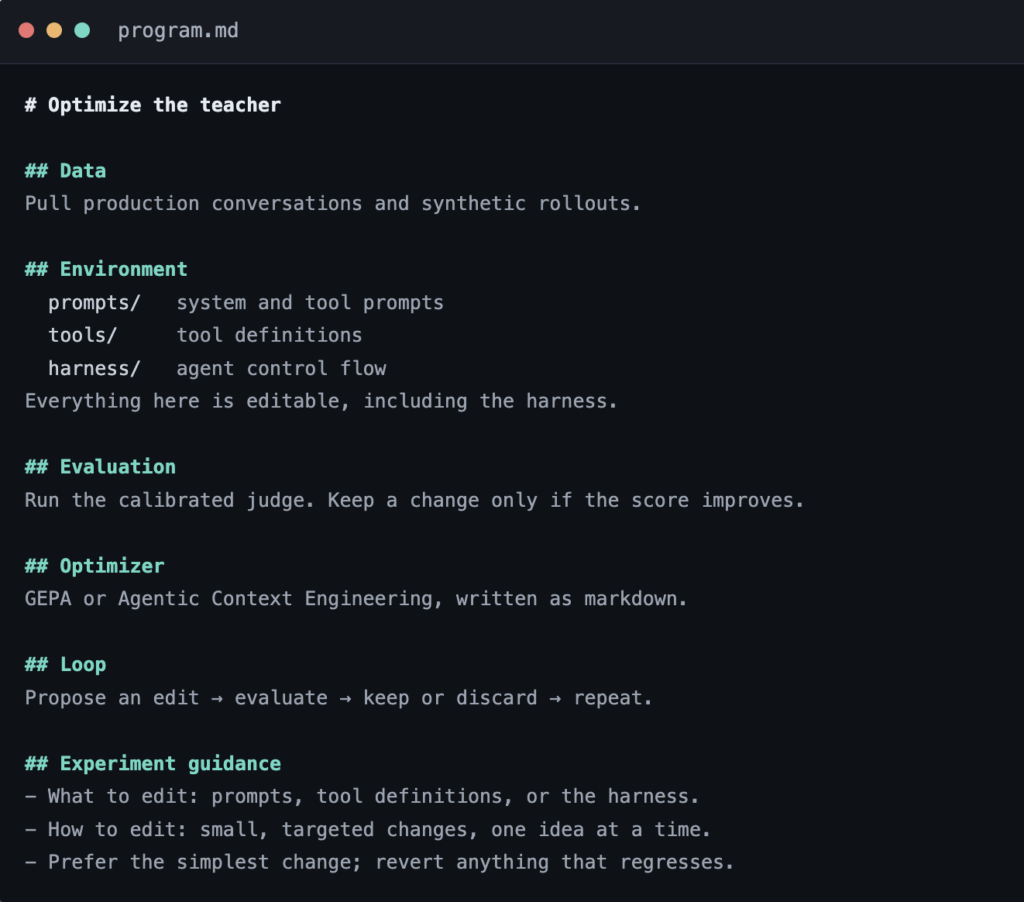
Shopify descrive un loop di apprendimento continuo basato su PyTorch e vLLM: gli errori di produzione diventano aggiornamenti dei pesi del modello. L'agente GraphQL supera la qualità del modello frontier e taglia il costo di serving del 96%, passando...

#Hardware #LLM On-Premise #Fine-Tuning
2026-09-21 • ArXiv cs.LG

BI-Bench e BI-Agent: il vero divario è nell'orchestrazione dei dati

La BI end-to-end rivela un limite strutturale dei LLM: sotto il 50% di accuratezza senza guida umana. Il guadagno vero arriva da architetture che orchestrano strumenti e da post-training su dati proprietari. Per chi valuta on-premise e self-hosted, i...

2026-09-21 • ArXiv cs.LG

BI-Bench e BI-Agent: il divario dei LLM nella BI end-to-end

Il benchmark BI-Bench, costruito su progetti reali e dashboard pubbliche, mostra che anche i LLM frontier restano sotto il 50% di accuratezza nella business intelligence end-to-end. BI-Agent, un agente tool-augmented che scompone ricerca, join e tras...

#Hardware #LLM On-Premise #Fine-Tuning
← Torna ai Topic